MEV数据集:面向长镜头生成的多事件视频资源

MEV数据集用事件级标注为长镜头多事件视频生成补上时间监督信号。
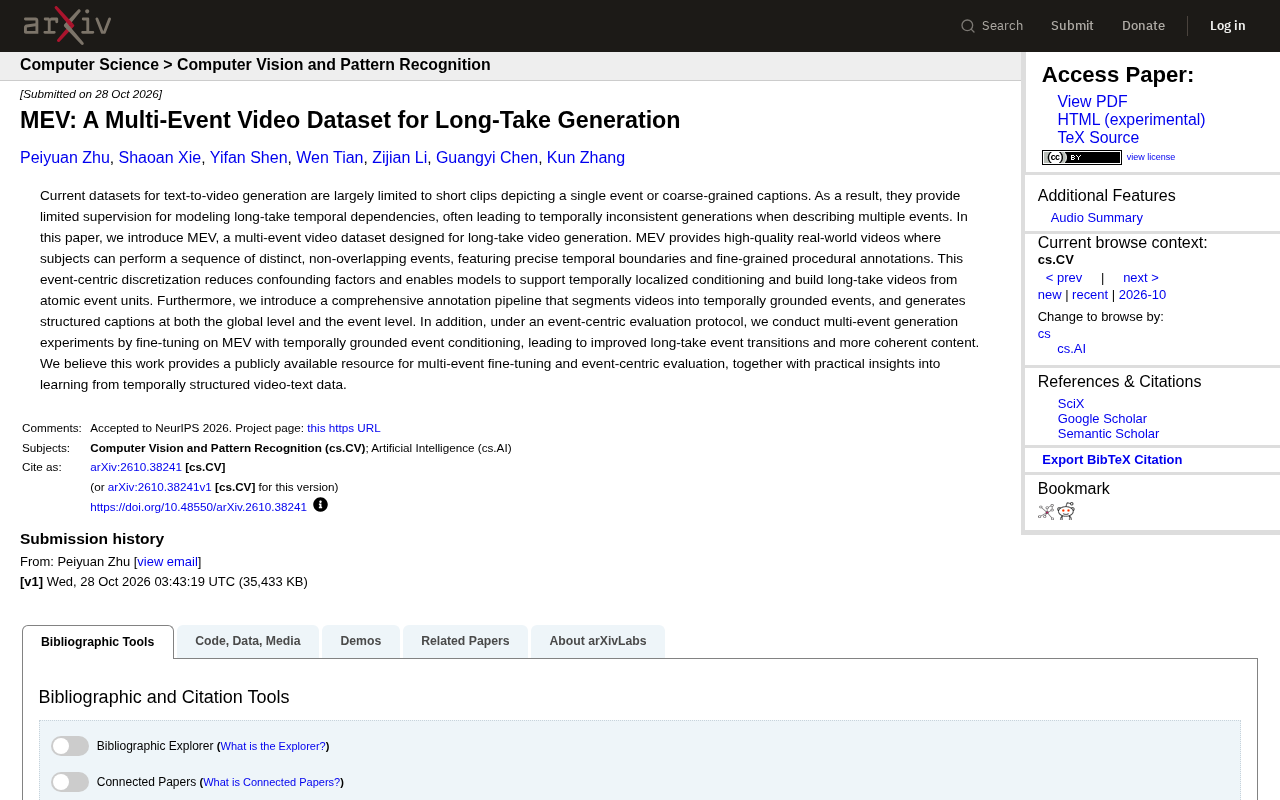
论文指出现有文生视频数据集多为单一事件短片段、文本描述粗粒度,导致模型缺乏长镜头时间依赖的监督,生成多事件提示时出现时序不一致。为此提出MEV数据集,将长视频拆解为互不重叠的原子事件单元,每个事件带精确时间边界和细粒度过程标注,标注流水线同时生成全局与事件级结构化描述。在事件中心评估协议下微调并施加时间条件,模型在事件过渡与内容连贯性上均有改善。作者将MEV定位为公开资源,支持多事件微调与事件中心评估,强调长镜头生成的关键在于补数据而非单纯堆模型。
文本到视频生成模型在短视频片段上已经能产出令人信服的结果,但当任务升级为“讲完一整段连续发生的事”时,时间一致性问题就会暴露出来。一篇题为《MEV: A Multi-Event Video Dataset for Long-Take Generation》的论文,正是针对这一瓶颈提出了数据集层面的解法。
现有视频数据集的监督盲区
论文指出现有文生视频数据集存在两个结构性局限:视频大多是描绘单一事件的短片段,文本描述也偏向粗粒度。这意味着模型在训练中很少见到“多个事件按时间顺序衔接”的样本,也就缺少对长镜头时间依赖关系的监督信号。
后果很直接——当提示词要求描述多个事件时,生成结果往往在时间上不一致。模型不知道事件A应该在事件B之前结束,也不清楚两个事件之间的边界在哪里。这不是模型容量的问题,而是训练数据没有教会它这件事。
文生视频模型的时间一致性指的是生成视频在帧与帧之间、事件与事件之间保持合理的时序逻辑:物体不会无故消失或变形,动作有连贯的因果推进,多个事件的先后顺序符合提示词的描述。早期模型(如基于扩散的视频生成方法)主要在数秒级短片段上优化单帧画质与短程运动自然度,时间一致性通常只覆盖几帧到十几帧的范围。当生成长度拉长到数十秒并包含多个语义事件时,误差会沿时间轴累积,表现为事件顺序错乱、事件边界模糊或内容漂移。这一问题并非单纯由参数量决定,而与训练分布中缺少长程时序监督密切相关。
MEV的核心设计:事件中心的时间离散化
MEV的构建思路是把长视频拆解为原子事件单元。数据集提供的是高质量真实视频,其中主体会执行一串彼此区分、互不重叠的事件,每个事件都有精确的时间边界和细粒度的过程性标注。
这种“以事件为中心”的离散化有两个好处。其一,它减少了混杂因素——模型不需要从一段模糊的连续画面中自行猜测事件切分点,监督信号直接给到了时间定位。其二,它让模型可以基于原子事件单元来组装长镜头视频,支持时间局部化的条件控制。
配套的标注流水线也值得关注:它把视频切分为有明确时间依据的事件,并生成全局层面和事件层面的结构化描述。这样一条视频就同时拥有了“整体讲了什么”和“每一段在做什么”两个粒度的文本监督。
原子事件单元是指一段视频中语义上不可再分、且与其他事件在时间上互不重叠的最小行为片段,例如“拿起杯子”“倒水”“放下杯子”可视为三个原子事件。将长视频离散化为原子事件的好处在于:每个单元内部语义相对单一,边界清晰,便于精确标注起止时间戳;同时多个原子事件可按时间顺序组合成更长的叙事。这种表示使时间结构从连续、模糊的画面流中显式剥离出来,成为可被模型直接学习的目标,也为时间局部化的条件控制(如只在指定时间段内生成某事件)提供了操作基础。
实验与评估:事件级协议下的长镜头生成
论文在事件中心的评估协议下进行了多事件生成实验,通过在MEV上微调并施加有时间依据的事件条件,模型在长镜头的事件过渡和内容连贯性上都有改善。
这里的方法论意义大于单次实验数字:评估不再只看单帧质量或短片段逼真度,而是把“事件能否按预期顺序衔接”作为衡量维度。作者将MEV定位为公开可用的资源,服务于多事件微调与事件中心评估,并提供从时间结构化视频-文本数据中学习的实践洞察。
事件级评估协议与传统的视频生成评估指标(如FVD、CLIP相似度)不同,它把“事件是否按提示词规定的顺序出现”“每个事件是否落在预期的时间区间内”“事件过渡是否自然”作为独立的衡量维度。这类协议通常需要借助事件检测或时间定位模型,将生成视频切分为候选事件段,再与参考事件序列做匹配和打分。其方法论价值在于把评估重心从单帧画质转向时序结构正确性,从而能暴露短片段指标无法反映的长镜头失败模式。
对视频生成研究的意义
MEV的价值在于把长镜头生成问题从“堆模型”转向“补数据”。事件级标注让时间结构成为可学习的对象,而不是隐式期望模型自己领悟的规律。对于需要生成教程、叙事短片或多步骤操作演示的应用场景,这类监督信号可能比单纯扩大数据规模更关键。数据集与标注流水线的公开,也为后续在时间结构化数据上的研究提供了可复用的起点。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。