免费午餐:粒子解码如何零成本量化LLM推理不确定性

利用SMC解码的归一化常数零成本提取序列级Rényi熵,实现选择性预测与自适应计算。
本文提出一种“免费午餐”式的不确定性量化方法:利用序列蒙特卡洛(SMC)解码过程中已有的归一化常数,直接读出序列级Rényi熵(SRE),无需任何额外计算。作者通过Rényi链式法则将序列级熵分解为逐步熵家族,并发现1/2阶SRE在13个测试设置中的10个成为最佳零成本选择性预测信号,在MATH500上AUROC比对数概率高0.022-0.044。基于此,作者设计了8粒子探针和两遍自适应策略,在MATH500上平均减少34.2%的粒子使用量,同时匹配64粒子解码的准确率。该方法概念优雅,将不确定性量化从额外开销转变为解码副产品,为LLM推理服务提供了实用的优化手段。
大型语言模型(LLM)在推理时往往“不知道自己不知道”,这给选择性预测和自适应计算带来了根本挑战。现有方法要么依赖局部信号(如平均token熵、对数概率),要么需要多次额外采样(如自洽性),前者视野狭窄,后者代价高昂。一篇来自arXiv的论文《Free Lunch Uncertainty: Sequence-Level Rényi Entropy from Particle Decoding for Adaptive LLM Reasoning》提出了一种“免费午餐”式的解决方案:利用序列蒙特卡洛(SMC)解码过程中已有的归一化常数,直接读出序列级的Rényi熵(SRE),无需任何边际成本。
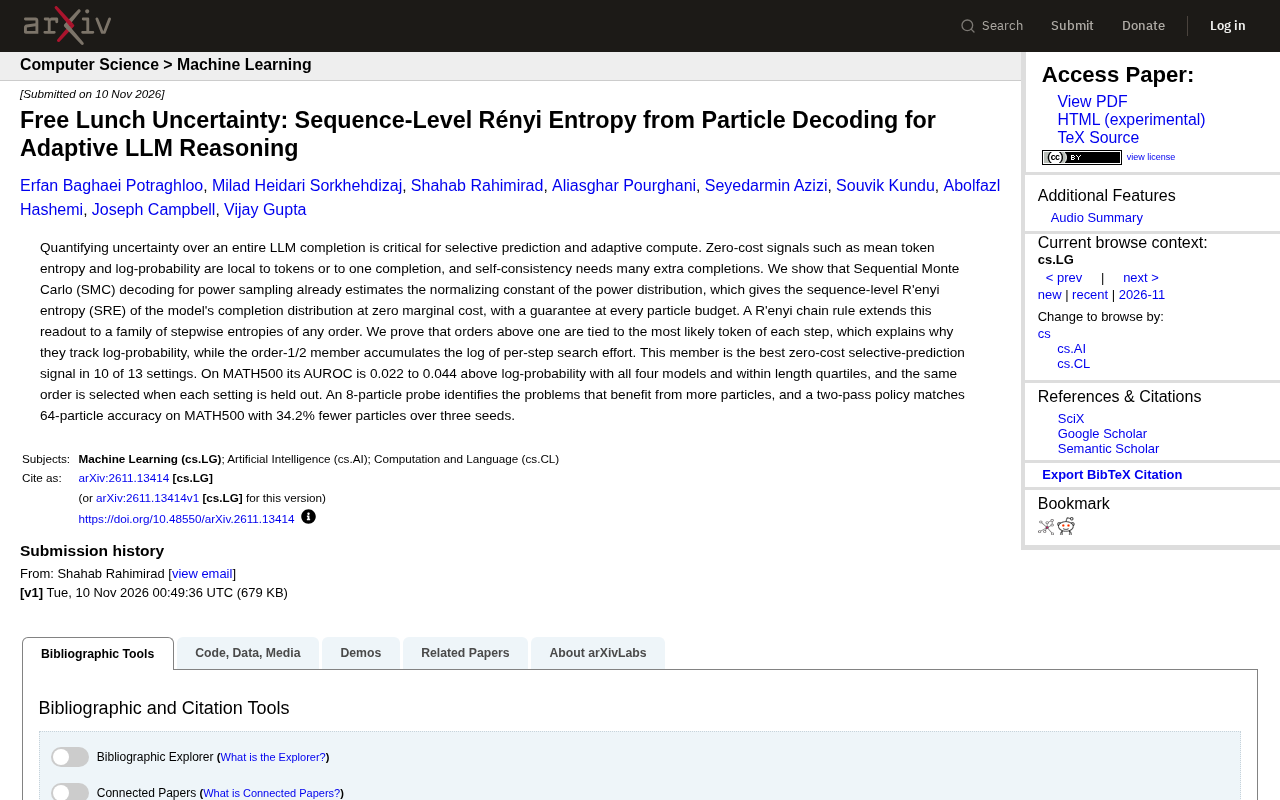
零成本不确定性的来源:SMC解码的副产品
SMC解码(特别是用于power sampling的版本)本身会估计power分布的归一化常数。这个常数恰好编码了模型完成分布的序列级Rényi熵。换句话说,只要你在用SMC做解码,序列级不确定性就已经被计算出来了,只是之前没人把它读出来。作者证明,在任意粒子预算下,这个读出都是精确的,不存在近似误差。这与其他需要额外前向传播的方法形成鲜明对比——那些方法的“不确定性”是额外成本,而SRE是解码过程的免费副产品。
序列蒙特卡洛(Sequential Monte Carlo, SMC)是一类通过维护一组加权粒子来近似复杂概率分布的采样方法。在LLM解码中,粒子即部分生成的序列,每个粒子携带一个权重,权重根据模型对已生成token的概率进行更新。SMC的核心优势在于,它同时提供了对目标分布(此处为power分布)的归一化常数的估计。这个归一化常数在数学上等于未归一化概率函数在所有可能序列上的积分(或求和),其对数与Rényi熵直接相关。因此,只要运行SMC解码,归一化常数就是粒子权重更新的自然副产品,无需额外计算。
power sampling是一种通过温度参数调整原始模型分布的技术,常用于控制生成多样性与质量。SMC用于power sampling时,目标分布为p(x)^β(β为逆温度),其归一化常数Z(β) = Σ_x p(x)^β。Rényi熵的阶数α与β通过α = 1/(1-β)关联(或类似变换,取决于定义)。因此,从SMC得到的Z(β)可以直接转换为序列级Rényi熵。
Rényi链式法则:从单一熵到逐步熵家族
单一熵值不足以刻画生成过程。作者通过一个Rényi链式法则,将序列级熵分解为任意阶的逐步熵。这类似于信息论中的熵链式法则,但针对的是Rényi熵家族。阶数α是一个关键参数:作者证明,当α>1时,逐步熵与每一步的最可能token紧密相关,这解释了为什么这些阶数会“跟踪”对数概率——它们本质上在度量模型对每步选择的自信程度。而α=1/2的成员则不同,它累积的是每步搜索努力的日志。这种区分使得不同阶数适用于不同场景。
Rényi熵是香农熵的一种推广,由Alfréd Rényi于1961年提出,定义为H_α(X) = (1/(1-α)) log Σ_x p(x)^α,其中α ≥ 0且α ≠ 1。当α→1时,Rényi熵退化为香农熵;当α=0时,它为最大熵(log |X|);当α=∞时,它为最小熵(-log max p(x))。不同阶数α捕捉分布的不同特征:低阶(α<1)对尾部事件更敏感,高阶(α>1)对高概率区域更敏感。在LLM解码中,逐步Rényi熵度量每一步生成时模型的不确定性,而序列级Rényi熵则反映整个序列的联合不确定性。
Rényi链式法则将序列级Rényi熵分解为各步条件Rényi熵之和,但需注意Rényi熵的链式法则与香农熵不同,通常需要引入额外的校正项或采用特定定义。论文中采用的分解允许从序列级熵推导出每一步的熵贡献,从而获得逐步熵家族。这种分解的实用性在于,它使得从单一序列级信号中提取细粒度的逐步不确定性成为可能,为自适应计算提供了更丰富的决策依据。
1/2阶:最佳零成本选择性预测信号
在13个测试设置中,1/2阶SRE在10个设置中成为最佳零成本选择性预测信号。在MATH500数据集上,其AUROC比对数概率高出0.022到0.044,覆盖全部四个模型,并且在按长度四分位分组后依然成立。更关键的是,当每个设置被轮流留出时,1/2阶仍然被选中,说明这个选择不是过拟合。这意味着在不需要任何额外计算的情况下,1/2阶SRE就能比传统的对数概率更好地识别出哪些回答更可能正确——对于选择性预测(即决定何时信任模型输出)来说,这是一个即插即用的改进。
选择性预测(selective prediction)是指模型在不确定时选择弃权(abstain),仅对高置信度的样本进行预测,以在覆盖率与准确率之间取得权衡。评估选择性预测性能的常用指标是AUROC(Area Under the Receiver Operating Characteristic curve),它衡量不确定性信号区分正确与错误预测的能力:AUROC越高,说明信号越能有效识别出可能错误的回答。对数概率(log-probability)是传统的基线不确定性信号,即模型对生成序列的平均token对数概率。
1/2阶Rényi熵(α=1/2)在Rényi熵家族中具有特殊性质:它对应于Hellinger距离相关的熵,对分布的尾部较为敏感,能够捕捉模型在生成过程中的搜索努力程度。在选择性预测中,1/2阶SRE的AUROC比对数概率高出0.022-0.044,这一提升虽然绝对值不大,但在零额外计算成本的约束下具有实际意义。此外,按长度四分位分组后依然成立,说明该信号不受序列长度混杂因素的影响。
自适应粒子预算:8粒子探针与两遍策略
不确定性信号的价值最终体现在自适应计算上。作者设计了一个8粒子探针:先用少量粒子运行,根据SRE信号判断哪些问题需要更多粒子。然后采用两遍策略:第一遍用8粒子探针识别“困难”问题,第二遍仅对这些困难问题增加粒子。在MATH500上,这种两遍策略在三个随机种子下平均减少了34.2%的粒子使用量,同时匹配64粒子解码的准确率。这意味着在保持精度的前提下,计算成本显著降低。对于部署LLM推理服务的团队来说,这是一个直接可用的优化手段。
自适应计算(adaptive computation)是指根据输入难度动态调整计算资源分配的策略。在LLM推理中,这通常表现为对简单问题使用较少的采样或较短的解码步数,对困难问题投入更多资源。粒子预算(particle budget)是SMC解码中的关键超参数:粒子数越多,对目标分布的近似越精确,但计算成本也线性增加。
8粒子探针是一种轻量级预跑策略:先用8个粒子运行SMC解码,利用得到的序列级Rényi熵信号评估问题难度。两遍策略则在此基础上,第一遍用8粒子探针识别出“困难”问题(即SRE较高的样本),第二遍仅对这些困难问题增加粒子数(如增至64粒子),而对简单问题保持低预算。这种策略在MATH500上平均减少34.2%的粒子使用量,同时匹配64粒子解码的准确率,表明自适应分配可以在不损失性能的情况下显著降低计算开销。
多源视角与局限
据论文作者和社区讨论(如rss来源的摘要),这项工作将不确定性量化从“额外开销”转变为“解码副产品”,概念上优雅且实用。不过,当前验证主要集中在数学推理任务(MATH500)和四个模型上,对于开放域生成、长文本创作等场景,1/2阶SRE是否依然领先还有待检验。另外,SMC解码本身需要粒子管理,虽然论文声称零边际成本,但实际实现中粒子间的重采样和权重计算仍有工程开销。不过,考虑到它同时提供了不确定性信号和自适应计算策略,整体收益仍然可观。
对于研究者而言,Rényi链式法则打开了一个新方向:通过不同阶数提取不同语义的不确定性。对于工程师,8粒子探针和两遍策略可以直接集成到现有推理管线中,用更少的粒子达到相同精度。免费午餐或许不是完全免费,但确实便宜到值得一试。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
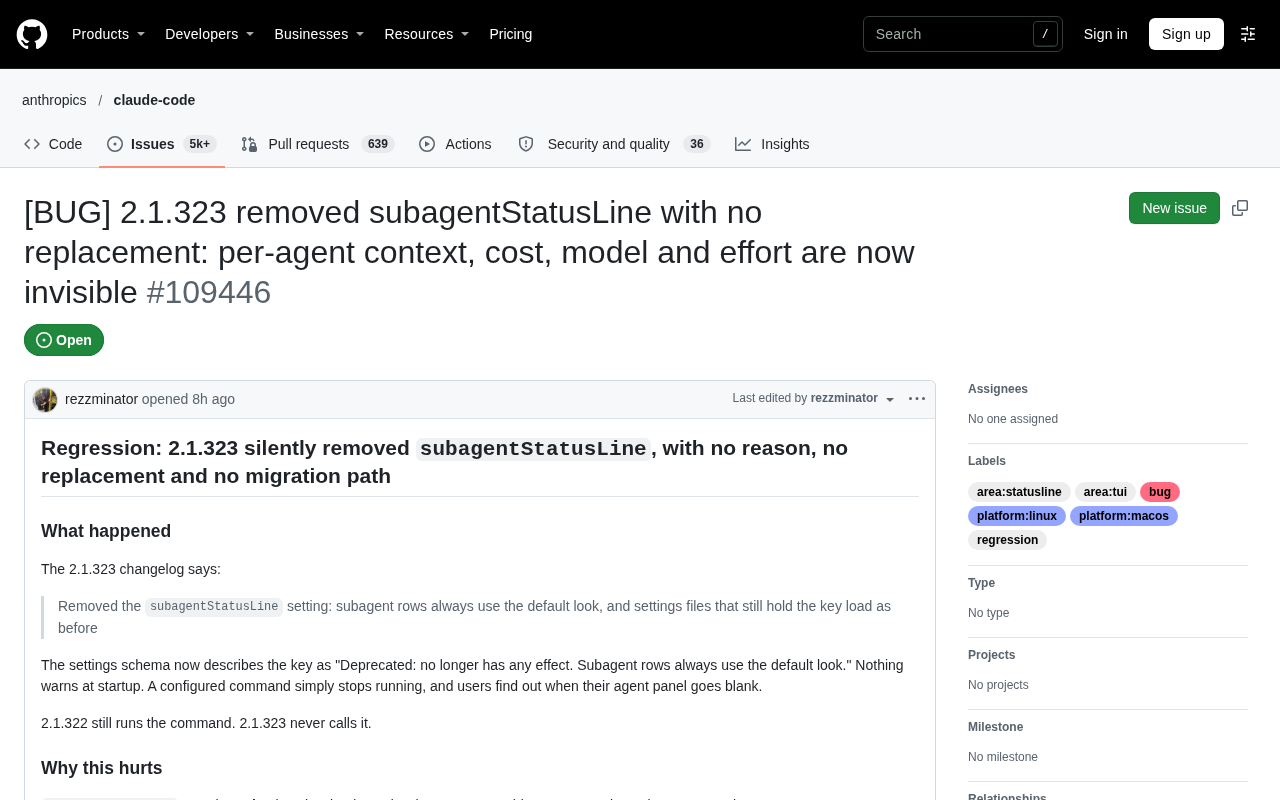
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
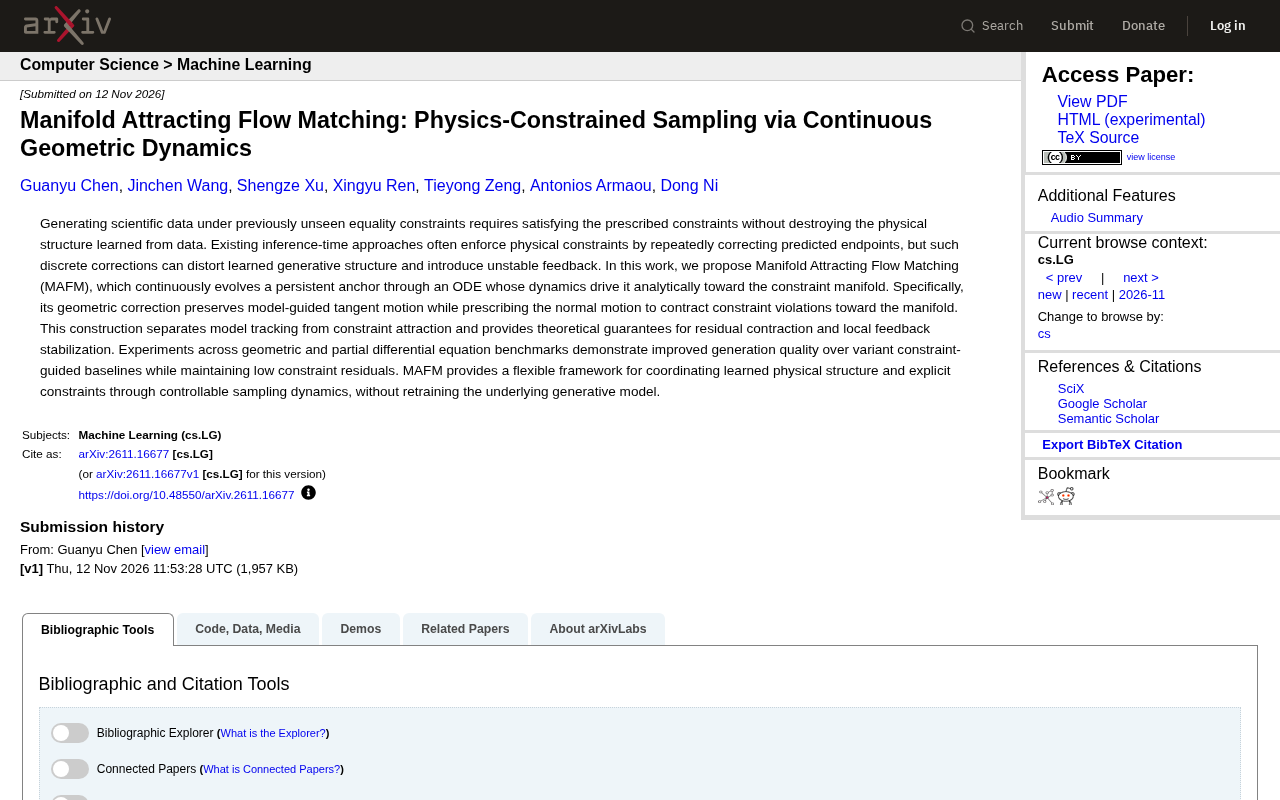
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。