MiniMax H3实战:REF2VA与FL2VA融合工作流搭建指南
MiniMax H3的两种模式之争:REF2VA vs FL2VA
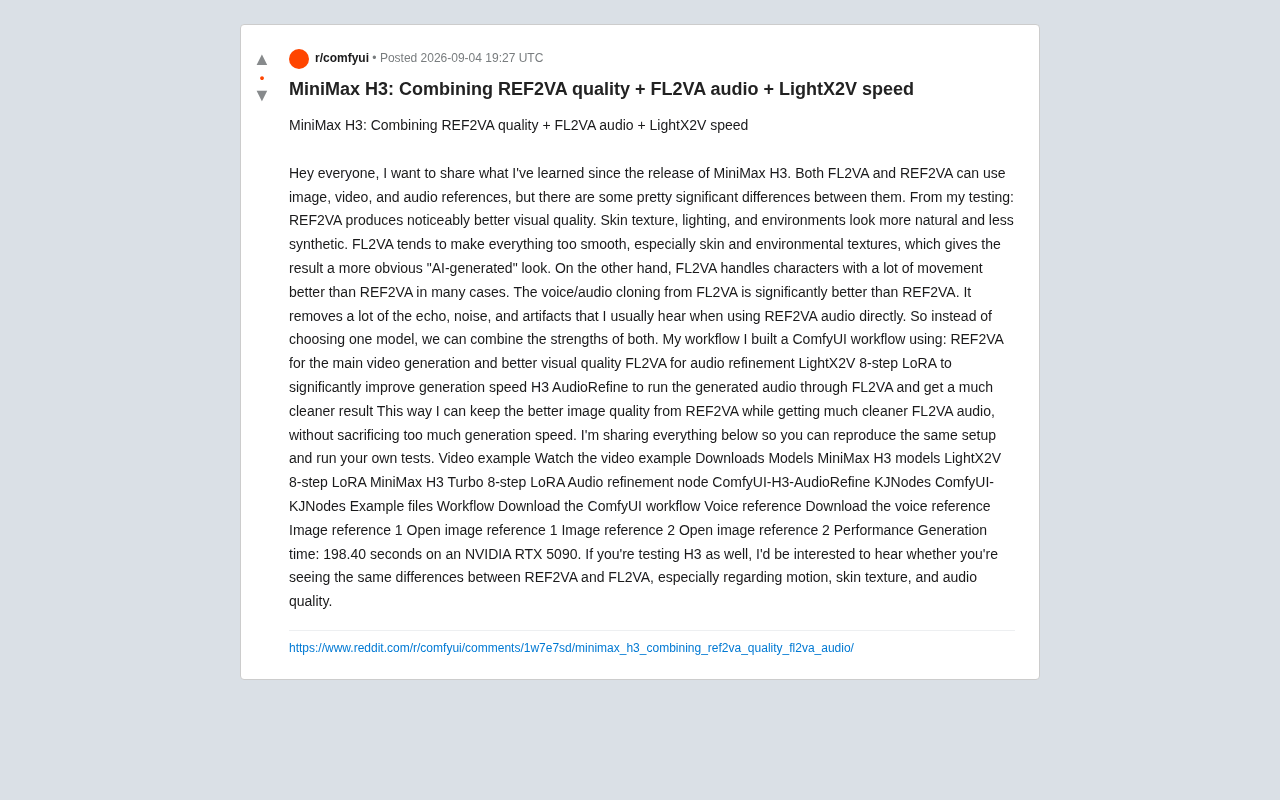
自MiniMax H3发布以来,社区中围绕其两大生成模式——REF2VA与FL2VA——的讨论一直没有停歇。REF2VA(Reference-to-Video-Audio)和FL2VA(Flow-to-Video-Audio)是MiniMax H3多模态生成模型的两种核心推理模式。REF2VA基于参考图像驱动生成,通过提取参考帧的视觉特征(如面部结构、纹理细节、光照信息)来引导视频合成,本质上更接近于image-conditioned generation范式。Image-conditioned generation是条件生成模型的一个重要分支,指以一张或多张参考图像作为生成条件,引导模型输出与参考图像在某些维度上保持一致的内容。与纯文本驱动(text-to-image/video)不同,图像条件生成能够携带更丰富的底层视觉信息——包括具体的几何结构、材质纹理、色彩分布和光照环境。在视频生成领域,这种范式的典型应用包括IP-Adapter、Reference-Only ControlNet以及最近的视频角色一致性技术。REF2VA正是利用这一范式的优势,通过编码器提取参考帧的深层视觉特征并注入到扩散模型的去噪过程中,从而在时间维度上保持角色外观和场景风格的一致性。
FL2VA则基于光流(Optical Flow)估计来驱动生成,更侧重于运动轨迹的建模与传播,通过预测帧间像素位移来实现更连贯的动态效果。两者的架构差异直接决定了它们在视觉保真度和运动一致性上的不同表现。
这两种模式都支持图像、视频和音频引用作为输入,但在实际使用中,它们各自展现出的优势与短板却相当明显。
一位Reddit用户在深入测试后分享了他的发现,并给出了一套颇具参考价值的融合工作流方案。核心思路很简单却很有洞见:与其在两个模型之间二选一,不如把两者的长处结合起来,取长补短。
REF2VA与FL2VA详细对比:三个关键维度
视觉质量:REF2VA更胜一筹
根据该用户的实测反馈,REF2VA在视觉质量上有着明显优势。无论是皮肤纹理、光照效果还是环境细节,REF2VA生成的画面都显得更加自然,少了那种典型的"合成感"。这与REF2VA基于参考图像特征提取的架构设计密切相关——它能够更精确地保留原始参考帧中的高频纹理信息和光照分布,从而在生成过程中重建出更具真实感的视觉细节。
相比之下,FL2VA的一个突出问题是画面"过于平滑"——尤其是皮肤和环境纹理会被过度处理,导致最终结果带有更明显的"AI生成"痕迹。这种过平滑现象在深度学习领域被称为"模糊化"(blurriness),通常源于模型在优化过程中倾向于生成各像素的均值预测,而非保留锐利的纹理边缘。从技术角度看,这与损失函数的设计有关:使用L2(均方误差)损失训练的生成模型天然倾向于输出条件分布的均值,而真实的视觉纹理往往具有高频、随机的特性。感知损失(Perceptual Loss)、对抗损失(Adversarial Loss)和频率域损失等技术可以缓解这一问题,但当模型需要同时兼顾运动建模时,纹理细节上的妥协往往在所难免。对于追求真实感和电影质感的创作者来说,这种平滑化往往是不受欢迎的。
运动表现:FL2VA在动态场景中更稳定
然而,故事并没有那么简单。在处理大幅度运动的角色时,FL2VA在很多情况下反而表现得比REF2VA更好。这与FL2VA基于光流估计的核心架构直接相关——光流(Optical Flow)是计算机视觉中用于描述相邻帧之间像素运动的经典技术,它通过建模每个像素在时间维度上的位移向量来实现运动跟踪。
光流的概念最早可追溯到1981年Horn和Schunck提出的经典变分方法,以及同期的Lucas-Kanade方法。传统光流估计基于亮度恒常性假设,即相邻帧中同一物体点的亮度不变。随着深度学习的发展,FlowNet(2015)、RAFT(2020)等基于神经网络的光流估计方法大幅提升了精度和鲁棒性。在视频生成中引入光流作为中间表征,最早可见于vid2vid等工作,它将光流作为运动先验注入生成过程,帮助模型理解"物体应该如何移动"而非仅仅关注"物体应该长什么样"。FL2VA对光流技术的深度整合,代表了视频生成领域中一种"运动优先"的设计哲学。
FL2VA将这种运动建模能力深度整合到视频生成过程中,使其在处理快速运动、大幅度肢体动作和复杂镜头运动时,能够维持更好的时序一致性,减少帧间闪烁和运动失真。
这意味着,如果你的视频包含大量动态动作,FL2VA可能会带来更连贯、更稳定的运动效果。
这一点提醒我们,模型的优劣并不是绝对的,而是取决于具体的应用场景:
- 静态或慢节奏画面 → 适合REF2VA
- 剧烈运动场景 → 更依赖FL2VA的处理能力
音频克隆:FL2VA显著领先
在音频与语音克隆方面,FL2VA的表现明显优于REF2VA。用户指出,直接使用REF2VA处理音频时,常常会听到回声、噪音和各种伪影,而FL2VA能够有效去除这些问题,输出更加干净纯净的音频结果。
音频伪影(Audio Artifacts)是AI音频生成中常见的质量问题,包括回声(Echo)、金属质感的噪音、频率截断和谐波失真等。这些伪影通常源于模型在频域重建时的不完善——特别是在高频区域,生成模型往往难以精确还原人声的自然泛音结构。在技术实现上,AI音频生成通常采用梅尔频谱图(Mel Spectrogram)作为中间表示,模型先生成频谱图再通过声码器(Vocoder,如HiFi-GAN、BigVGAN)转换为波形。频谱图到波形转换过程中的相位重建是音频伪影的重要来源——因为梅尔频谱图通常只保留了幅度信息而丢弃了相位信息,声码器需要从零推断相位,这个过程的不完美会导致金属感噪音和频率失真。
语音克隆(Voice Cloning)技术通过提取说话人的声纹特征(如音色、语调模式、韵律节奏),将这些特征迁移到新的语音内容上。在多模态视频生成场景中,音频克隆需要与角色的口型动作、情感表达保持同步,这对音频质量提出了更高要求。FL2VA在音频处理上的优势可能源于其对时序信号更强的建模能力,使其在重建音频波形时能更好地保持信号的连续性和纯净度。
对于需要语音克隆或角色配音的项目而言,这个差异尤为关键——嘈杂、带回声的音频会大幅拉低整体成片质量。
融合工作流搭建:在ComfyUI中取两者之长
ComfyUI简介
ComfyUI是一个基于节点的开源图形化工作流编辑器,专为Stable Diffusion及其他AI生成模型设计。与传统的WebUI(如Automatic1111的Stable Diffusion WebUI)不同,ComfyUI采用有向无环图(DAG)的方式组织生成流程,每个节点代表一个独立的计算步骤(如模型加载、采样、VAE解码等),用户通过连线将节点串联成完整的生成管线。
有向无环图在工作流编排领域有着悠久的应用历史——Apache Airflow、Prefect等数据工程工具同样基于DAG来管理任务依赖关系。在ComfyUI中,每个节点的输入和输出通过类型匹配的连线相连,系统会自动根据拓扑排序确定执行顺序,确保上游节点的输出在下游节点需要时已经就绪。这种架构的另一个重要优势是支持中间结果缓存——当用户修改工作流中的某个节点参数时,只有该节点及其下游节点需要重新计算,上游已完成的计算结果可以复用,这在迭代调试复杂生成管线时能节省大量时间。
这种架构天然支持模块化设计,用户可以自由插入自定义节点、LoRA、ControlNet等扩展组件,极大降低了复杂工作流的搭建门槛。ComfyUI社区已发展出数千个自定义节点包,涵盖图像、视频、音频等多个领域,正是这种生态活力使得像本文所述的多模型融合工作流成为可能。
核心设计思路
基于上述测试结论,这位用户在ComfyUI中搭建了一套融合工作流,巧妙地将两个模型的优势结合起来:
- REF2VA:负责主视频生成,确保更优的视觉质量
- FL2VA:负责音频精修,输出更干净的声音
- LightX2V 8步 LoRA:显著提升生成速度
- H3 AudioRefine:将生成的音频通过FL2VA处理,获得更纯净的结果
其中,LightX2V 8步LoRA和Turbo 8步LoRA属于蒸馏加速型LoRA。LoRA(Low-Rank Adaptation)最初是微软研究院在2021年提出的一种参数高效微调技术,通过在预训练模型的权重矩阵中注入低秩分解矩阵来实现特定任务的适配,而无需重新训练整个模型。其核心数学原理是将权重更新矩阵ΔW分解为两个低秩矩阵的乘积:ΔW = BA,其中B的维度为d×r,A的维度为r×d,秩r远小于原始维度d。这意味着需要训练的参数量从d²级别降低到2dr级别,通常只占原始模型参数的0.1%-1%。
在此场景中,这些LoRA通过将原本需要数十步采样才能完成的去噪过程压缩到仅8个推理步骤,从而大幅缩短生成时间。这种加速通常基于渐进蒸馏(Progressive Distillation)或一致性蒸馏(Consistency Distillation)方法训练。渐进蒸馏由Salimans和Ho在2022年提出,其核心思想是迭代式地将教师模型的两步推理压缩为学生模型的一步推理——每轮蒸馏将所需步数减半,经过多轮蒸馏即可将数十步压缩到个位数。一致性蒸馏则源自Song等人2023年提出的一致性模型(Consistency Models),它强制模型在概率流ODE的同一轨迹上的任意两点都映射到相同的终点,从而实现单步或少步生成。这两种方法各有取舍:渐进蒸馏通常能更好地保留原始模型的多样性,而一致性蒸馏在极少步(1-4步)场景下往往表现更优。LightX2V 8步LoRA很可能结合了这些技术的变体,在8步这个平衡点上实现了速度与质量的良好折中。"8步"意味着模型仅需8次前向传播即可完成采样,相比常规25-50步推理可节省约70%-85%的计算量。
通过这种组合,创作者既能保留REF2VA带来的高画质,又能享受FL2VA的干净音频,同时不会在生成速度上做出太多妥协。
工作流所需组件清单
完整的工作流依赖以下几个组件:
- MiniMax H3 模型(主生成模型)
- LightX2V 8步 LoRA 与 MiniMax H3 Turbo 8步 LoRA(加速模块)
- ComfyUI-H3-AudioRefine(音频精修节点)
- ComfyUI-KJNodes(辅助节点集)
这种模块化的设计正是ComfyUI生态的魅力所在——每个环节都可以独立替换和优化,创作者可以根据自己的需求灵活调整。
性能表现与硬件要求
在性能方面,该工作流在一块 NVIDIA RTX 5090 显卡上完成一次生成大约需要 198.40秒(约3分20秒)。
NVIDIA RTX 5090是基于Blackwell架构的旗舰消费级显卡,配备32GB GDDR7显存和超过21,000个CUDA核心。对于AI视频生成任务而言,显存容量是最关键的瓶颈因素之一——MiniMax H3作为多模态大模型,其参数量和中间激活值在推理时需要占用大量显存。32GB显存使得RTX 5090能够在不进行模型量化或分片的前提下完整加载H3模型及其附属LoRA权重。
相比之下,拥有16GB显存的RTX 4080或24GB的RTX 4090在运行相同工作流时可能需要依赖FP8量化、模型卸载(offloading)等技术手段,这会进一步增加生成耗时。FP8(8-bit浮点数)量化将模型权重从标准的FP16或FP32压缩到8位表示,理论上可将显存占用减半甚至更多,但代价是可能引入量化误差,导致生成质量的细微下降。NVIDIA从Hopper架构(H100)开始原生支持FP8计算,Ada Lovelace架构(RTX 40系列)也提供了部分支持。模型卸载则是将暂时不参与计算的模型层从GPU显存转移到CPU内存甚至磁盘上,需要时再加载回来。这种方法虽然能突破显存限制,但频繁的PCIe总线数据搬运会造成严重的I/O瓶颈——在实际测试中,启用模型卸载后的生成速度可能降低2-5倍。在ComfyUI中,这些技术已经有成熟的节点支持,用户可以根据自己的硬件条件灵活选择量化精度和卸载策略。
考虑到这套流程同时整合了两个模型的处理以及音频精修,加上LightX2V 8步LoRA的加速,这个耗时可以说是相当合理的。不过需要注意的是,RTX 5090属于顶级消费级显卡,普通用户若使用较低端的硬件,生成时间可能会显著增加。
这也反映出当前AI视频生成领域的一个现实:高质量输出往往伴随着不小的算力门槛。对于希望复现这套工作流的用户来说,充足的显存和强劲的GPU仍然是绕不开的前提。当前AI视频生成领域对显存的需求正快速增长,在专业生产环境中,48GB及以上显存的专业卡(如NVIDIA A6000、H100)仍然是更理想的选择。而随着模型量化技术(如GGUF格式、AWQ量化)的不断成熟和推理框架(如TensorRT、vLLM)的持续优化,未来中端显卡运行这类复杂工作流的可行性有望逐步提升。
组合思维:比选择单一模型更重要
这个案例最值得借鉴的,其实不是某个具体的参数或节点,而是背后的组合思维。在AI工具日益丰富的今天,单一模型很难在所有维度上都做到最优。与其纠结于"哪个模型更好",不如深入理解每个工具的强项与短板,然后有针对性地将它们编排在一起。
这种思维方式在软件工程中有一个经典的类比——"Unix哲学":让每个工具只做一件事并把它做好,然后通过管道将不同工具的输出串联起来完成复杂任务。这一哲学由Ken Thompson和Dennis Ritchie在1970年代开发Unix操作系统时确立,其核心原则包括:(1)程序应该只做一件事并做好它;(2)程序的输出应该能成为另一个程序的输入;(3)尽早尝试设计和构建软件,即便是操作系统也不例外。在现代AI工作流中,这种哲学的价值被重新发现——一个专注于视觉质量的模型与一个擅长音频处理的模型通过管道串联,往往能产出比任何单一全能模型更好的结果。这也解释了为什么ComfyUI在AI创作社区中如此受欢迎:它的节点化架构就是Unix管道思想在视觉生成领域的现代化身。
ComfyUI的节点化工作流设计恰好与这一理念不谋而合,使得用户能够像搭积木一样组合不同的模型、LoRA和后处理模块,构建出最适合自己需求的生成管线。
作者也在帖子末尾向社区发起了讨论,希望其他测试者能分享自己在运动表现、皮肤纹理和音频质量方面的观察。这种开放共享、交叉验证的社区精神,正是开源AI工具快速迭代的重要推动力。在AI生成领域,社区驱动的基准测试和经验分享往往比官方发布的性能指标更具实践参考价值——因为官方评测通常在理想条件下进行,而社区用户的多样化使用场景能更全面地暴露模型的边界情况和实际表现。
如果你也在使用MiniMax H3,不妨亲自跑一遍这套工作流,看看是否能复现同样的效果——或者发现属于你自己的最优组合。
核心要点
核心要点
相关推荐
Claude Code与Codex企业级实战:AI工程化编程如何搞定复杂项目
从氛围编程到AI工程化编程,本文解析Claude Code与Codex企业级项目实战:三种开发模式递进、国产大模型选型、SuperPower插件流程,以及Open Router聚合平台背后的AI行业盈利逻辑。
开源桌面端CC-HAHA上手:让AI自动操作你的电脑
开源桌面客户端 CC-HAHA 新增 computer use 电脑操控功能,让 AI 通过虚拟鼠标自动操作电脑。本文详解三步配置流程、实际效果演示,并分析不同模型在操作电脑能力上的差异与局限。
Claude Code桌面版实操:中文汉化+免登录+接入DeepSeek全攻略
手把手教你安装 Claude Code 桌面版,实现免账号使用、中文汉化,并通过 CC Switch 接入国产模型 DeepSeek,还包含自定义 Skill 导入的完整实操步骤,帮你低成本跑通 Claude Code 工作流。