MiniMax本地视频生成实测:RTX 5090跑通全流程详解

一位发烧友用RTX 5090本地运行剪枝量化版MiniMax视频模型,17分钟生成多参考AI视频,展示本地视频生成的技术现状与门槛。
本文分析了一位Reddit用户分享的本地AI视频生成实验:在RTX 5090工作站上,借助剪枝、int8量化和Turbo 4步LoRA加速,运行MiniMax ref2va模型,以6张图像参考和3段音频参考为输入,生成1344×768分辨率视频,耗时约17分钟。文章逐项拆解了技术参数的含义——剪枝+量化解决"跑得起"的问题,少步数蒸馏LoRA解决"跑得快"的问题——同时指出顶级消费级硬件依然是不可绕过的门槛。这个案例的深层意义在于:模型优化技术正成为AI能力下沉到消费端的核心杠杆,当普通人能将本地视频生成视为"爱好"时,整个技术栈已跨越了关键的成熟度节点。
一场关于本地AI视频生成的实验
在AI视频生成领域,云端服务如Runway、Pixverse、可灵等一直占据主流。但随着开源模型和消费级显卡性能的提升,越来越多的爱好者开始尝试在自己的设备上完成整条创作流水线。近期一位Reddit用户分享了他的"新爱好"——利用本地部署的MiniMax视频生成模型,配合参数优化和加速方案,在自己的工作站上生成AI视频。
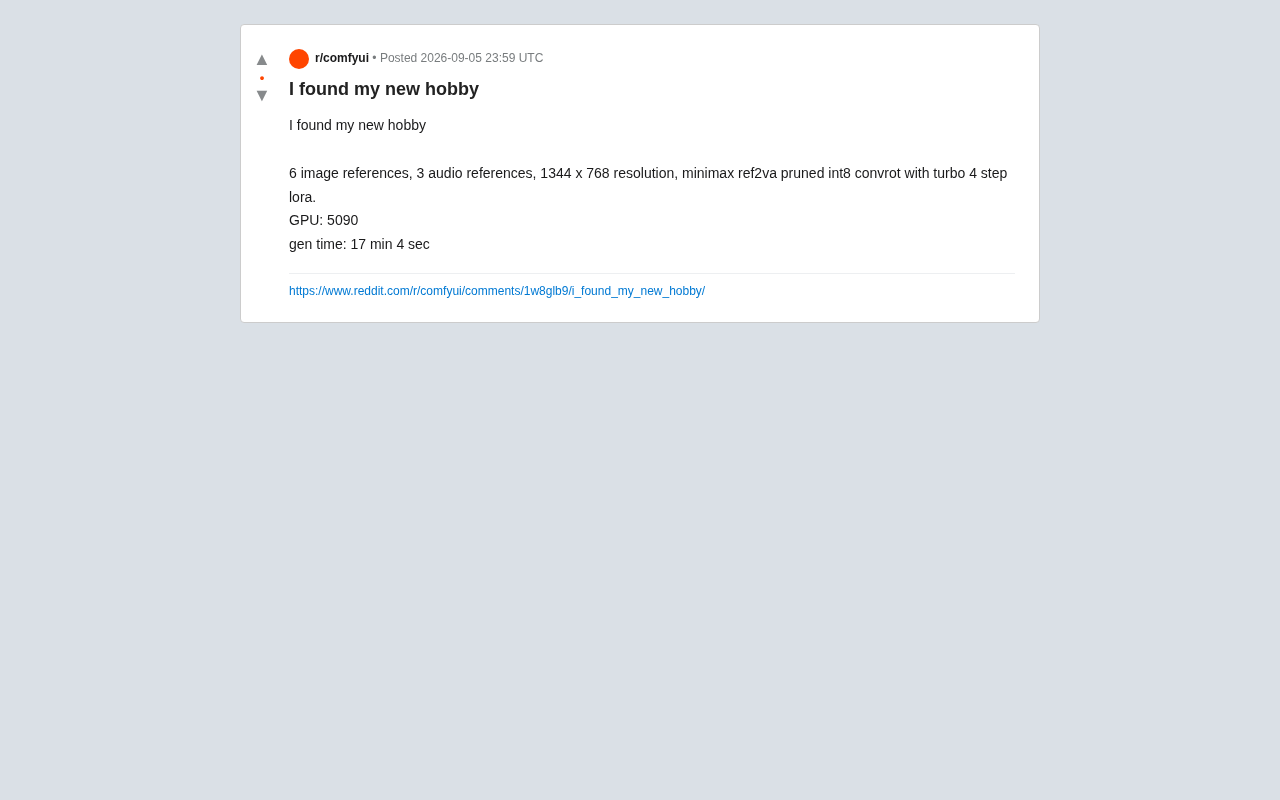
这条帖子看似简单,实则透露了大量关于当前本地AI视频生成技术栈的关键信息。从硬件配置到模型量化,再到加速LoRA的使用,每一个细节都反映了这个领域正在快速演进的技术生态。
MiniMax本地视频生成的技术参数拆解
从作者提供的信息来看,这次生成任务的配置相当讲究,值得逐项分析。
输入素材与输出分辨率
作者使用了 6张图像参考(image references) 和 3段音频参考(audio references),输出分辨率为 1344 × 768。多图参考意味着这套流程支持基于多张参考图来引导视频生成,从而更好地保持角色、场景的一致性——这正是当前AI视频最难攻克的痛点之一。而引入音频参考,则暗示该工作流可能涉及音画同步或口型驱动(lip-sync)类的应用场景。
1344 × 768 的分辨率接近16:9的宽屏比例,属于社交平台友好的中等画质,既能保证一定的观感,又不会让本地显存和生成时间彻底失控。
模型量化与剪枝方案详解
核心信息在于这一串描述:minimax ref2va pruned int8 convrot with turbo 4 step lora。拆开来看:
- MiniMax ref2va:基于MiniMax的"参考图转视频/音频"(reference-to-video/audio)模型分支;
- pruned(剪枝):模型经过剪枝处理,去除冗余参数以降低显存占用和计算量;
- int8:采用8位整数量化,进一步压缩模型体积、加快推理速度,代价是可能损失少量精度;
- turbo 4 step lora:使用了"4步加速"的Turbo LoRA,将原本需要几十步的扩散采样过程压缩到仅4步。
这套组合拳的目标非常明确:在消费级硬件上以可接受的时间成本跑通高质量视频生成。剪枝+int8量化解决"跑得起"的问题,Turbo 4-step LoRA解决"跑得快"的问题。
RTX 5090实测性能:17分钟生成一段视频
作者明确列出了硬件与耗时:GPU为RTX 5090,生成时间17分04秒。
17分钟的耗时究竟算快还是慢
乍看之下,17分钟生成一段视频似乎并不算快,尤其是与云端服务几十秒到几分钟的响应相比。但需要结合上下文理解:
首先,这是一个多参考、带音频的复杂任务,6张图+3段音频的输入量远超普通的"单图生视频"。其次,本地生成意味着零API费用、完全的隐私控制和无限次数的自由试错——这些是云端服务无法提供的价值。对于把它当作"爱好"的创作者而言,17分钟等待换来的是完整的创作掌控权。
即便配备了当前顶级的RTX 5090(32GB显存、Blackwell架构),本地高质量视频生成依然需要十几分钟,这也从侧面说明视频扩散模型的计算密集程度远超图像生成。
本地部署AI视频的硬件门槛
必须指出的是,RTX 5090目前仍是消费级显卡的顶配,价格不菲。这意味着即便有了剪枝和量化优化,本地跑通这类工作流的硬件门槛依然偏高。对大多数用户而言,8GB或12GB显存的显卡想要复现同等效果仍有相当距离。这也解释了为什么本地视频生成目前仍属于发烧友和技术爱好者的"小众爱好"。
本地AI视频生成的意义与发展趋势
从"能生成"到"人人可玩"
这条帖子的标题"I found my new hobby"(我找到了新爱好)本身就是一个信号。当AI视频生成从需要专业知识、昂贵云端算力的高门槛任务,逐渐演变为个人可以在家反复把玩的"爱好",说明整个技术栈的成熟度和易用性正在跨越关键节点。
开源社区在其中扮演了核心角色。正是有了剪枝、量化、Turbo LoRA等一系列开源优化方案,普通用户才有机会绕过闭源云服务,在自己的机器上探索创作可能性。
量化与加速:AI视频普及的关键路径
这个案例最具启发性的一点在于:模型优化技术正在成为AI能力下沉到消费级设备的核心杠杆。int8量化、模型剪枝、少步数采样LoRA——这些原本属于工程优化范畴的技术,正在直接决定一项AI能力能否走进普通人的书房。
可以预见,随着量化方案越来越激进、加速LoRA的步数越压越低,未来同等质量的视频生成时间有望从17分钟压缩到几分钟甚至更短,硬件门槛也会随之下探。当这一天到来时,"本地AI视频创作"或许真能从发烧友的小众爱好,变成大众触手可及的日常工具。
结语
这条看似随意的Reddit分享,实际上浓缩了当前本地AI视频生成的技术现状:顶级消费级硬件 + 深度模型优化 = 十几分钟一段的高质量创作。它既展示了开源生态的活力,也暴露了硬件门槛和耗时的现实约束。对于关注AI应用落地的人来说,这样的一线实践案例,往往比厂商的宣传更能反映技术的真实边界。
相关推荐

LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。