Mistral Large 4 魔方测试失败:模型还是框架的锅?

Mistral Large 4 魔方测试失败,但锅可能在评测框架而非模型本身
一位测试者用"构建可交互魔方模拟器"这一经典任务评估 Mistral Large 4 的编程能力,结果以失败告终。初次生成的 3D 魔方视觉效果良好、支持视角旋转,但点击"打乱"按钮无反应;迭代后又出现旋转时色块消失的新 bug,症结在于状态管理与渲染同步脱节。值得注意的是,测试者并不将失败归咎于模型本身,而是指向模型与评测框架(harness)之间的交互问题。文章由此延伸出一个更普遍的方法论警示:在"某模型翻车"的结论背后,评测环境的工程细节可能同样关键,单一测试案例不足以定论一个模型的整体编程实力。
一次经典的代码能力测试
在评估大语言模型的编程能力时,很多测试者都有自己的一套"标准动作"。构建一个可交互的魔方(Rubik's Cube)模拟器就是其中之一——它看似简单,实则对模型的空间逻辑、3D 渲染理解和交互处理能力提出了综合要求。这次被测试的主角是 Mistral Large 4。
从测试者给出的结论来看,这次尝试"绝对算得上一次失败"。但失败背后的原因,却比单纯的"模型不行"要复杂得多。
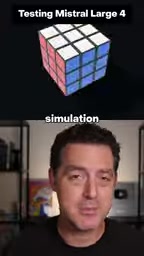
第一印象并不差
初次生成的魔方模拟器,视觉效果其实相当不错。测试者坦言:"这确实是个魔方,我可以旋转它,看起来相当漂亮,这方面没什么好抱怨的。"
这说明 Mistral Large 4 在基础的 3D 建模和渲染任务上是过关的。能够正确绘制一个三维魔方,并支持视角旋转,本身就需要模型对几何结构和前端渲染(通常是 Three.js 或 WebGL 之类的技术栈)有相当准确的把握。
Three.js 是目前最主流的 WebGL 封装库,它让开发者能够用较少的代码在浏览器中渲染复杂的 3D 场景。对大语言模型而言,生成 Three.js 代码并非易事:模型不仅需要理解场景(Scene)、摄像机(Camera)、渲染器(Renderer)的三角关系,还需要正确处理几何体(Geometry)、材质(Material)和光源(Light)的组合。魔方的特殊难点在于,它由 26 个可见子块(cubie)构成,每个子块都有多个着色面,旋转操作还需要动态重组这些子块的父子层级关系。能在首次生成时就完成这一结构,说明模型对 Three.js 的整体架构有基本掌握。
问题出在交互环节
真正的麻烦从点击"打乱"(Scramble)按钮开始。测试者描述:"当我点击 scramble 时,什么都没发生,所以我只能退回去重新迭代。"
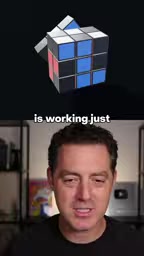
经过一轮迭代后,情况有所变化,但新的 bug 又冒了出来——魔方各个面的旋转动作本身工作正常,可一旦转动,色块就会消失。
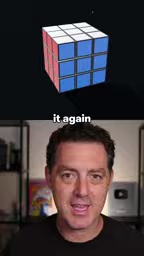
换句话说,模型理解了"如何转动一个面"的逻辑,却在转动后的状态同步(颜色贴图或面着色)上出了问题。这类 bug 往往出现在状态管理和渲染更新的衔接处,是前端交互开发中相当典型的坑。
状态管理与渲染同步是前端 3D 交互开发中最容易出错的环节之一。在魔方模拟器中,每次旋转操作会改变子块在三维空间中的位置和朝向,这既需要更新内部数据结构(记录每个面的颜色归属),也需要同步刷新 Three.js 中各对象的变换矩阵。两套状态一旦脱节——例如几何体位置更新了但颜色贴图仍引用旧的面——就会出现"转动正常但色块消失或错位"的症状。这类 bug 在人类开发者手写时也很常见,根本原因是 3D 渲染引擎的状态更新并不自动级联到业务逻辑层,需要显式同步。
到底是谁的错:模型还是框架?
这次测试最值得玩味的,是测试者的归因判断。他明确表示:"我其实并不怪模型本身,我怪的是模型和测试框架(harness)之间的交互。"
这是一个经常被忽视的关键点。当下评测大模型编程能力时,模型并非孤立运行,而是嵌入在一套 harness(执行与反馈框架)之中。代码生成、执行、报错回传、迭代修正,每个环节都可能引入变量。如果 harness 对模型的输出解析不当,或是执行环境与模型预期不符,即便模型本身生成了合理的代码,最终呈现的结果也可能是"失败"的。
这提醒我们,在看待各种"某模型翻车"的测试结论时,需要保持一份谨慎:失败未必是模型能力的直接体现,评测环境的工程细节同样举足轻重。
Harness(评测执行框架)是指在模型测试中负责接收代码输出、在沙箱环境中运行、捕获报错信息并将反馈回传给模型的那一套工具链。不同 harness 的实现差异相当显著:有些会完整传递浏览器控制台的运行时错误,有些只传递编译阶段的静态错误,还有些会对模型输出进行二次解析或截断。当 harness 未能把正确的错误上下文送回给模型时,模型的下一轮迭代等于是在"盲修"——它无法知道真正的失败原因,自然难以精准修复。这也是为什么同一个模型在不同评测平台上可能呈现出截然不同的编程表现。
对模型评测的启示
魔方测试这样的"趣味基准"在社交媒体上传播甚广,但它的方法论价值在于暴露了端到端评测的复杂性。单一一次失败案例,既不能完全否定一个模型的编程实力,也不足以成为横向对比的硬证据。
对于关注 AI 编程能力的开发者而言,更有意义的做法是:在多种 harness、多次迭代、多类任务下进行观察,并明确区分"模型逻辑错误"与"工具链问题"。只有这样,才能对一个模型的真实水平形成相对公允的判断。
由于本次素材来自单一测试者的即时体验,上述结论仅代表一次具体场景下的观察,并不构成对 Mistral Large 4 整体编程能力的定论。
相关推荐
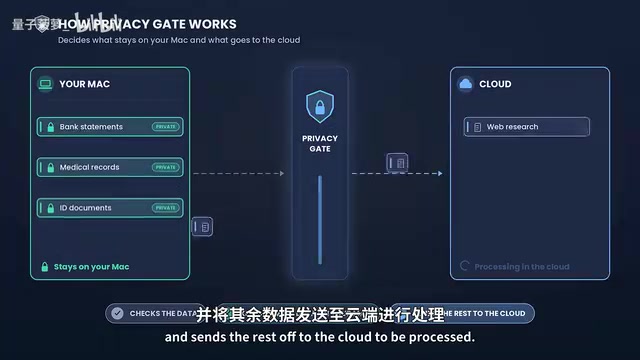
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
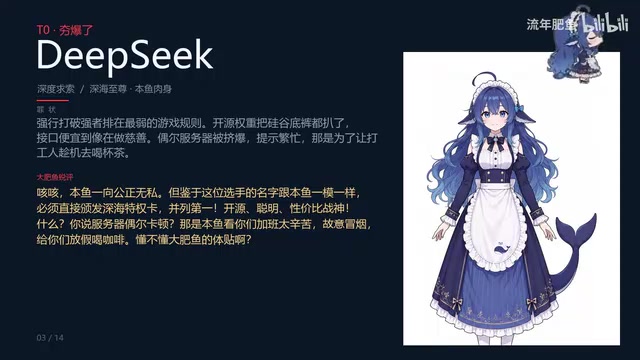
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。