Mistral Large 4开源:与DeepSeek架构差异全解析

Mistral Large 4以1T总参数对标DeepSeek,架构借鉴MLA与DSA但性价比与部署门槛处劣势。
Mistral AI发布开源大模型Large 4,总参数1024B、激活49B,规模超过DeepSeek V4.1 Flash的763B总参数。其核心架构采用DeepSeek提出的MLA和DSA注意力机制,显示开源大模型架构正趋于统一。但两者骨干设计不同:Mistral使用72层Decoder-only架构配图像编码器实现全模态,DeepSeek则用非对称编码器-解码器压缩预填充成本,推理更省算力。Mistral提供FP8与NVFP4两个版本,vLLM、SGLang、llama.cpp均快速适配,但部署需至少8块H100/H200。其优势在欧洲多语言场景,综合性价比与推理速度可能不及DeepSeek。
欧洲AI公司Mistral AI发布了Large 4系列开源大模型,直接对标中国DeepSeek。据Hugging Face技术博客介绍,这款模型在架构上大量借鉴了DeepSeek的MLA和DSA技术,但在参数规模、激活策略和部署适配上走出了不同路线。
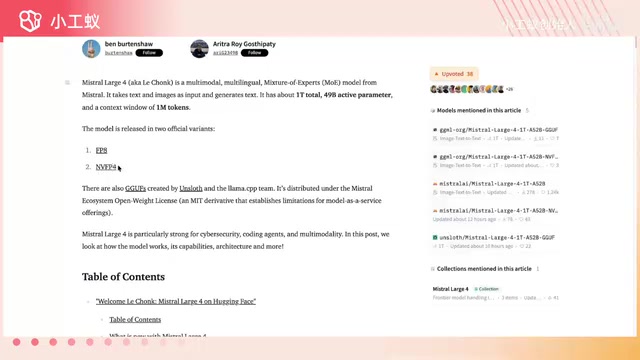
参数规模:1T总参数对763B,激活49B
Mistral Large 4采用MoE架构,总参数达到1024B(1T),激活参数49B。作为对比,DeepSeek广告 V4.1 Flash的骨干参数为552B,加上其他组件后总参数约763B。从体量上看,Mistral Large 4确实更大,但这也意味着更高的推理成本。
上下文窗口方面,Mistral Large 4支持1兆token,适合处理超长文档和复杂多模态任务。模型提供FP8和NVFP4两个版本:FP8适配H100、H200、RTX 4090等GPU,NVFP4则面向RTX 5090和B200(Blackwell架构)等更新芯片,在算力利用上更有优势。
MoE(Mixture of Experts,混合专家)架构 是理解“总参数”与“激活参数”差异的关键。MoE 模型由多个并行的前馈“专家”子网络加一个路由门控组成,每个 token 经过时门控只选择少数几个专家参与计算。因此模型虽然拥有 1024B 的总参数,但单个 token 实际只激活其中 49B,推理算力开销大致对应 49B 规模的稠密模型,而模型容量(知识存储与表达力)却接近 1T 级别。
这也解释了文中“体量更大但推理成本更高”的判断:MoE 的显存需求仍按总参数计(全部专家都要加载进显存),所以 1T 总参数意味着极高的显存门槛,这与后文“至少需 8 块 H100/H200”的部署要求直接对应;而激活参数决定单位 token 的计算量,49B 激活高于 DeepSeek 解码阶段的 16B,是其推理速度偏慢的重要原因。
架构借鉴:MLA和DSA成开源标配
Mistral Large 4的核心架构明显受到DeepSeek影响。它采用了DeepSeek发布的MLA(多头潜在注意力)和DSA(DeepSeek稀疏注意力)机制,这也是当前开源大模型的主流选择。从这一点看,DeepSeek正在引领开源AI生态的架构方向。
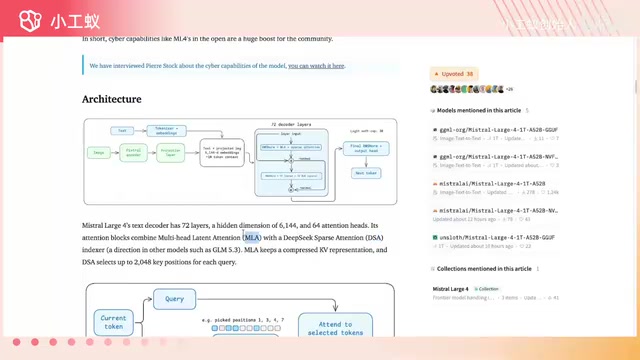
不过两者的骨干设计不同。Mistral Large 4使用72层Decoder-only架构,配合专门的图像编码器接入骨干,实现全模态支持。DeepSeek V4.1 Flash则采用非对称的编码器-解码器架构:20层编码器加20层解码器,预填充阶段主要用编码器,解码阶段用解码器。这种设计让DeepSeek在预填充时只需激活少量参数(约8B或16B),解码时激活16B,从而压缩计算成本。
Mistral Large 4没有采用这种非对称策略,72层解码层加49B激活参数,导致其推理速度大概率慢于DeepSeek V4.1 Flash。DeepSeek的架构选择明显偏向极致性价比,而Mistral似乎更注重模型容量和多语言能力。
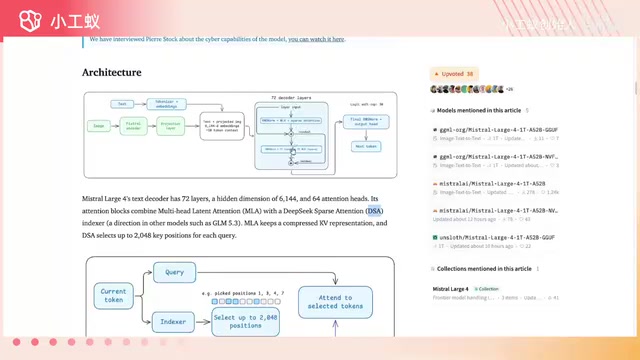
MLA(Multi-head Latent Attention,多头潜在注意力) 由 DeepSeek 在 V2 中首次提出,其核心思路是将传统多头注意力中的 Key/Value 缓存先投影到一个低维的“潜在向量”再做注意力计算,从而把 KV Cache 的显存占用压缩数倍。对于长上下文和 MoE 大模型而言,KV Cache 往往是推理显存的主要瓶颈,MLA 因此在同等显存下能支撑更长的上下文和更大的 batch,这是它被众多开源模型采纳的根本原因。
DSA(DeepSeek Sparse Attention,DeepSeek 稀疏注意力) 则是在注意力计算中引入稀疏化,让每个 token 只关注部分位置而非全量上下文,从而把注意力的计算复杂度从随序列长度平方增长降到近似线性。两者一个省显存、一个省算力,常被搭配使用。Mistral Large 4 同时采用 MLA 与 DSA,意味着它在架构层面直接继承了 DeepSeek 针对长上下文推理成本优化的一整套思路,这也是文中称“开源架构趋同”的技术依据。
生态与部署:开源免费商用,但硬件门槛高
Mistral Large 4采用开源免费商用协议,生态支持到位。vLLM、SGLang在发布当天即完成适配,llama.cpp团队和Hugging Face也提供了GGUF格式。投机解码方面,两家都使用了DeepSeek发布的Eagle算法。
但部署门槛不容忽视。官方建议使用NVFP4版本时至少需要8块H100或H200 GPU才能跑起来;用8块D300 GPU可进行FP8微调训练(非全参训练)。即便有GGUF格式,个人电脑运行这个1T模型依然非常吃力。
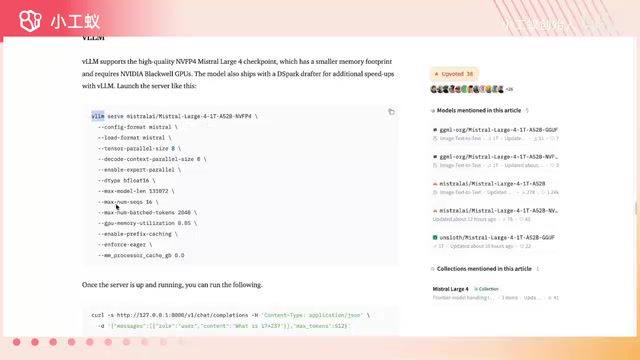
vLLM、SGLang、llama.cpp 与 GGUF 构成了当前开源模型落地的工具链。vLLM 和 SGLang 是面向服务端的高吞吐推理框架,主打 PagedAttention、连续批处理等显存与调度优化,适合多用户并发部署;发布当天即适配,意味着用户可以立刻把模型跑成 API 服务。llama.cpp 则是面向本地与边缘设备的轻量推理引擎,GGUF 是其配套的量化模型文件格式,可把权重压到 4 位甚至更低以便在消费级硬件上运行。
但工具链的完备并不等于门槛消失:GGUF 量化主要压缩的是显存占用,1T 总参数的 MoE 模型即便量化后仍需极大显存,且激活参数并不因量化而减少,因此个人电脑运行依旧吃力。投机解码(Speculative Decoding) 与文中提到的 Eagle 算法则是一种加速手段:用小模型先“草拟”若干 token,再由大模型一次性并行校验,在不改变输出分布的前提下提升生成长度方向的吞吐,这也是两家共同采用 Eagle 的原因。
性能定位:欧洲最强,但难敌DeepSeek性价比
从现有信息看,Mistral Large 4在综合性能和性价比上可能不如DeepSeek V4.1 Flash。它的优势在于欧洲语言体系——意大利语、法语、西班牙语等多语言场景表现更好,适合跨境电商等多模态应用。但在算力需求上,它明显更重。
对于开发者而言,选择取决于场景:追求极致性价比和推理速度,DeepSeek V4.1 Flash仍是首选;需要欧洲语言支持或更大多参数容量,Mistral Large 4提供了新选项。开源模型的架构趋同化也值得关注——MLA和DSA正成为事实标准,后来者很难绕开DeepSeek的技术路线。
FP8 与 NVFP4 是两种低精度数值格式,用于在推理时压缩模型权重与计算量。FP8 为 8 位浮点,在 Hopper 架构(H100/H200)上有原生张量核心支持,是当前大模型推理与训练的主流低精度格式,精度损失小、生态成熟。NVFP4 则是 NVIDIA 面向 Blackwell 架构(B200、RTX 5090)推出的 4 位浮点格式,位宽更小,理论上可让显存占用和带宽需求再降一半,但需要新硬件才能高效执行。
Mistral Large 4 同时提供两个版本,实际是把“兼容现有 GPU 生态”和“榨取新一代硬件算力”两条路都铺好:老卡用户走 FP8,新卡用户走 NVFP4 以获得更高吞吐。这也意味着模型的实际部署成本高度依赖硬件代际——若手中只有 Hopper 之前的卡,NVFP4 的算力优势无法兑现,只能退回 FP8 并承担更大的显存压力。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。