Mistral Large 4实测:万亿参数MoE模型编程能力如何?

Mistral Large 4 实测:基准领先同级,编程可用但有瑕疵,西方阵营中的务实开源选择。
Mistral AI 发布代号“LeChonk”的 Mistral Large 4,1 万亿参数 MoE 架构、每次激活 490 亿参数,支持文本与图像输入,上下文窗口达 100 万 token,并计划 10 月底开放权重。基准测试中 DeepSwee 得 62% 略高于 GLM 5.3,TerminalBench 得 28% 超过规模更大的 Kimi K3 与 QN 3.8 Max,Harvey 法律智能体基准以 15% 居展示模型之首。编程实测成功一次生成可运行的 Three.js 3D 岛屿探索游戏和含 hero、定价卡片、FAQ 的网站,主要瑕疵是网站用 emoji 代替正式图标。目前经 Mistral API 与 OpenRouter 提供,OpenRouter 五折价输入 0.68 美元、输出 2.09 美元每百万 token。作者评价克制:它不是同尺寸最好的开源权重模型,但在西方实验室中仍属较好的开放模型。
Mistral AI 近日发布了 Mistral Large 4,代号“LeChonk”。这是一个拥有 1 万亿参数的混合专家(MoE)模型,每次激活 490 亿参数,支持文本和图像输入,上下文窗口达到 100 万 token。Mistral 计划在 10 月底前开放模型权重。本文基于 YouTube 实测视频,从基准测试和实际编程任务两个维度,评估这款模型的真实水平。
基准测试:多项指标领先同级
从公布的基准数据来看,Mistral Large 4 的表现可圈可点。在 DeepSwee 测试中得分 62%,略高于 GLM 5.3 的 61%。在 TerminalBench 上得分 28%,超过了 Kimi K3 和 QN 3.8 Max——有意思的是,后两者的模型规模都大于 Mistral Large 4。在 Harvey 法律智能体基准上,它取得 15% 的得分,是图中展示的模型中最高的一项。
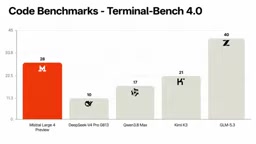
这些数据表明,Mistral Large 4 在推理与专业领域任务上具备竞争力,尤其在参数效率方面表现突出。不过,基准测试终究是理想化环境,实际表现还需通过真实任务检验。
混合专家(MoE)架构:MoE 模型由多个“专家”子网络和一个门控路由网络组成,每个 token 只被路由到少数几个专家进行计算,因此总参数量(此处 1 万亿)远大于每个 token 实际激活的参数量(此处 490 亿)。这种设计让模型可以存储大量知识,同时把单次推理的计算成本控制在较小规模,这也是原文提到“参数效率”突出的技术来源。代价是显存占用仍需容纳全部专家权重,且路由不均衡可能影响训练稳定性。
上下文窗口与长上下文:上下文窗口指模型单次调用能同时处理的 token 上限,100 万 token 约相当于数十万汉字或数百页文档。长上下文能力依赖位置编码外推、注意力稀疏化或分块处理等技术,并非简单把窗口调大即可;实际有效长度往往短于标称值,评测中常需“大海捞针”类测试验证。
编程实测:3D游戏与网站构建
视频作者通过 VS Code 的自定义付费端点调用 Mistral Large 4,进行了三项编程测试。
3D 岛屿探索游戏
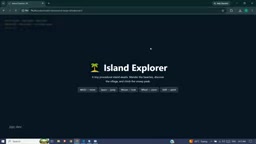
第一个测试是使用 Three.js 构建一个 3D 岛屿探索游戏。模型在接收提示后进入思考状态,随后生成 HTML 文件,并执行语法检查。最终成品在浏览器中运行良好:岛屿、树木、岩石和角色视觉元素协调,移动和相机控制正常。对于一次生成的任务来说,完成度令人满意。
网站构建
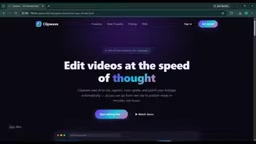
第二个测试是搭建一个包含 hero 区域、定价卡片、FAQ 和微交互的网站。模型生成了所有要求的区块,布局正常,页面结构符合预期。一个明显的瑕疵是:部分位置使用了 emoji 代替正式图标。除此之外,网站功能符合提示要求。
另一款游戏
作者还测试了另一款游戏,移动控制、计分系统和视觉效果均正常工作。
Three.js:一个基于 WebGL 的 JavaScript 3D 图形库,开发者无需直接编写底层着色器和渲染管线,即可在浏览器中构建 3D 场景、模型、光照与相机控制。原文测试中模型生成的岛屿、树木、角色以及移动与相机逻辑,均通过 Three.js 的 Scene、Mesh、Camera 等对象实现。它对模型的考验在于能否正确组织场景图结构、处理渲染循环与输入事件,而不是仅仅输出正确语法。
TerminalBench 与 Harvey 基准:TerminalBench 面向命令行终端环境中的智能体任务,评测模型在真实 shell 操作、多步工具调用中的完成率,得分偏低通常说明智能体能力仍是短板;Harvey 基准则面向法律专业任务,考察模型在合同分析、法律推理等场景中的表现。这类领域基准与通用代码基准互补,能更细致地反映模型在垂直场景中的可用性。
可用性与定价
目前,Mistral Large 4 可通过 Mistral API 和 OpenRouter 使用。在 OpenRouter 上,当前有 5 折优惠,输入 token 每百万 0.68 美元,输出 token 每百万 2.09 美元。由于权重尚未发布,暂时没有免费使用的途径。对于希望低成本试用的开发者,OpenRouter 的折扣价是一个合理的入口。
OpenRouter 与 API 定价:OpenRouter 是一个聚合多家模型提供商的统一 API 网关,开发者用同一套接口和密钥即可切换不同厂商模型,并按 token 计费。文中“输入 0.68 美元/百万 token、输出 2.09 美元/百万 token”是典型的按量计费模式,输出价格通常高于输入,因为生成阶段计算更密集。五折优惠属于阶段性促销,实际成本会随流量、缓存命中与上下文长度变化,长上下文任务的实际账单可能显著高于名义单价。
综合评价:西方实验室中的务实选择
作者的结论颇为克制:Mistral Large 4 并非同尺寸下最好的开源权重模型,但在西方实验室的产品中,它仍属于较好的开放模型之列。从实测来看,它“相当不错”——不完美,但也不差。
这一评价反映了当前开源模型竞争的格局:中国实验室在开源权重领域攻势猛烈,而 Mistral 作为欧洲代表,在参数效率和多模态能力上保持了自身特色。对于需要文本+图像输入、长上下文且偏好西方供应商的团队,Mistral Large 4 值得纳入评估清单。
权重开放后,模型的可及性和社区生态将迎来真正的考验。届时,更广泛的开发者反馈才能给出最终答案。
相关推荐

Anthropic递交S-1:半年营收163亿、净亏807亿,谁在控制公司?
Anthropic递交S-1申请纳斯达克上市:2026上半年营收163亿美元、净亏损807亿美元源于估值重估而非现金流出,创始人持Class F股份掌握50.1%投票权,发行价与日期尚未公布。

Anthropic递交S-1:163亿营收与807亿亏损背后的真相
Anthropic S-1文件披露2026上半年163亿美元营收与807亿美元净亏损,其中724亿为会计效应。文件同时揭示2656亿美元算力承诺、云协议细节及创始人50.1%投票权控制结构,IPO定价仍留白。

Anthropic财务数据曝光:营收远超算力成本,Claude推理毛利率达68%
Anthropic泄露财务数据显示,其营收约为总算力成本两倍,Claude推理毛利率达68%,而前沿训练单季烧掉28亿美元。本文拆解推理与训练两笔账,分析AI公司估值逻辑的变化与数据的审慎解读。