MLX-serve实现百万token本地推理

面向真实长上下文场景的推理引擎
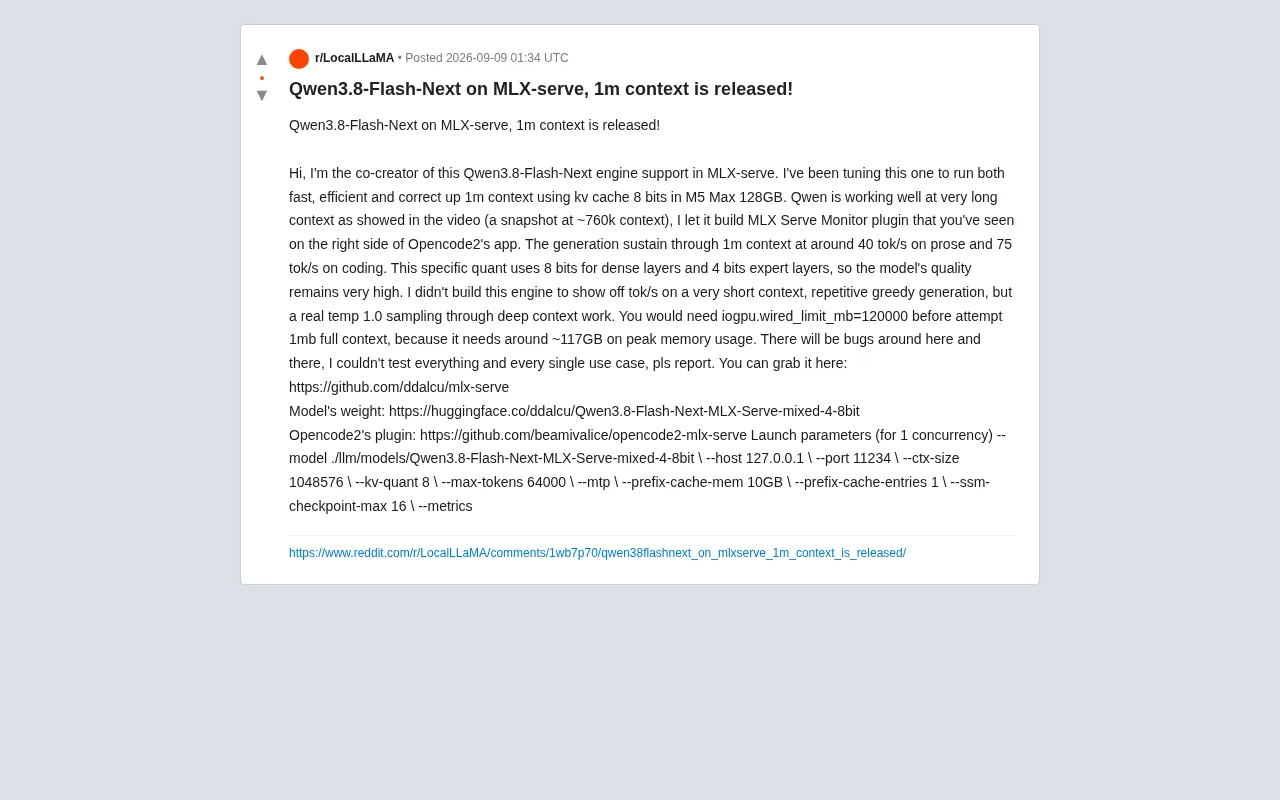
一位开发者在Reddit上发布了为MLX-serve添加Qwen3.8-Flash-Next模型支持的项目,成功在苹果M5 Max 128GB设备上实现100万(1M)token上下文窗口的本地运行。这一成果的独特之处在于,它专注于真实的深度上下文工作场景,而非简单的性能跑分。
Qwen3.8-Flash-Next模型背景
Qwen3.8-Flash-Next是阿里巴巴通义千问团队推出的Qwen3系列模型中的轻量高效变体。"Flash"系列定位于在较小参数量下实现接近大模型的性能,特别适合资源受限的本地部署场景。该模型采用MoE(混合专家)架构,总参数量虽大,但每次推理仅激活部分专家网络,兼顾了模型容量与推理效率。"Next"后缀通常意味着该版本集成了最新的训练技术改进,如更长的上下文训练窗口和更优的注意力机制。
MoE架构的核心思想是"分而治之":模型包含数十甚至上百个专家子网络,但每个token的处理仅由一个路由器(Router)选择其中2-8个专家参与计算。例如,一个总参数量为200B的MoE模型,若每次仅激活8个专家中的2个,则实际推理计算量可能仅相当于一个50B的稠密模型,但因为拥有200B的总参数存储容量,模型的知识广度和多任务能力远超同等推理成本的稠密模型。这种"大容量、低激活"的设计思路使Flash系列能够在消费级硬件上运行时兼顾响应速度与输出质量——激活参数少意味着每次前向传播的计算量可控,而庞大的专家池则保证了模型在面对不同领域任务时都能调动合适的"专家"来处理。路由器的设计质量直接影响模型表现:如果路由不均衡,部分专家过载而其他专家闲置,不仅浪费容量还会降低输出质量。Qwen团队在Flash系列中采用了经过优化的负载均衡路由策略,确保专家利用率的均匀分布。
上下文窗口的实际意义
上下文窗口(Context Window)指模型一次能处理的token数量上限。1个token约对应0.75个英文单词或0.5个中文字,因此1M token约相当于75万英文单词或50万中文字——相当于数本长篇小说或一个中型代码库的全部内容。真实场景中,长上下文能力至关重要:分析完整代码仓库需要数十万token,法律文档审查、学术论文综述、长篇创作续写都依赖深度上下文。但业界基准测试常用短上下文(2k-8k token)、低温度采样(temperature<0.5,输出更确定性)来展示速度,这与需要创造性输出(temperature=1.0,高随机性)的长上下文生产场景存在本质差异。
长上下文的核心技术挑战在于Transformer架构中自注意力机制的计算复杂度。标准自注意力的时间和空间复杂度均为O(n²),其中n为序列长度。这意味着上下文从8k扩展到1M(增长125倍),注意力计算量理论上将增长约15,625倍——这在工程上是不可接受的。为此,现代长上下文模型普遍采用多种优化策略:**分组查询注意力(GQA)**让多个查询头共享同一组键值头,大幅减少KV缓存的内存占用;**滑动窗口注意力(Sliding Window Attention)**让较低层只关注局部上下文,仅在高层执行全局注意力,降低整体计算量;FlashAttention算法则通过分块计算和IO感知的内存访问模式,在不改变数学结果的前提下将注意力计算的实际速度提升2-4倍。Qwen3系列在训练时就采用了渐进式上下文扩展策略——先在短上下文上充分训练,再逐步扩展到更长序列,配合RoPE(旋转位置编码)的频率外推技术,使模型在超出训练长度的上下文中仍能保持合理的位置感知能力。
温度(temperature)参数控制模型输出的随机性:temperature=0时模型始终选择概率最高的token,输出完全确定;temperature=1.0时按原始概率分布采样,输出多样且富有创造性。基准测试通常使用低温度,因为输出确定性高、结果可复现,且模型在低温度下可利用推测性解码等优化手段获得更高速度。但真实创作、对话、头脑风暴等场景需要高温度采样,这对引擎的稳定性和内存管理提出了更高要求——高随机性意味着更难利用缓存和预测优化。
开发者明确表示,这个引擎并非为了在极短上下文下展示漂亮的token/s数字,而是要在temperature=1.0采样条件下,稳定处理跨越百万token的深度上下文任务。这与多数本地推理基准测试形成鲜明对比——后者通常在短上下文、低温度采样下进行,与实际生产场景存在显著差距。
核心性能表现
从开发者提供的演示视频(约760k上下文)和实测数据来看,该方案的性能表现扎实:
- 生成速度:散文/文本生成任务稳定约40 tok/s,编程任务约75 tok/s,且这一速度能够贯穿整个1M上下文而不明显衰减
- 量化策略:采用混合精度量化,稠密层使用8比特,专家层使用4比特,KV缓存采用8比特量化
- 内存占用:1M上下文满负荷运行时峰值内存约117GB,需要将系统参数
iogpu.wired_limit_mb设置为120000
速度不衰减的工程意义
"贯穿整个1M上下文而不明显衰减"这一特性值得特别关注。在常规实现中,随着上下文增长,每生成一个新token都需要与所有历史token计算注意力,计算量线性增长,导致生成速度逐渐降低——许多模型在上下文超过100k后速度可能降至初始的1/3甚至更低。该项目能够维持速度稳定,暗示其在注意力计算上采用了高效的分块处理策略:并非每次都重新计算全部注意力,而是通过KV缓存增量更新、分层注意力范围控制等手段,将每个新token的边际计算成本控制在近似常数范围内。这对于真实工作流至关重要——用户不会接受一个在处理到文档末尾时变得极其缓慢的推理引擎。
散文与编程任务的速度差异解析
散文生成40 tok/s与编程生成75 tok/s的显著差异值得深入理解。除了后文将介绍的MTP技术在代码场景的优势外,这种差异还与token粒度和注意力模式有关。代码中存在大量重复性结构(如括号、缩进、关键字),tokenizer对代码的编码效率更高,且代码的局部依赖性强于散文——代码token更多依赖近距离上下文(如同一函数内的变量),而散文可能需要关注数千token之前的叙事线索。这意味着代码生成时注意力计算的有效范围更集中,硬件缓存命中率更高,进一步提升了吞吐表现。
量化技术详解
量化(Quantization)是将模型权重从高精度(如16位浮点数)转换为低精度(如8位或4位整数)的技术,可显著减少内存占用和计算量。该项目采用的混合精度策略体现了对模型架构的深入理解:稠密层(Dense Layers)是每个token都会经过的计算路径,采用8比特量化保证基础质量;专家层(Expert Layers)是MoE(混合专家)架构中按需激活的部分,仅部分专家参与计算,采用更激进的4比特量化。KV缓存(Key-Value Cache)存储注意力机制的历史状态,在长上下文场景下占用大量内存——1M token的KV缓存未量化可达数十GB,8比特量化将其压缩到可管理的范围。
从信息论角度理解量化的取舍:16位浮点数能表示约65,000个不同值,8比特整数仅能表示256个值,4比特则只有16个值。量化本质上是一种有损压缩——将连续的权重值映射到有限的离散点上。混合精度策略的精妙之处在于:稠密层虽然参数量占比较小(在MoE模型中通常不到总参数的20%),但每个token都必须经过,量化误差会对所有输出产生影响,因此需要更高精度来保护;而专家层参数量庞大但每次仅部分激活,单个专家的量化误差只影响路由到该专家的token子集,且多专家的误差存在统计上的互相抵消效应,因此可以承受更激进的压缩。这种差异化策略使得117GB的总内存占用中,模型权重和KV缓存之间达到了合理的分配平衡。
开发者特别强调,混合4-8比特量化策略在保持模型质量的同时有效压缩了内存占用。这在长上下文场景下至关重要,因为量化误差的累积往往会导致输出质量显著劣化。
iogpu.wired_limit_mb参数说明
macOS系统默认限制GPU可使用的锁定内存(Wired Memory)上限,防止GPU进程耗尽系统资源导致死机。iogpu.wired_limit_mb是系统内核参数,控制这一上限值(单位MB)。该项目推理时GPU需访问117GB数据,远超默认限制,必须将参数调整为120000(约117GB)才能正常运行。修改方法通常是编辑/Library/Preferences/SystemConfiguration/com.apple.Boot.plist添加启动参数,需要管理员权限且重启后生效。这是苹果统一内存架构的双刃剑:虽然GPU可访问全部系统内存,但系统也需保护机制防止失控。普通用户需谨慎调整此参数,设置过高可能导致系统不稳定。
真实场景验证:自建监控插件
为验证引擎在实际工作流中的可用性,开发者让Qwen在深度上下文下构建了一个MLX Serve Monitor插件,并将其集成到Opencode2应用中。这种"用模型开发工具、再用工具监控模型"的闭环演示,比单纯的性能跑分更具说服力。
启动配置与技术细节
项目代码与模型权重均已开源。对于希望复现的用户,开发者给出了单并发下的启动参数:
--model ./llm/models/Qwen3.8-Flash-Next-MLX-Serve-mixed-4-8bit \\\\
--host 127.0.0.1 \\\\
--port 11234 \\\\
--ctx-size 1048576 \\\\
--kv-quant 8 \\\\
--max-tokens 64000 \\\\
--mtp \\\\
--prefix-cache-mem 10GB \\\\
--prefix-cache-entries 1 \\\\
--ssm-checkpoint-max 16 \\\\
--metrics
从参数配置可以看出几个工程亮点:
--ctx-size 1048576明确设定1M token上下文长度--kv-quant 8启用8比特KV缓存量化,这是控制长上下文内存占用的核心手段--mtp启用多token预测(Multi-Token Prediction),提升生成吞吐--prefix-cache-mem 10GB与--ssm-checkpoint-max 16涉及前缀缓存和状态检查点机制,用于减少重复计算、维持长会话响应速度
多token预测技术
传统自回归语言模型每次只预测下一个token,生成n个token需要n次前向传播。多token预测(Multi-Token Prediction, MTP)是一种推理优化技术,通过在模型头部添加多个预测分支,一次前向传播同时预测接下来的k个token(通常k=2-4)。若预测准确,可直接跳过这k-1次计算,显著提升吞吐量。该技术在代码生成等高确定性任务中效果尤为明显——代码语法结构相对固定,后续token可预测性强。项目中编程任务达到75 tok/s而散文仅40 tok/s,部分原因正是MTP在代码场景的优势。需要注意的是,MTP提升的是吞吐(throughput)而非延迟(latency)——首token延迟不变,但总体生成速度更快。
MTP与推测性解码(Speculative Decoding)在思路上有相似之处,但实现路径不同。推测性解码使用一个小型"草稿模型"快速生成候选token序列,再由大模型一次性验证;而MTP直接在大模型内部集成多个预测头,不需要额外的草稿模型,部署更简洁。Qwen3.8-Flash-Next原生支持MTP,说明该能力在模型训练阶段就已内置,而非纯粹的推理时优化。
从更深层的技术角度来看,MTP的"接受率"(acceptance rate)是决定实际加速效果的关键指标。接受率指MTP预测的多个token中被最终采纳的比例。在代码生成中,当模型正在输出一个常见的代码模式(如for i in range(),后续几个token几乎是确定的,接受率可以接近100%,此时MTP的加速效果趋近于理论上限k倍。而在散文创作中,特别是在temperature=1.0的高随机性采样下,每个位置的token选择空间更大,MTP的预测更容易与实际采样结果不一致,接受率下降,加速效果打折。这也解释了为何开发者将temperature条件作为重要声明——这是一个比token/s数字更能反映真实工作负载的指标。
前缀缓存与状态检查点机制
前缀缓存(Prefix Caching)利用了长对话中system prompt和历史对话通常不变的特点:将这些固定前缀的KV缓存保存下来,新一轮对话时直接复用,避免重复计算。--prefix-cache-mem 10GB分配10GB内存存储这些缓存。状态检查点(SSM Checkpoint)则是定期保存模型推理状态的快照,当会话意外中断或需要回溯时,可从最近的检查点恢复而非从头计算。--ssm-checkpoint-max 16限制最多保存16个检查点,平衡内存占用与恢复粒度。这两项机制在长会话场景下至关重要:处理1M token可能耗时数分钟甚至更久,没有缓存和检查点,每次新输入都要重新处理全部上下文,用户体验极差。
以一个具体场景来说明前缀缓存的价值:假设用户正在用模型分析一个50万token的代码仓库,并进行多轮问答。没有前缀缓存时,每轮问答都需要重新处理这50万token的上下文,即使前缀完全相同——以M5 Max的prefill速度估算,每轮可能需要等待数分钟才能开始获得回复。启用前缀缓存后,第一轮问答完成的KV缓存被保留,后续轮次仅需处理新增的用户输入部分,响应延迟可从分钟级降低到秒级。--prefix-cache-entries 1的设置表明当前配置针对单会话优化——这与单并发的使用场景一致,避免多会话间的缓存竞争浪费内存。
相关资源
- 引擎代码:github.com/ddalcu/mlx-serve
- 模型权重:huggingface.co/ddalcu/Qwen3.8-Flash-Next-MLX-Serve-mixed-4-8bit
- Opencode2插件:github.com/beamivalice/opencode2-mlx-serve
技术价值与现实挑战
MLX与苹果统一内存架构
MLX是苹果公司于2023年12月发布的专为苹果芯片优化的机器学习框架,类似于Google的JAX。其最大特点是充分利用了苹果芯片的统一内存架构(Unified Memory Architecture, UMA)——CPU、GPU和神经引擎共享同一块物理内存,避免了传统架构中CPU内存与GPU显存之间的数据拷贝开销。这使得Mac设备在处理大模型时具有独特优势:128GB统一内存可以被推理引擎完全利用,而传统GPU方案中,即使系统有128GB内存,GPU显存通常只有24GB,成为严重瓶颈。MLX-serve是社区在MLX基础上开发的推理服务层,提供了类似OpenAI API的接口。
MLX与其他本地推理框架的生态定位
MLX在本地推理生态中占据独特位置,理解其与其他框架的差异有助于判断该项目的技术选择。llama.cpp是目前最广泛使用的本地推理方案,采用纯C/C++实现,支持几乎所有硬件平台(x86 CPU、NVIDIA GPU、苹果Metal等),优势在于极致的跨平台兼容性和社区规模,但其Metal后端是"适配"而非"原生优化",在苹果芯片上的性能挖掘深度不如MLX。Ollama本质上是llama.cpp的用户友好封装,降低了使用门槛但未引入新的底层优化。vLLM专注于服务端高并发场景,核心优化如PagedAttention针对NVIDIA GPU设计,不支持苹果芯片。MLX的优势在于其API设计与PyTorch/NumPy高度相似(降低开发门槛),且能直接调用苹果芯片的统一内存、AMX矩阵加速单元和神经引擎等专有硬件特性,在苹果平台上的性能上限高于通用框架的Metal适配层。该项目选择MLX作为底层框架,正是为了最大化利用M5 Max的硬件能力——特别是在117GB内存占用的极限场景下,MLX对统一内存的原生理解至关重要。
M5 Max芯片的硬件基础
苹果M5 Max是2025年发布的旗舰级芯片,最高支持128GB统一内存和超过400GB/s的内存带宽。在大模型推理中,内存带宽往往是瓶颈而非算力——因为自回归生成阶段是内存带宽受限(memory-bound)任务,每生成一个token都需要读取全部模型权重。M5 Max的高内存带宽使其在本地推理场景下具备与中端数据中心GPU竞争的能力。作为对比,NVIDIA RTX 4090虽然算力更强,但仅有24GB显存和1TB/s带宽;而M5 Max以128GB内存容量弥补了带宽差距,在超长上下文场景下反而更具可行性。
用roofline模型的视角可以更清晰地理解这一点。大模型自回归生成的算术强度(arithmetic intensity,即每字节数据传输对应的浮点运算次数)极低——大约只有1-2 FLOP/byte。这意味着无论GPU算力多强,实际性能都被内存带宽所限制。以该项目的混合量化模型为例,每生成一个token需要读取约30-40GB的模型权重(4-8bit量化后),M5 Max的400GB/s带宽理论上限约为每秒读取10-13次完整权重,对应约10-13 tok/s的理论单batch生成速度。实际达到40-75 tok/s的速度暗示系统有效利用了批处理、KV缓存复用和MTP等技术来提升有效吞吐,使每个token的边际内存访问成本大幅低于朴素实现。这种"容量换带宽"的策略——用128GB的大内存容纳完整模型和KV缓存,避免任何数据在不同存储层级间搬运——正是苹果UMA架构在超长上下文场景下的核心竞争力。
这个项目进一步验证了苹果统一内存架构在本地大模型推理上的独特优势。128GB统一内存让消费级设备也能承载117GB量级的推理负载——这在传统独立显存GPU上几乎无法实现。MLX作为苹果官方机器学习框架,配合社区驱动的serve层,正在逐步补齐本地长上下文推理的能力短板。
本地推理的隐私价值
本地百万token推理的核心价值之一在于数据隐私。在法律文档审查、企业代码分析、医疗记录处理等场景中,将数十万token的敏感数据上传至云端API存在合规风险——GDPR、HIPAA等法规对数据传输和存储有严格限制。而本地推理确保数据始终不离开用户设备。此前这一需求只能通过昂贵的私有化部署(需要多张A100/H100 GPU,成本数十万元起)来满足,苹果芯片配合MLX生态将门槛降低到了一台消费级笔记本电脑的水平——尽管M5 Max 128GB版本售价不菲,但相比企业级GPU集群仍是数量级的成本下降。
开发者坦诚指出,项目"到处都可能有bug",无法测试每一个使用场景,呼吁用户积极反馈。这提醒我们,百万token的本地推理仍处于早期探索阶段,实际稳定性和边缘case处理还需社区共同打磨。
对于拥有高配Mac、且需要处理超长文档、大型代码库或深度对话的开发者,这套方案提供了一个完全本地化的选择——无需上传敏感数据到云端,即可在一台机器上完成百万token级别的推理任务。
核心要点
核心要点
核心要点
相关推荐

LangGraph入门指南:AI Agent的操作系统全解析
LangGraph 被称为 AI Agent 的操作系统,本文系统梳理其与 LangChain 的关系、状态节点边三大要素、持久化 checkpoint、human-in-the-loop 及子图等核心能力与学习路径。

吴恩达谈Agentic AI:拨开炒作看智能体构建的核心技能
吴恩达 Agentic AI 课程开讲,剖析智能体炒作背后的真实价值。从客户支持、法律文档到医疗诊断的落地场景,揭示评估与错误分析为何是构建智能体工作流的核心技能。

吴恩达谈Agentic AI:构建智能体应用的核心方法论
吴恩达 Agentic AI 课程深度解读:从术语被过度炒作说起,剖析智能体工作流在客户支持、深度研究、法律与医疗诊断中的真实应用,并揭示优秀开发者依靠评估(Evals)与错误分析的纪律化开发流程这一核心方法论。