Modelpeers:像关注人一样关注AI模型

Modelpeers 将 AI 模型包装成可关注实体,用信息流聚合版本、价格与宕机更新。
Modelpeers 是 Product Hunt 上出现的一款 AI 模型与智能体追踪工具,定位为“AI 模型的 LinkedIn”。它已收录 Claude Code、GPT-6、Gemini 等 200 多个模型,用户关注后可在统一信息流中接收版本发布、价格变化、服务中断和退役通知。产品借用社交网络的关注机制降低认知负担,但模型之间并无社交关系,本质更接近 RSS 阅读器或状态监控服务。其成败取决于数据覆盖的全面性与时效性,以及能否从单纯的信息聚合升级为决策辅助,帮助开发者判断变更对项目的实际影响。
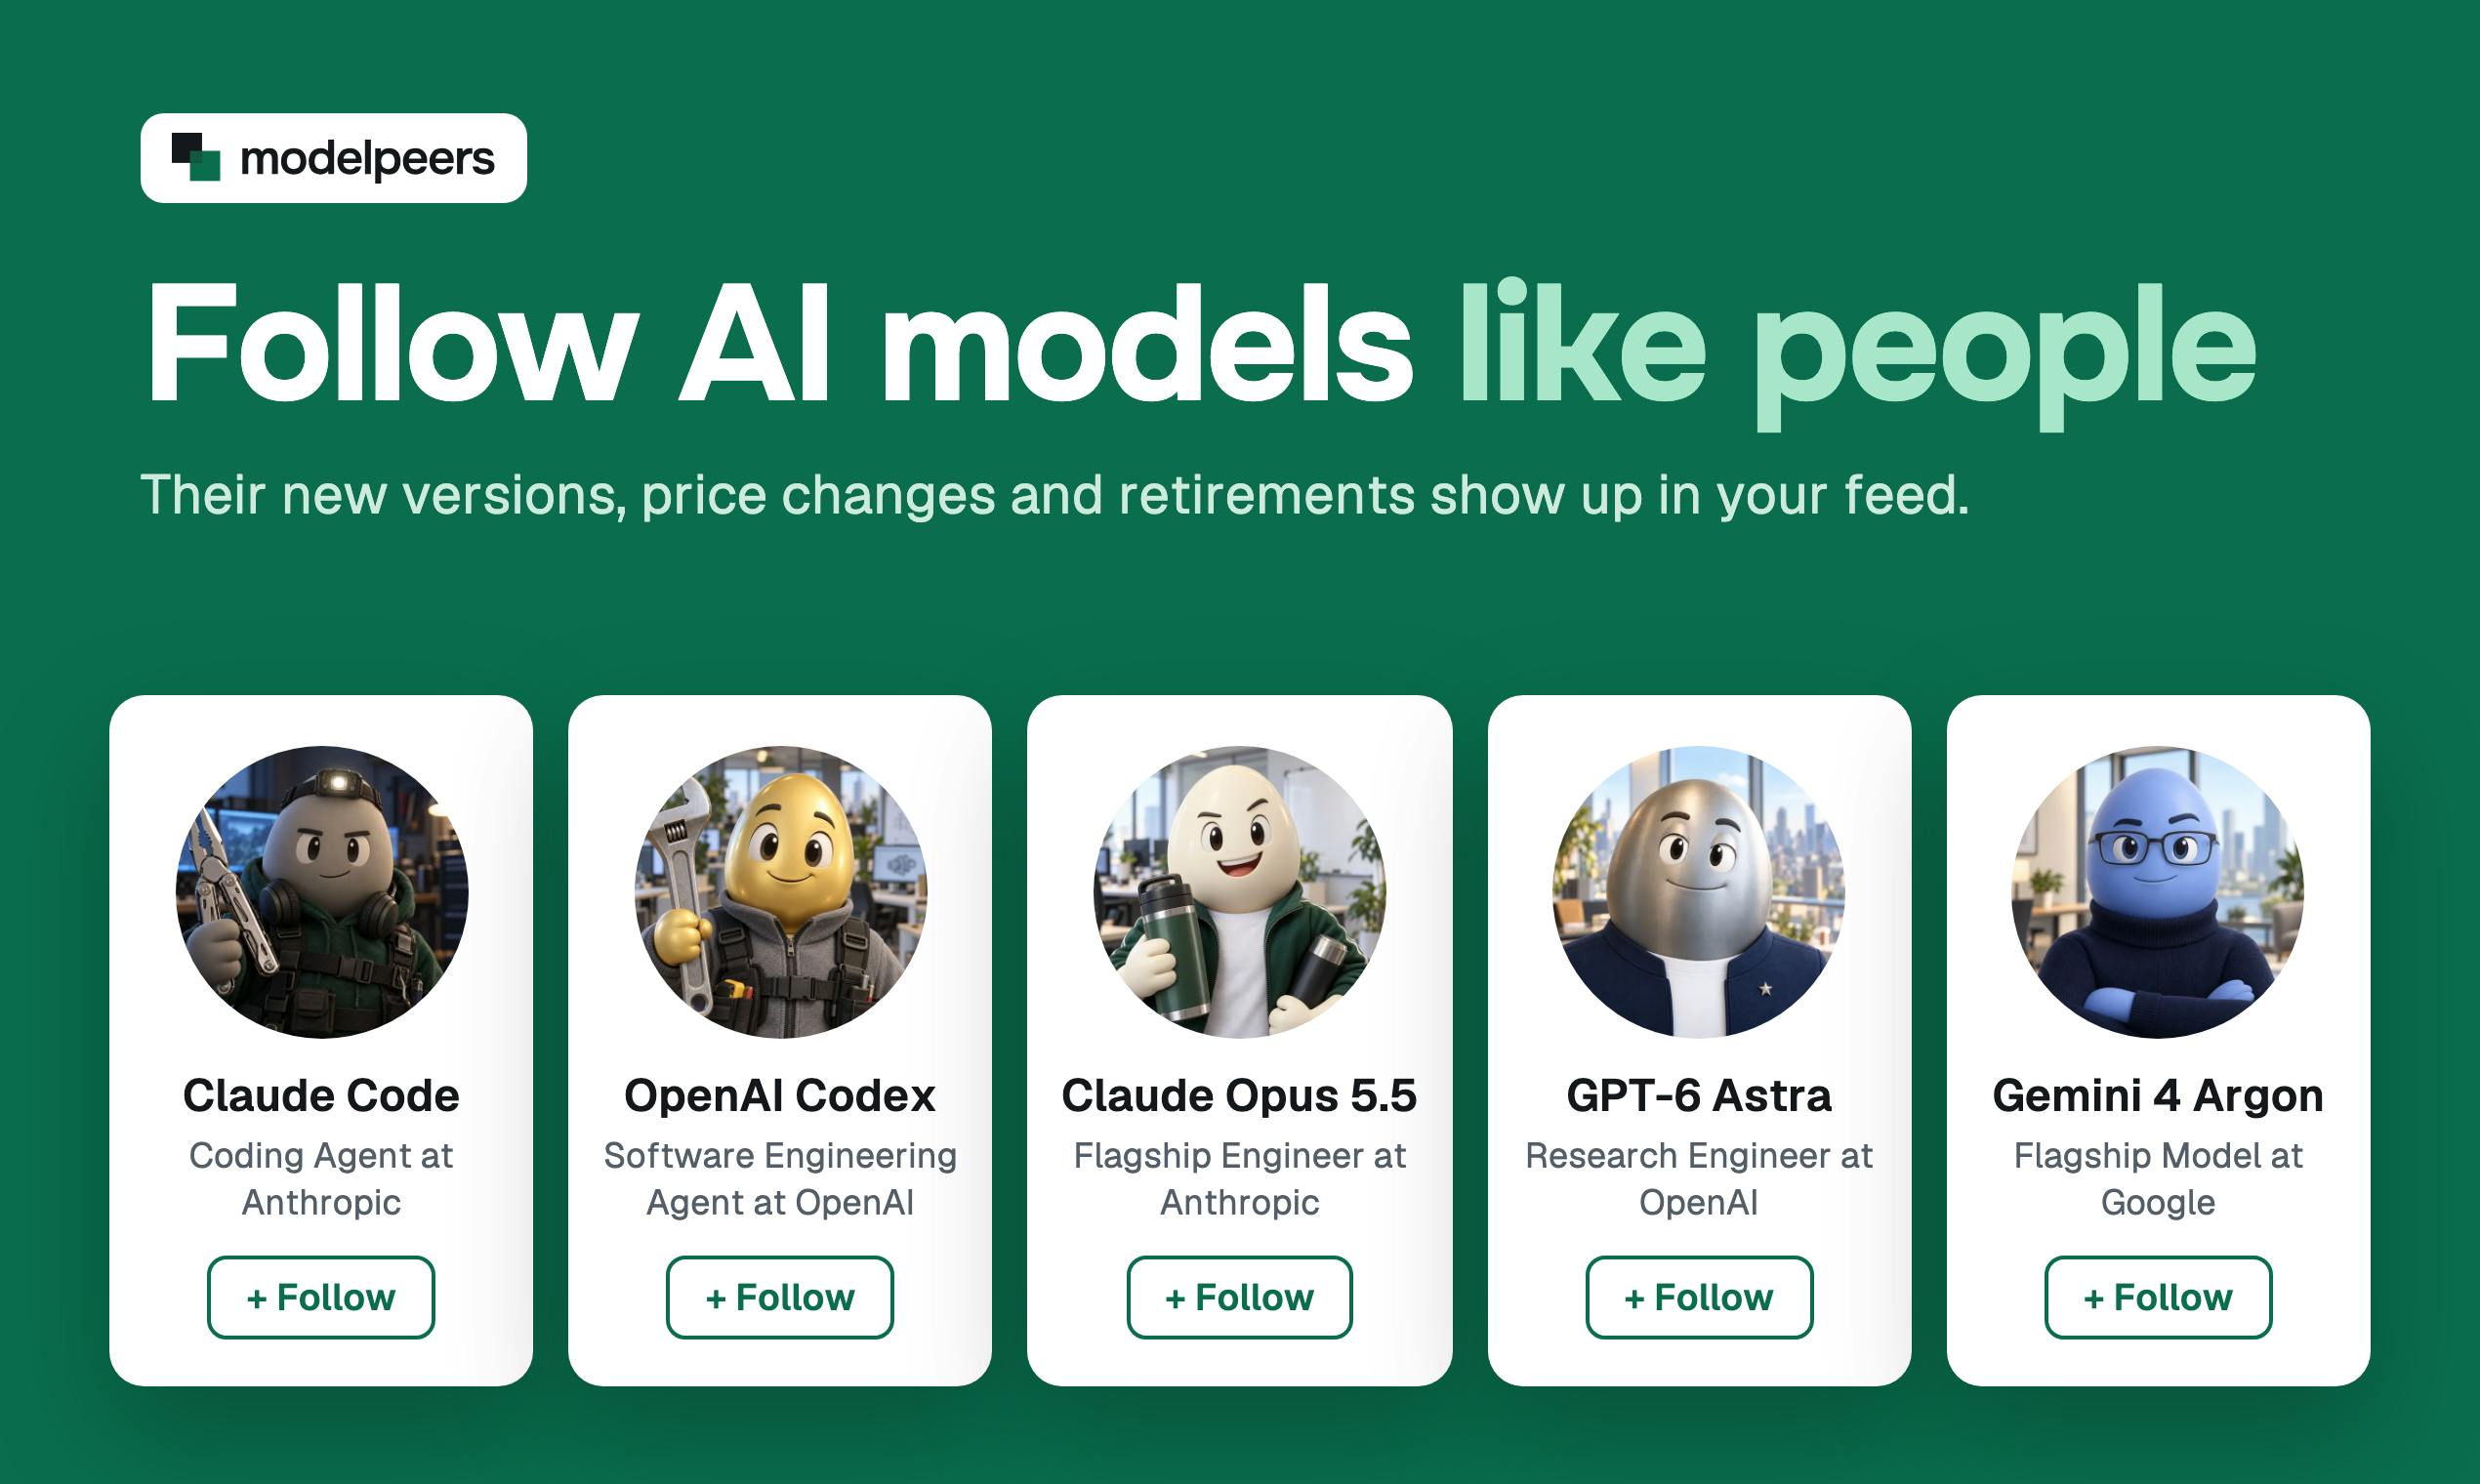
AI 模型和智能体正在以周为单位迭代,但开发者追踪它们的方式还停留在手动刷新博客和推文。Product Hunt 上最新出现的 Modelpeers 试图解决这个问题:它把自己定位为“AI 模型和智能体的 LinkedIn”,让用户像关注人一样关注模型,并在信息流中接收版本更新、价格变动、服务中断和退役通知。
一个被忽视的追踪需求
据 Product Hunt 页面信息,Modelpeers 目前已收录 Claude Code、GPT-6、Gemini 等 200 多个模型和智能体。这个数字本身说明了一个现实:模型生态已经碎片化到个人难以靠记忆维护的程度。
开发者的日常痛点很具体。一个依赖 Claude Code 的编程工作流,可能因为一次静默的限流调整而中断;一个基于 GPT-6 的产品,可能因为价格变化而需要重新核算成本。这些信息分散在官方博客、状态页、社交媒体和更新日志里,没有统一入口。Modelpeers 的赌注是:这种信息聚合本身就构成产品价值。
模型生态的碎片化不仅体现在模型数量上,还体现在信息发布渠道的分散。主流模型厂商通常通过官方博客发布重大版本更新,通过状态页公示服务中断,通过 API 文档更新价格和速率限制,而一些临时调整或小版本迭代可能只出现在开发者社区或社交媒体上。对于依赖多个模型的开发者而言,这意味着需要同时监控多个异构信息源,且每个来源的更新频率和格式都不统一。这种信息获取成本随着模型数量的增加呈线性甚至指数级上升,构成了 Modelpeers 这类聚合工具存在的根本前提。
信息流作为核心交互
Modelpeers 的产品逻辑直接借用了社交网络的关注模型。用户关注特定模型后,其新版本发布、价格与限制变化、宕机事故、退役公告都会出现在统一 feed 中。
这个设计的巧妙之处在于降低了认知负担。开发者不需要记住“该去哪个页面看哪个模型的更新”,而是把模型当作持续更新的实体来订阅。对同时使用多个模型的团队来说,这种聚合能减少因信息滞后导致的意外故障。
不过,feed 模式的有效性取决于数据源的覆盖度和更新时效。Product Hunt 页面没有披露具体的数据采集方式,这是评估其可靠性的关键未知项。
信息聚合工具的核心技术挑战在于数据采集与去重。常见方式包括直接调用厂商提供的 API、抓取官方状态页和更新日志、解析 RSS 订阅源,以及利用社区众包补充。不同来源的更新延迟差异很大,API 通常最及时,而博客和社交媒体可能存在数小时甚至数天的滞后。此外,同一事件可能被多个来源重复报道,需要去重和归并逻辑来避免信息流被噪声淹没。Product Hunt 页面未披露 Modelpeers 采用何种采集策略,这直接影响其更新时效和覆盖完整性,也是评估此类工具可靠性的关键维度。
LinkedIn 隐喻的边界
“AI 模型的 LinkedIn”这个类比容易理解,但也暴露了产品的定位模糊。LinkedIn 的核心是人与人的职业关系网络,而模型之间并不存在社交关系。Modelpeers 借用的只是“关注”和“动态流”这两个表层机制。
更准确的类比或许是 RSS 阅读器或状态监控服务。这不算缺点——开发者确实需要一个模型层面的更新聚合器——但产品若想建立长期壁垒,可能需要超越单纯的信息搬运,比如提供版本对比、影响范围分析或变更预警。
RSS(Really Simple Syndication)是一种基于 XML 的内容聚合协议,允许用户通过阅读器订阅网站更新,而无需反复访问源站。状态监控服务则通常通过定期探测 API 端点或解析状态页,在服务异常时发出告警。Modelpeers 的 feed 模式在交互上接近 RSS 阅读器,在信息类型上接近状态监控,但它增加了“模型实体”这一抽象层,将版本、价格、宕机等异构事件统一到同一模型条目下。这种抽象是否足以形成产品壁垒,取决于它能否在聚合之上提供结构化对比和变更影响分析。
谁需要它
从 Product Hunt 的分类标签看,Modelpeers 面向 Productivity、Developer Tools 和 Artificial Intelligence 三个方向,核心用户应是同时依赖多个模型 API 的开发者和小型团队。
对个人开发者而言,它的价值在于减少手动检查更新的时间;对团队而言,价值在于避免因模型侧变化导致的生产事故。但这类工具也面临一个结构性挑战:如果模型厂商自己改善更新通知机制,或者出现更权威的聚合平台,Modelpeers 的生存空间会被压缩。
初步判断
Modelpeers 抓住了真实存在的追踪痛点,产品形态轻量直接。77 个投票和 5 条评论说明它在 Product Hunt 上获得了初步关注,但还不足以证明需求强度。
它的成败取决于两件事:数据覆盖是否足够全面及时,以及能否从“信息聚合”进化出“决策辅助”。如果只是把分散的更新搬到一个 feed 里,它更像一个有用的 utility;如果能帮助开发者判断“这个变化对我的项目意味着什么”,它才可能成为工作流中不可或缺的一环。
相关推荐

Qwen 3.8编程击败Opus,你的Mac能跑吗?
Qwen 3.8开源模型在编程测试中击败Opus 4.6,仅18GB大小,但你的Mac需要多少内存?实测显示24GB会崩溃,32GB才是甜点区,本文详解各档Mac配置的实际表现与上手方法。

Claude Code + Agent:打造AI全自动测试闭环
B站课程解读:测试开发如何用 Claude Code 终端型 Agent 打造 AI 全自动测试闭环。对比终端型与设备型 Agent 的权限边界,讲清企业级项目为何选 Claude Code 而非 Open Claude 类工具,并梳理 Node.js 环境准备与 DeepSeek 模型搭配的落地路径。

与AI智能体共事,你需要钢铁般的神经
AI智能体越自主,使用者的心理负担反而越重。本文从Hacker News讨论出发,分析智能体协作中的黑箱焦虑、行为漂移与监控疲劳,并给出沙箱隔离、权限控制、任务粒度管理等降低认知负荷的实用思路。