Mol-JEPA:将JEPA架构引入分子科学的多模态基础模型
引言:分子表征学习的新尝试
近日,一位研究者在Reddit的机器学习社区分享了一项耗时约一年完成的研究成果——Mol-JEPA。这是一个面向分子领域的多模态JEPA(Joint Embedding Predictive Architecture,联合嵌入预测架构)基础模型。作者以谦逊的态度发布了这项工作,并附上了展示核心成果的总结网站,同时坦言"仍有许多提升性能的空间",欢迎社区提供反馈与想法。
这项工作之所以值得关注,不仅在于它将JEPA架构引入分子科学这一相对新颖的应用场景,更在于它采用了"多模态"的思路来理解和表征分子——这为药物发现、材料科学等领域的AI应用开辟了新的探索方向。
JEPA架构的核心原理
从生成式到预测式的范式转变
JEPA(联合嵌入预测架构)是由Yann LeCun等人倡导的一种自监督学习范式。与传统的生成式模型(如自回语言模型或扩散模型)不同,JEPA并不试图在像素级或token级重建原始数据,而是在抽象的表征空间中进行预测。
具体来说,JEPA会对输入数据的一部分进行编码,然后预测另一部分在嵌入空间中的表征,而非直接重建其原始形态。这种方式的核心优势在于:它避免了在无关细节上浪费建模能力,从而学习到更加语义化、泛化能力更强的表征。
值得注意的是,JEPA并非孤立提出的技术方案,而是Yann LeCun在2022年发表的论文《A Path Towards Autonomous Machine Intelligence》中系统阐述的"世界模型"愿景的核心组件。LeCun认为,当前主流的生成式AI(包括大语言模型)本质上是在token层面做模式匹配,缺乏对世界的真正理解。他提出的替代方案是让模型在抽象的表征空间中学习预测,从而构建类似人类心智模型的内部表征。JEPA的早期成功案例包括Meta AI团队开发的I-JEPA(用于图像)和V-JEPA(用于视频),这些工作验证了在表征空间中进行预测确实能学到比像素级重建更具语义价值的特征。正是这些视觉领域的成功经验,为将JEPA扩展到分子科学等其他模态提供了信心和方法论基础。
从更深层的理论视角来看,JEPA在LeCun的框架中与能量基模型(Energy-Based Models, EBM)密切相关。LeCun认为JEPA本质上是一种正则化的潜在变量EBM,通过最小化兼容输入-输出对之间的能量来学习。在传统EBM中,模型需要显式地提升不兼容配置的能量(即对比项),这在高维空间中极其困难。JEPA通过EMA教师网络和信息瓶颈等正则化手段隐式地实现了这一目标,避免了对比学习中需要大量负样本的问题。这一理论视角有助于理解为什么JEPA在分子领域可能比对比学习更具优势——分子的化学空间离散且结构化,难以像图像那样通过简单变换生成有意义的负样本。
在技术实现层面,JEPA架构中一个关键机制是指数移动平均(Exponential Moving Average, EMA)教师网络。在I-JEPA等具体实现中,用于编码目标表征的教师编码器并非独立训练,而是学生编码器参数的指数移动平均——即教师网络的参数在每一步更新时,会按照一定比例(通常0.99以上)保留旧参数,仅缓慢吸收学生网络的最新参数。这种设计巧妙地避免了表征坍塌问题(即所有输入被映射到相同的表征向量),同时为学生网络提供了平滑、稳定的预测目标。这一机制对Mol-JEPA尤为重要,因为分子表征空间相对于自然图像而言更为紧凑和低维,表征坍塌的风险更高。
此外,JEPA与另一大类自监督方法——对比学习(如SimCLR、BYOL、MoCo等)——存在本质区别。对比学习依赖数据增强来构造正负样本对,模型学习将同一样本的不同增强版本拉近、不同样本推远。这种方法在视觉领域取得了巨大成功,但存在一个隐忧:学到的表征可能对增强策略过于敏感,且需要精心设计与领域适配的增强方法。在分子领域,这一问题尤为突出——对分子图的常见增强操作(如随机删除原子、打断化学键或替换子结构)可能破坏分子的化学合理性,导致增强后的分子不再是有效的化合物。JEPA通过预测缺失部分的表征来学习,不依赖显式的数据增强策略,这使其在分子等非视觉领域具有天然的适用优势。
JEPA为何适合分子建模
将JEPA应用于分子领域具有天然的合理性。分子数据本身高度结构化且信息冗余——一个分子的许多局部特征可以从其整体结构推断出来。相比强行重建每一个原子或化学键的生成式方法,在表征空间中预测分子的部分结构,更符合化学直觉,也更有利于捕捉分子的功能性特征。
要理解Mol-JEPA的创新之处,有必要回顾分子领域自监督学习的演进脉络。早期方法以对比学习为主,例如MolCLR通过对分子图施加不同的数据增强来构造正负样本对。随后,掩码预训练策略兴起,典型代表是Grover和GraphMAE,它们通过遮蔽部分原子或化学键并要求模型重建来学习分子表征。然而这些方法普遍面临一个问题:像素级或节点级的重建目标迫使模型在原子类型、键角等低层细节上投入大量建模能力,而这些细节对下游的药物活性预测等任务帮助有限。此外,3D-Infomax等方法还探索了通过最大化2D和3D表征之间的互信息来进行预训练,这是跨模态自监督在分子领域的早期尝试,也可视为Mol-JEPA多模态策略的重要前驱工作——它证明了不同分子表示之间的信息互补确实能提升下游任务性能。JEPA框架通过在抽象空间中预测来规避重建细节的问题,这正是Mol-JEPA的理论出发点——它代表了分子自监督学习从"重建细节"到"预测语义"的范式跃迁。
值得补充的是,分子领域面临一个独特的数据困境,这使得自监督预训练尤为重要。理论上可能存在的类药小分子数量估计在10^60量级(即所谓的化学空间),但人类已合成并表征的分子仅约2亿个,其中具有高质量生物活性标注的更少——例如ChEMBL数据库中约200万个有活性数据的化合物。这种未标注数据丰富但标注数据极度稀缺的格局,恰好是自监督预训练范式大显身手的场景。Mol-JEPA作为自监督基础模型,正是为了利用海量未标注分子数据学习通用表征,再用少量标注数据微调完成特定任务。
Mol-JEPA的多模态融合设计
多模态分子表示的互补价值
Mol-JEPA最突出的特点是其"多模态"属性。在分子科学中,同一个分子可以用多种方式表示:
-
SMILES字符串:将分子表示为文本序列,便于计算机处理。SMILES(Simplified Molecular Input Line Entry System)是1988年由David Weininger提出的分子线性表示法,它将分子的二维拓扑结构编码为ASCII字符串。例如,乙醇表示为"CCO",苯表示为"c1ccccc1"。SMILES的优势在于紧凑高效,可以直接输入NLP模型处理,这也催生了ChemBERTa、MolBERT等基于Transformer的分子语言模型。但SMILES存在固有缺陷:同一分子可以有多种合法的SMILES表示(即非规范性),且字符串无法直接编码三维空间信息。近年来出现的SELFIES(Self-Referencing Embedded Strings)等新型分子表示法试图解决SMILES的非规范性和无效字符串生成问题,但SMILES仍然是分子AI领域最广泛使用的文本表示。
-
分子图:以原子为节点、化学键为边的图结构,反映拓扑关系。处理这类数据的主力工具是图神经网络(GNN),其核心思想是通过消息传递机制,让每个节点迭代地聚合邻居节点的信息来更新自身表征。在分子领域广泛使用的GNN变体包括SchNet、DimeNet(侧重三维几何信息)以及AttentiveFP、D-MPNN(侧重拓扑信息)等。GNN天然适合编码分子的局部化学环境,但在捕捉长程相互作用方面存在过平滑等挑战——随着网络层数增加,所有节点的表征趋于一致,丢失了局部区分信息。为解决这一问题,近年来图Transformer(如Graphormer、GPS)引入全局自注意力机制,试图在保留图结构信息的同时实现长程依赖建模。
-
三维构象:分子在空间中的几何构型,包含立体化学信息。分子的三维构象指原子在三维空间中的具体坐标排布,它对分子的生物活性至关重要——药物分子必须在三维空间中与靶点蛋白的结合口袋实现互补匹配("锁钥模型")。然而,同一分子可能存在多个低能量构象(构象异构体),且构象空间随分子大小呈指数增长。获取三维构象通常依赖于量子力学计算(如DFT密度泛函理论)或分子动力学模拟,计算成本远高于生成二维图或SMILES。这意味着三维数据的规模通常远小于二维数据——例如,公开可用的PubChem数据库收录了超过1.1亿个分子的2D结构和SMILES,而包含高质量3D构象的数据集(如GEOM包含约3700万个构象、QM9仅有约13万个小分子、PCQM4Mv2约380万条记录)规模要小得多。如何在这种数据不均衡的条件下有效融合多模态信息,是Mol-JEPA这类模型面临的实际工程挑战,需要精心设计采样策略和损失函数权重,以避免模型被数据丰富的模态主导。
-
理化性质描述符:各类计算或实验得到的属性数据,如分子量、LogP(脂水分配系数)、极性表面积、氢键供体/受体数量等。这些传统化学信息学描述符虽然信息量相对有限,但具有物理化学含义明确、计算成本低的优势,是对深度学习模型表征的有益补充。
每种模态都从不同角度刻画了分子的特性。单一模态往往难以完整表达分子的全部信息,而多模态融合能够让模型综合利用这些互补的视角,从而获得更全面、更鲁棒的分子表征。这也是Mol-JEPA选择多模态路线的根本原因——在JEPA的表征空间预测框架下,不同模态的信息可以在抽象语义层面自然对齐和互补,避免了在原始数据层面硬性拼接不同格式数据的尴尬。
值得注意的是,多模态对齐本身面临显著的技术挑战。不同模态的信息密度和语义粒度差异巨大:SMILES字符串是一维序列,分子图是拓扑结构,三维构象是连续的欧氏空间坐标——将它们对齐到同一表征空间需要处理维度不匹配、信息量不对等等难题。CLIP模型在文本-图像对齐上的成功经验表明,对比式跨模态对齐在大规模数据下是可行的,但分子领域的挑战在于:不同模态之间的对应关系并非一对一的(一个SMILES对应多个合法的3D构象),且缺乏类似LAION-5B那样大规模的成对多模态分子数据集。JEPA的预测式对齐方法——在表征空间中预测而非在数据空间中对比——可能为这一问题提供新的解决思路,这也是Mol-JEPA在技术路线上的一个重要创新点。
分子基础模型的定位
作者将Mol-JEPA定位为"基础模型"(foundation model),意味着它旨在通过大规模自监督预训练学习通用的分子表征,然后迁移到多种下游任务中——例如分子性质预测、药物-靶点相互作用预测、分子生成等。这种"一次预训练、多处复用"的模式,正是当前AI领域的主流范式在分子科学中的延伸。
基础模型(Foundation Model)概念由斯坦福HAI研究所在2021年正式提出,指在大规模数据上预训练、可适配多种下游任务的大型模型。这一范式从NLP(GPT系列、BERT)和计算机视觉(CLIP、SAM)领域向科学领域的迁移正在加速。在分子与材料科学中,代表性工作包括Meta的ESM系列(蛋白质语言模型,ESM-2拥有150亿参数,在蛋白质结构预测和功能注释等任务上展现了强大的零样本和少样本能力)、Google DeepMind的GNoME(通过图神经网络发现了220万种新型稳定无机材料结构)、以及微软的MoLFormer(在20亿个SMILES上预训练的分子Transformer)等。这些模型的共同逻辑是:利用海量未标注的分子数据进行自监督预训练,学习通用的化学表征,然后在少量标注数据上微调完成特定任务,从而大幅降低对昂贵实验数据的依赖。Mol-JEPA正是在这一宏观趋势下的新探索,其独特之处在于将JEPA这一新型学习范式与多模态融合相结合,试图在分子基础模型的技术路线图上开辟一条差异化路径。
研究意义与现实挑战
在药物发现中的潜在应用
分子基础模型的价值在药物研发领域尤为显著。传统的湿实验成本高昂、周期漫长,而一个高质量的分子表征模型能够在虚拟筛选、先导化合物优化等环节大幅提升效率。将JEPA的高效表征学习能力与多模态信息融合相结合,理论上有望在数据效率和泛化能力上超越现有方法。
具体而言,在药物研发管线中,虚拟筛选(Virtual Screening)是指利用计算方法从百万甚至数十亿量级的化合物库中快速筛选出可能与靶点蛋白结合的候选分子,替代传统的高通量实验筛选。当前主流的虚拟筛选方法包括基于分子对接(docking)的结构基方法和基于机器学习的配体基方法,两者各有优劣,而高质量的分子表征对配体基方法至关重要。筛选出的苗头化合物(hit)经过初步验证后进入先导化合物(lead)优化阶段,研究者需要在保持活性的同时改善分子的药代动力学性质(ADMET,即吸收、分布、代谢、排泄和毒性)。传统药物研发从靶点发现到新药上市平均耗时10-15年、花费超过10亿美元,且临床试验的总体成功率不足10%。
值得关注的是,AI驱动的药物发现已经从概念验证走向实际产出。Insilico Medicine的抗纤维化候选药物INS018_055已成为首个由AI发现靶点并设计分子、进入II期临床试验的药物;Recursion Pharmaceuticals利用大规模细胞图像和分子表征数据构建了覆盖数万化合物的"生物学地图"。这些产业实践证明,高质量的分子表征模型有望将虚拟筛选的命中率从百分之零点几提升数倍,并在先导优化阶段减少合成-测试循环的次数,从而显著压缩研发周期和成本。Mol-JEPA如果能够在这些关键环节证明其表征质量的优势,将具有直接的产业价值。
当然,从学术研究走向产业应用还需要跨越监管层面的考量。FDA在2023年发布的指导文件开始探讨AI/ML在药物开发中的应用框架,EMA(欧洲药品管理局)也设立了专门的AI工作组。监管机构关注的核心问题包括:AI模型的可解释性(为何预测某化合物有效)、训练数据的质量与偏见、以及模型预测结果的可验证性。对于Mol-JEPA这类在抽象表征空间中进行预测的基础模型而言,如何在保持预测性能的同时提供化学可解释的表征——例如通过注意力可视化揭示模型关注的关键子结构,或通过表征空间分析展示化学相似分子的聚类模式——将是其从学术研究走向产业应用的关键考量。
需要客观看待的局限
你可能没注意到,作者本人也明确指出该模型"仍有许多改进性能的工作要做"。作为一项由个人历时一年完成的研究,Mol-JEPA目前更多是一次有价值的架构探索和概念验证,而非成熟的产业级解决方案。其真实性能表现、与现有主流分子模型(如各类GNN、分子Transformer)的对比优势,仍有待更广泛的基准测试和社区验证。
当前分子AI领域的主流模型大致可分为三个流派:基于GNN的方法(如SchNet、DimeNet++、Uni-Mol等),擅长处理分子图和三维几何结构;基于Transformer的方法(如MolBERT、ChemBERTa、MoLFormer等),将SMILES视为自然语言进行处理;以及混合方法(如GEM、Graphormer),试图兼顾图结构感知和全局注意力机制的优势。在主流基准测试中,MoleculeNet(包含17个分子性质预测数据集,涵盖物理化学、生物物理、生理学等多个维度)和OGB-LSC(Open Graph Benchmark Large Scale Challenge,包含数百万量级分子的大规模图学习挑战赛)是最常用的评估标准。在这些基准上,各方法各有所长:GNN在小分子性质预测上通常表现优异,Transformer在大规模数据上展现出更好的扩展性,混合方法在部分任务上取得了最优结果,但尚未出现压倒性的统一方案。Mol-JEPA的独特之处在于它不属于上述任何一个流派,而是引入了全新的学习范式——在表征空间中跨模态预测,这可能为突破现有方法的性能瓶颈提供新思路,但也意味着它需要在这些成熟的基准上证明自己。
此外,作为来自Reddit社区的单一来源分享,这项工作的具体实验细节和可复现性也需要读者结合其公开的总结网站进行进一步核实。值得一提的是,开源和可复现性正日益成为分子AI社区评价工作价值的重要标准——Papers with Code、Hugging Face等平台推动了模型和数据集的开放共享,这有助于社区对Mol-JEPA等新工作进行快速验证和迭代。
开放科学精神的生动实践
Mol-JEPA的发布方式本身也颇具代表性——研究者主动在开放社区分享成果、公开项目网站、诚恳寻求反馈。这种开放协作的科研态度,正是推动AI与科学交叉领域快速进步的重要动力。事实上,分子AI领域的许多重要进展都得益于开放科学生态:RDKit(开源化学信息学工具包)为几乎所有分子AI研究提供了基础设施,DeepChem和PyG(PyTorch Geometric)等开源框架大幅降低了分子深度学习的入门门槛,而MoleculeNet等公开基准的建立使不同方法的公平比较成为可能。Mol-JEPA选择在Reddit这样的开放平台首发,而非等待传统学术会议的审稿周期,也反映了AI研究领域"预印本优先、社区验证"的新型科研传播模式。
对于关注AI4Science、分子表征学习或JEPA架构的研究者和从业者而言,Mol-JEPA提供了一个值得跟进的探索案例。它或许还不完美,但代表了将前沿自监督学习架构引入化学领域的有益尝试。感兴趣的读者可以访问作者提供的项目网站深入了解其技术细节与实验结果。
核心要点
核心要点
核心要点
相关推荐
tiun.:为AI开发者打造的一站式认证与支付系统
登顶 Product Hunt 的 tiun. 为 AI 开发者提供认证、支付、账单、客户数据与分析的一体化系统,一条命令即可安装,帮助开发者当天上线付费产品。本文解析其定位、卖点与竞争格局。
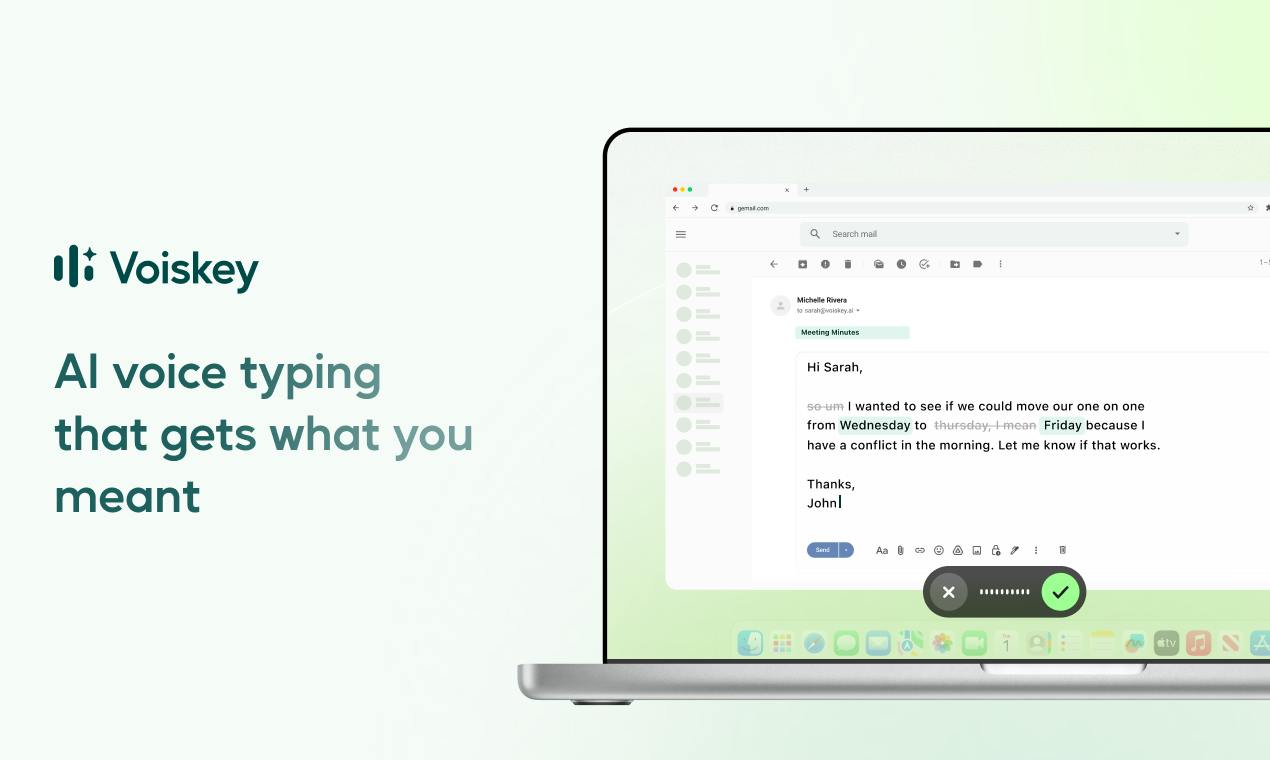
Voiskey:能读懂语境的AI语音输入工具
Voiskey是一款登上Product Hunt排名第3的AI语音输入工具,能根据场景和读者自动调整语气,比打字快5倍,支持iOS、macOS、Android、Windows四大平台及100多种语言。
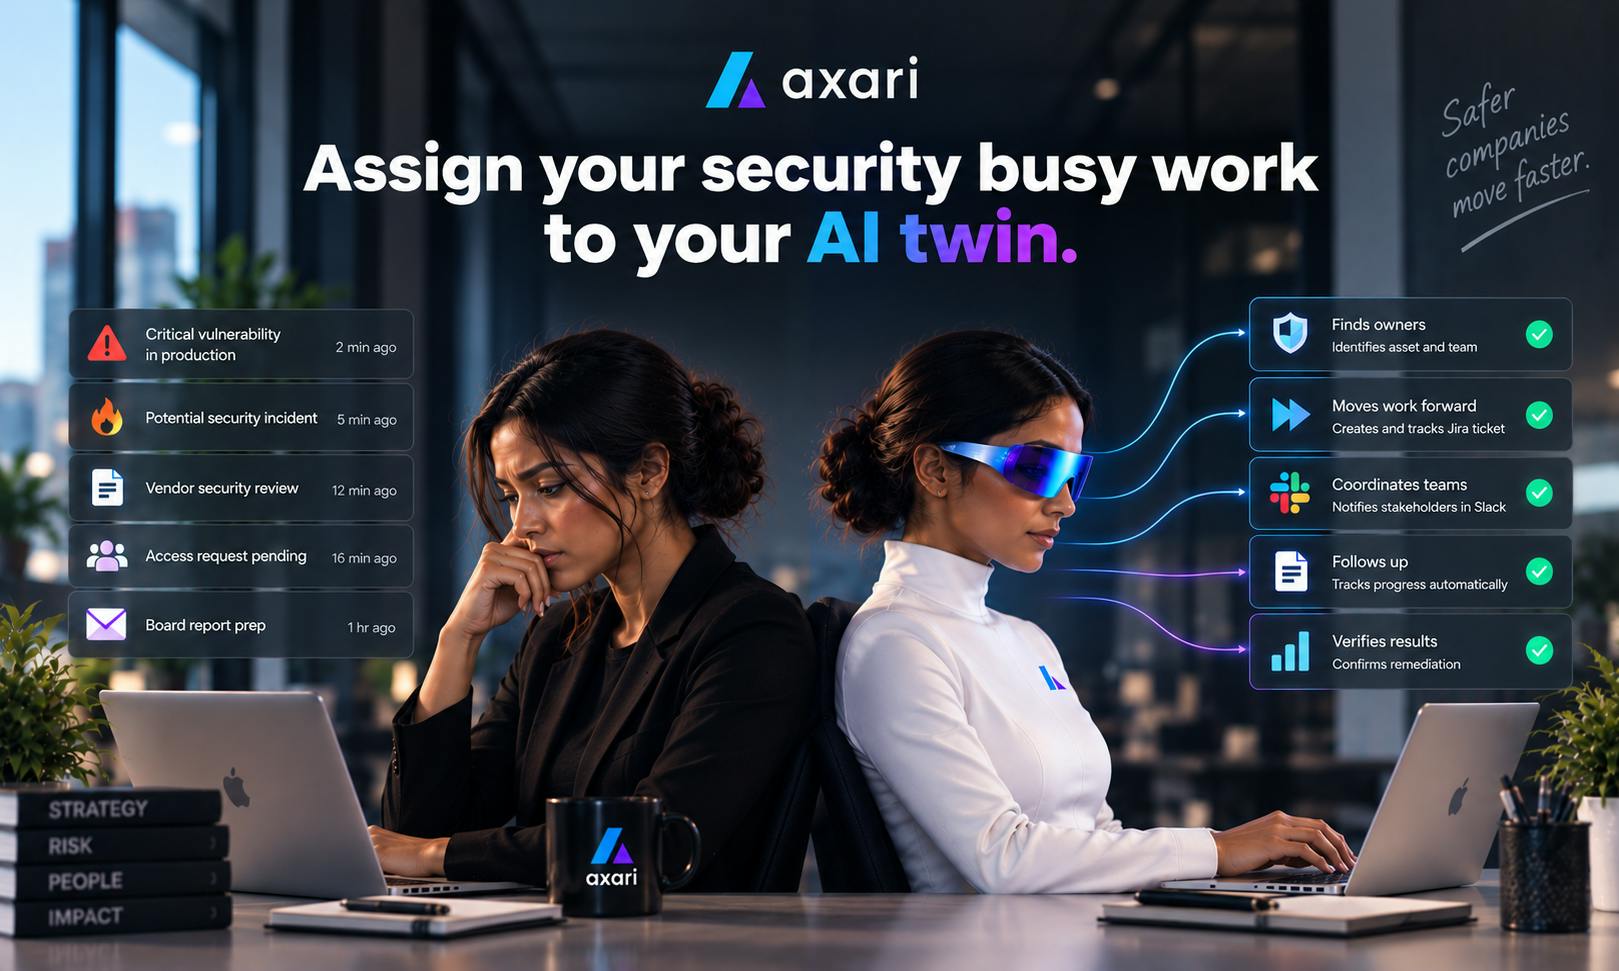
Axari:让AI分身接管你的安全运营琐事
Product Hunt新品Axari主打「AI分身」概念,帮安全团队自动处理重复性运营琐事,可在Slack、MS Teams中指派目标并自主推进任务。本文解析其产品逻辑、行业定位与需要冷静看待的问题。