Moshi如何用AI将市场数据转化为交易洞察
Moshi团队分享金融AI落地关键:场景适配优于技术堆砌。
Moshi是一家将AI应用于金融市场的公司,其核心产品帮助交易员将海量市场数据转化为可执行洞察。在与Anekha Sokhal的对话中,团队强调AI工具不能只追求“聪明”,更要无缝融入交易员的工作流。文章从Moshi的转化逻辑出发,指出AI应承担信息聚合与初步筛选,将决策判断留给交易员;同时分析了交易场景对延迟和认知负荷的敏感性,说明AI工具必须贴合现有流程而非替代。最后提出金融AI竞争正从数据规模转向场景深度理解,AI应定位为团队协作的一员。
当AI成为交易员的“队友”
Moshi 是一家将人工智能应用于金融市场的公司,其核心产品帮助交易员把海量市场数据转化为可执行的洞察。在与 Anekha Sokhal 的对话中,Moshi 团队分享了他们的产品理念:AI 工具不能只是“聪明”,更要无缝融入交易员的工作流。这一观点揭示了金融AI落地的一个关键矛盾——技术能力与场景适配之间的鸿沟。
数据到洞察:Moshi的转化逻辑
Moshi 的做法并非简单地生成市场分析报告,而是将数据处理嵌入到交易决策的每一个环节。交易员面对的是实时行情、新闻流、历史模式等多源异构信息,传统工具往往让信息碎片化地散落在不同终端。Moshi 的思路是:让 AI 承担信息聚合与初步筛选的工作,把交易员的注意力留给真正需要判断的决策点。
这种设计背后的假设是,交易员的核心价值不在于处理数据,而在于对不确定性的判断。AI 如果只是重复交易员已能完成的分析,就无法产生增量价值;只有当它能把“数据噪音”压缩成“信号”,才真正成为团队的一员。
多源异构信息指的是来自不同渠道(如实时行情、新闻推送、社交媒体、财报文件、历史交易记录等)、具有不同格式(结构化表格、非结构化文本、时间序列、图像等)和不同更新频率的数据集合。在交易场景中,这类信息的挑战不仅在于数据量大,更在于它们分散在不同系统、语义不一致、时间粒度各异,交易员难以快速整合出统一的市场视图。将多源异构信息进行对齐、清洗和聚合,是AI辅助交易决策的首要技术环节,也是决定AI输出质量的基础。
为什么AI工具必须贴合工作流
对话中反复强调的一点是:AI 工具的价值取决于它是否“顺手”。交易场景对延迟和认知负荷极为敏感,一个需要切换窗口、学习新操作逻辑的AI工具,即便功能强大,也可能被弃用。Moshi 将产品定位为交易员现有流程的延伸而非替代——这意味着在界面、响应速度和交互方式上都要服从交易场景的约束。
这个判断对更广泛的AI产品都有借鉴意义。企业级AI的成功往往不取决于模型参数,而取决于它是否降低了用户的操作成本。在金融这类高风险、高节奏的领域,这一点被放大得尤为明显。
认知负荷(Cognitive Load)是认知心理学中的概念,指人在处理信息时工作记忆所承受的负担。交易员在实时决策中需要同时跟踪价格变动、新闻事件、仓位风险和指令执行,认知资源本就紧张。任何额外的界面学习、窗口切换或操作步骤都会挤占本已有限的注意力。因此,AI工具若要在交易场景中存活,必须尽可能降低而非增加认知负荷——例如通过上下文感知自动推送相关信息、减少手动输入、保持交互习惯的一致性。这一原则同样适用于其他高频、高压的专业工作场景。
对金融AI赛道的启示
Moshi 的案例提供了一个观察角度:金融AI的竞争正在从“谁的数据多”转向“谁的理解深”。市场数据本身是公开的,差异在于如何针对特定交易风格和工作流进行定制化处理。这种深耕场景的策略,可能比通用型AI助手更能在专业市场中建立壁垒。
同时,这也意味着AI产品团队需要具备双重能力——既要懂模型,也要懂交易员的真实痛点。Anekha Sokhal 对话中“You are the Team”的表述,恰恰点出了这种人机协作的定位:AI 不是外挂工具,而是团队协作中的一员。
垂直领域AI与通用型AI助手的差异在于:通用助手追求广覆盖和泛化能力,而垂直AI追求在特定场景中的深度适配。金融交易领域具有高度专业化的术语体系、严格的合规要求和极低的容错空间,通用模型往往难以直接满足这些约束。深耕场景的策略意味着将领域知识(如交易规则、风控逻辑、市场微观结构)嵌入产品设计,使AI的输出更贴合专业用户的实际决策路径。这种策略的壁垒不在于数据规模,而在于对工作流的理解深度和长期积累的场景经验,后来者难以通过单纯扩大数据量来快速复制。
小结
Moshi 的实践说明,金融AI的落地关键在于场景适配而非技术堆砌。将市场数据转化为行动洞察,需要 AI 在正确的时间、以正确的方式介入交易员的工作流。这一思路对其他垂直领域的AI产品同样适用:工具的价值,最终由使用它的人来定义。
相关推荐
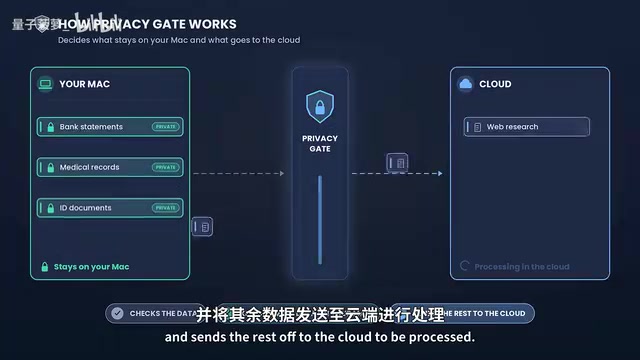
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
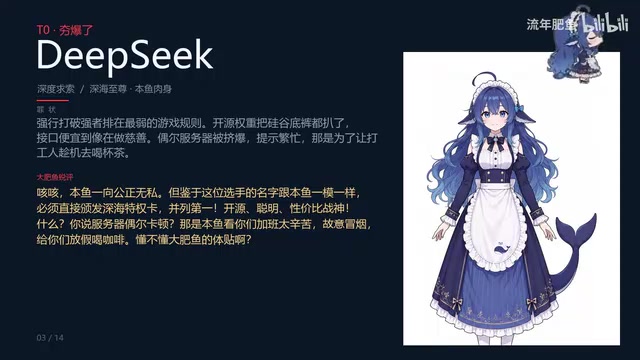
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。