MOSS-VL-Realtime实测:110亿参数实时视频理解,消费级显卡可跑
MOSS-VL-Realtime实测:110亿参数实时视频理解,消费级显卡可跑
摩斯智能推出的MOSS-VL-Realtime,以110亿参数和开放权重的形式,为视频理解带来了全新的交互方式。与传统视频问答模型"先看完再回答"的逻辑不同,这款实时版模型能在视频播放过程中持续理解画面,动态生成描述并即时回答问题。这一能力定位使其有别于当前主流的多模态大模型——大多数开源视频理解模型(如Video-LLaVA、LLaVA-NeXT-Video等)仍然沿用"全量输入-一次推理"的架构,而MOSS-VL-Realtime则将流式处理的理念引入了视频多模态领域。
实时理解:从"看完再说"到"边看边答"
传统视频问答模型(如VideoQA类任务)通常采用"离线处理"范式:先对整段视频进行特征提取,将所有帧编码为固定维度的表征向量,再结合文本问题进行推理。具体而言,这类模型往往使用均匀采样或关键帧提取策略从视频中选取若干帧,通过视觉编码器(如CLIP-ViT)将每帧映射为向量表示,然后通过时序聚合模块(如平均池化、时序Transformer或Q-Former)将多帧信息压缩为一个全局的视频表征,最终输入到语言模型中生成答案。这种方式本质上是对已完成事件的回顾分析,必须等整段视频播放完毕才能输出结果。
MOSS-VL-Realtime打破了这一限制,采用更接近人类视觉认知的"在线处理"范式——大脑并不会等一段场景完全结束后才开始理解,而是在信息持续输入的过程中不断建构、修正对当前情境的认知模型。认知科学中的"预测编码"(Predictive Coding)理论指出,人脑视觉系统会在每一刻对接下来即将看到的内容做出预测,当实际输入与预测不符时才触发更强的神经响应和认知更新。MOSS-VL-Realtime的在线处理范式在理念上与此相似——模型维护着一个对当前场景的动态理解,只在画面出现显著变化时才触发输出更新。
测试中,模型能实时识别咖啡店场景、进门的人物、柜台前的交谈等连续画面,文字描述随视频推进持续生成和更新。这种从离线到在线的转变,在技术上要求模型具备增量推理能力,即在不重新处理全部历史信息的前提下,将新帧的视觉特征融入已有的语义表征中。增量推理的关键挑战在于:模型需要在有限的计算预算内完成"新信息整合",而不是像离线模型那样可以对全部历史帧进行完整的交叉注意力计算。这通常要求模型具备某种形式的记忆压缩机制——将已处理帧的关键信息浓缩为紧凑的状态表示,使得处理新帧时的计算复杂度不会随历史长度无限增长。
这种能力依赖三个关键特性:
- 边看边答:新画面进入时,理解和文字生成同步进行
- 主动沉默:画面证据不足时,模型选择保持沉默,避免错误判断
- 动态更新:后续画面改变情境时,模型能补充或修正此前的判断
实际测试中,视频播放到约10秒时插入"现在画面里有几个人"的问题,模型先回答"两个人";7秒后柜台后的店员进入画面,模型无需再次提问即主动将答案更新为"三个人"。这种动态感知能力正是实时版本的核心价值所在。从技术角度来看,这种主动更新行为意味着模型内部维护了某种"未完成推理"的状态——它不仅记住了用户的问题,还在持续将新帧信息与这个悬挂问题进行匹配,一旦检测到与之相关的场景变化就触发答案修正。这种机制远比简单的"问一次答一次"要复杂得多,本质上是将对话状态管理与视觉流处理进行了深度耦合。
消费级显卡部署:双4070Ti Super跑通全流程
官方提供4比特量化版本,按单张RTX 4090设计。量化(Quantization)是模型压缩的核心技术之一,其原理是将模型参数从高精度浮点数(如FP16的16位)压缩到更低位宽的表示。4比特量化意味着每个权重参数仅用4个二进制位存储,相较于FP16理论上可将模型体积压缩至约四分之一。
目前主流的4比特量化方案包括GPTQ、AWQ和GGUF等,它们通过不同的校准策略和分组量化技术,在大幅减少显存占用的同时尽可能保持模型精度。具体而言,GPTQ(Generative Pre-trained Transformer Quantization)基于最优脑量化框架,通过逐层校准的方式最小化量化误差,在GPU上推理效率较高;AWQ(Activation-aware Weight Quantization)则观察到模型中并非所有权重同等重要,而是根据激活值分布来保护关键权重通道,通常在相同比特数下能保留更高精度;GGUF则是llama.cpp生态中广泛使用的格式,支持CPU+GPU混合推理,灵活性更强。不同量化方案的选择需要在推理速度、精度保持和部署灵活性之间进行权衡。
对于110亿参数的模型而言,FP16精度下需要约22GB显存仅存放权重(110亿 × 2字节 = 22GB),而4比特量化后权重占用可降至约5.5GB(110亿 × 0.5字节 = 5.5GB),加上推理时的KV缓存和中间激活值,总显存需求降至消费级显卡可承受的范围。值得注意的是,量化并非没有代价——4比特量化相较于FP16通常会导致0.5-2%的基准测试精度下降,在某些需要精细数值推理的任务上影响可能更大,但对于视频场景描述和问答等任务,这种精度损失在实际体验中通常难以察觉。
本次测试采用两张RTX 4070Ti Super,让程序自动拆分模型负载。RTX 4070Ti Super基于NVIDIA Ada Lovelace架构,单卡配备16GB GDDR6X显存,CUDA核心数为8448,显存带宽672GB/s。相较于RTX 4090的24GB显存和16384个CUDA核心,4070Ti Super在显存容量和计算吞吐上都有明显差距,但其价格仅为4090的一半左右,性价比优势显著。
这种多GPU部署采用的是模型并行(Model Parallelism)策略——当单张显卡的显存无法容纳完整模型时,将模型按层或按矩阵维度拆分到多张显卡上。模型并行主要分为两种方式:张量并行(Tensor Parallelism)将单个矩阵运算拆分到多张卡上同时计算,每次前向传播都需要跨卡通信;流水线并行(Pipeline Parallelism)则将模型按层分段,数据依次流过各段。本次测试大概率采用了流水线并行方式,即模型的前半部分层放在第一张卡上,后半部分层放在第二张卡上,数据在两张卡之间按顺序流动。对于推理场景,流水线并行的效率损失相对可控,尤其是在连续流式推理时,前后层的计算可以形成较好的流水线重叠——当第二张卡处理第N帧数据的后半部分时,第一张卡已经可以开始处理第N+1帧数据的前半部分,从而隐藏跨卡传输延迟。
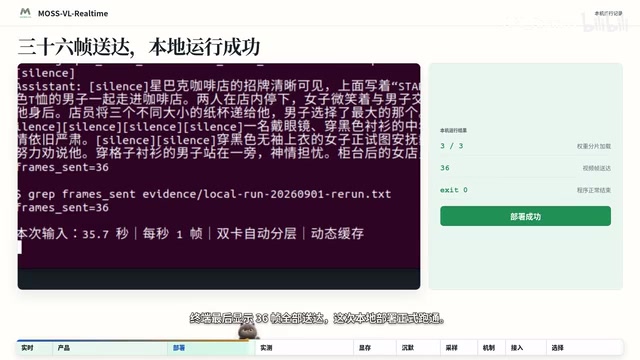
部署流程清晰顺畅:
- 拉取仓库并创建独立环境
- 安装运行依赖
- 下载官方量化权重(三个分片)
- 启动实时推理程序
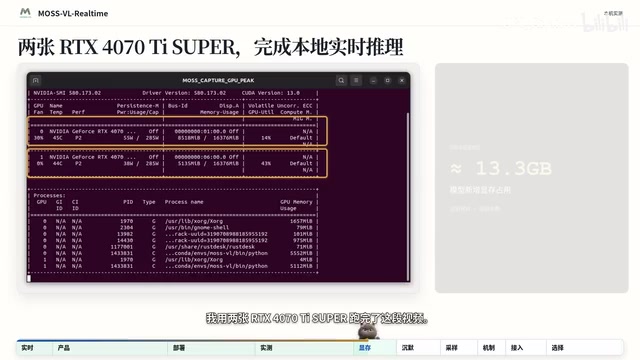
扣除系统基础占用后,模型额外使用的显存约为13.3GB。这个数据表明双4070Ti Super(合计32GB显存)完全可以胜任本地实时推理任务,模型占用约13.3GB仅为总可用显存的41.6%,留有充足的余量用于KV缓存增长和更长视频的处理。这为消费级显卡用户提供了具体的硬件参考,也意味着即便是单张RTX 4090(24GB显存)也能轻松承载这一负载。
技术架构:256K上下文与动态采样机制
官方标注的256,000上下文长度并非固定的视频时长上限,而是单次可参考的信息容量。上下文长度(Context Length)是大语言模型单次推理能够处理的最大token数量,256K即262,144个token,在当前开源多模态模型中属于较大的上下文窗口。作为对比,主流开源多模态模型的上下文长度通常在4K到32K之间,如LLaVA-1.5为4,096 token,Qwen-VL为8,192 token,而InternVL2扩展到了32K。256K的上下文容量意味着MOSS-VL-Realtime在理论上能处理的信息量是这些模型的8到64倍,这对于长视频理解而言是至关重要的基础能力。
对于视频理解任务,每一帧图像经过视觉编码器(通常基于ViT架构的视觉Transformer)处理后会被转化为一组视觉token。ViT(Vision Transformer)的工作原理是将输入图像切分为固定大小的图块(patch),每个patch经过线性投影后被视为一个token,再通过多层Transformer编码器提取特征。以常见的ViT-L/14为例,对于224×224的输入图像,每个patch为14×14像素,共产生16×16=256个视觉token。一帧图像通常产生数百个token,具体数量取决于图像分辨率和patch大小的设定。部分模型还会通过视觉token压缩模块(如Perceiver Resampler或MLP投影层)将每帧的token数量从数百个压缩到几十个甚至更少,以降低长视频场景下的上下文压力。
因此256K的上下文容量本质上是一个"信息预算"——采样帧数、每帧的视觉token数、用户对话的文本token数三者共同竞争这个预算。假设每帧经压缩后产生64个视觉token,那么256K的预算理论上最多可容纳约4,000帧(留出部分空间给文本token),在每秒1帧的采样率下可支持超过1小时的视频。但如果每帧保留256个原始视觉token,可容纳帧数则降至约1,000帧,对应约16分钟的视频。
实现如此超长的上下文通常依赖位置编码的外推技术。标准的RoPE(Rotary Position Embedding,旋转位置编码)在训练时使用固定的上下文长度,直接外推到更长序列时性能会显著下降。NTK-aware扩展通过调整RoPE的基频参数来实现无损或低损的位置外推,其核心思想是在不改变近距离位置关系的前提下扩展远距离位置的编码能力。YaRN(Yet another RoPE extensioN)则进一步结合了NTK插值和注意力缩放,在多个基准上展现出更稳定的长序列性能。此外,高效的注意力计算机制如FlashAttention也是必不可少的——标准自注意力的时间和空间复杂度为O(n²),对于256K长度的序列,朴素实现的显存需求将达到数百GB,而FlashAttention通过分块计算和kernel融合将显存复杂度降低到O(n)级别,使得超长上下文推理在消费级硬件上成为可能。
实际可处理的视频时长取决于多个因素:
- 采样密度:每秒抽取的帧数越多,单位时长消耗的上下文越大
- 对话长度:问答交互越频繁,可容纳的视频时长相应减少
- 画面复杂度:复杂场景可能需要更多信息编码
测试采用每秒1帧的采样率,对一段30多秒的咖啡店视频(共36帧)进行完整处理。在实时视频推理中,每秒采样帧数(FPS)直接决定了信息的时间分辨率和计算负载之间的平衡。每秒1帧意味着两帧之间间隔1秒,足以捕捉大多数场景级变化(如人物进出、场景切换),但会遗漏持续时间不足1秒的瞬时动作。作为参考,人类视觉系统的时间分辨率约为每秒24-30帧(电影帧率),但对于语义级别的场景理解,研究表明每秒2-4帧通常已经足够捕捉大多数有意义的事件边界。每秒1帧的选择是在极致节约计算资源的条件下能接受的最低时间分辨率。
模型先识别门店和进场人物,随后描述男子走向柜台、店员递出纸杯,最后跟踪后续的人物互动。整个输出随视频推进持续补充,而非最终一次性生成。
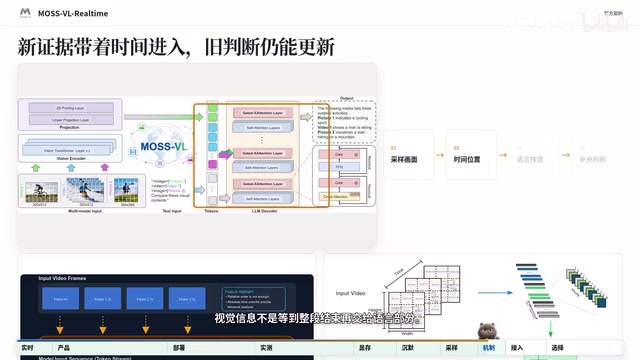
模型的输入采用持续更新机制:视觉信息不等整段结束再交给语言部分,每个采样画面都带有自己的时间位置信息,因此事件先后顺序和状态变化能够纳入同一段推理过程。这种设计意味着时间信息被显式编码到了模型的输入中——每帧不仅携带空间维度的视觉特征,还通过时间戳嵌入标记了其在视频流中的绝对或相对位置。这使得模型能够区分"3秒前看到的画面"和"刚刚看到的画面",从而正确理解事件的因果关系和时序逻辑。
与此同时,Transformer模型在自回归生成过程中需要维护KV缓存(Key-Value Cache),即存储所有已处理token的注意力键值对以避免重复计算。在自回归解码中,每生成一个新token都需要计算它与所有历史token之间的注意力权重。如果没有KV缓存,每生成一个token就需要重新处理整个输入序列,计算量将随输出长度呈平方级增长。KV缓存通过保存已计算的Key和Value矩阵,将每步解码的增量计算降低到仅涉及新token,但代价是显存占用随序列长度线性增长。对于256K上下文的模型,KV缓存本身可能占用数GB显存。
随着视频持续播放,KV缓存会线性增长,这不仅占用显存,还会导致每次生成新token时注意力计算的复杂度持续上升。如何在长时间视频流中有效管理KV缓存是实时视频理解模型面临的关键工程挑战。目前业界探索的方案包括:滑动窗口注意力(仅保留最近N个token的KV缓存,丢弃更早的信息)、重要性采样(通过注意力分数评估每个token的重要性,选择性保留高重要性token的缓存)、以及StreamingLLM提出的"注意力汇聚"(Attention Sink)机制——研究发现模型会将大量注意力分配给序列最开始的几个token,因此保留这些"锚点token"加上最近的滑动窗口,就能在极大压缩缓存的同时维持模型的生成质量。
实际应用:优势与局限并存
核心优势
MOSS-VL-Realtime的差异化价值体现在实时交互能力上:
- 即时反馈:视频进行中就能获得问题答案,无需等待播放结束
- 场景适配:支持本地视频、摄像头、屏幕捕获和外部视频帧输入。这四种输入模式覆盖了从离线分析到实时监控的完整应用谱系——本地视频适合回顾分析,摄像头输入可用于安防或实验观察,屏幕捕获支持桌面操作监控和自动化辅助,外部视频帧输入则为开发者提供了灵活的API级集成能力
- 应用潜力:可作为直播辅助、实验观察、流程提醒或屏幕任务监控的视觉底座
测试中还发现一个值得关注的特性:画面没有明显变化时,终端不会继续输出重复描述,后续人物进入后文字才重新出现。这种"主动沉默"机制在多模态模型中具有重要意义。传统语言模型在被提示后倾向于总是生成输出——即便信息不足也会"幻觉"式地编造内容。"幻觉"(Hallucination)是大语言模型领域的核心挑战之一,指模型生成看似合理但事实上错误或无根据的内容。在视频理解场景中,幻觉可能表现为描述实际并未发生的动作、识别画面中并不存在的物体,或在场景无变化时编造虚假的事件描述。这在实时视频理解场景中尤为危险,因为持续不断的输入流中必然存在大量冗余或无意义的时刻。
主动沉默机制本质上是一种输出门控策略,模型需要学会判断"当前是否有值得报告的新信息"。这可能通过特殊的控制token实现:当模型判断画面无显著变化或证据不足时,生成特定的静默标记而非常规文本。从训练角度来看,这种能力的获得可能依赖于精心设计的训练数据——在视频标注中,不仅要为有意义的时刻标注描述文本,还要为"无事发生"的片段显式标注静默信号,让模型学会区分"有值得说的"和"没什么好说的"两种状态。这种设计与"负样本学习"理念相关——模型不仅要学会"何时说什么",更要学会"何时不说"。该机制有效避免了无效输出,但原始接口会把这种状态写成控制标记,实际部署时需要在应用层做过滤处理。
现实约束
理解技术边界同样重要:
- 采样遗漏:每秒1帧的采样率会漏掉短暂动作,测试中一个快速击打动作就未被稳定识别。这是时间分辨率与计算成本之间不可避免的权衡——提升到每秒2帧可以将捕捉窗口缩短至0.5秒,但相应的token消耗和KV缓存压力也会翻倍。在实际应用中,可以考虑自适应采样策略:当检测到画面光流(Optical Flow)变化超过阈值时自动提升采样率,在静态场景时降低采样率,从而在不大幅增加平均计算负载的前提下提升对快速动作的捕捉能力
- 上下文压力:提高采样频率可保留更多细节,但同时增加输入和缓存负担。当视频流持续时间超过上下文窗口容量时,模型必须在"丢弃早期信息"和"降低采样率"之间做出取舍。这本质上是一个信息管理问题——理想的解决方案是建立分层记忆机制:近期帧保持高分辨率的详细记忆,较早的帧被压缩为摘要式的语义记忆,类似人类大脑中短期记忆和长期记忆的分工
- 应用层补充:告警规则、权限控制和人工复核仍需由应用层实现。模型提供的是视觉理解能力,而非端到端的应用解决方案。在生产环境中,还需要考虑多路视频流的并发处理、推理结果的结构化输出(如JSON格式的事件检测结果)、以及与现有业务系统的API对接等工程问题
系列定位:选择适合场景的版本
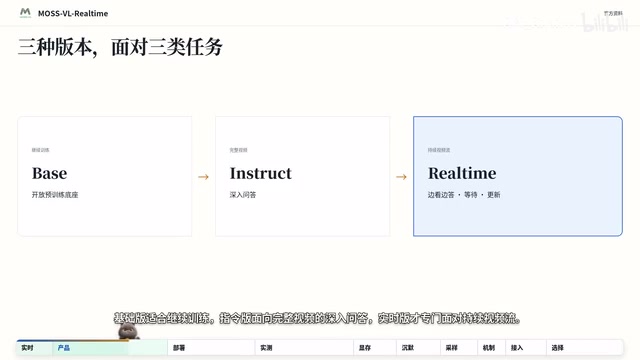
MOSS-VL系列包含三个版本,各有侧重:
- 基础版:适合继续训练和微调,为研究者和开发者提供可定制的基座模型。基座模型(Base Model)通常仅经过大规模预训练而未进行指令微调,保留了最大的可塑性。研究者可以使用LoRA(Low-Rank Adaptation)等参数高效微调技术,以极低的训练成本将基座模型适配到特定垂直领域——如医学影像分析、工业质检或体育赛事理解等
- 指令版:面向完整视频的深入问答,适合视频结束后的总结分析。该版本可以充分利用全部视频信息进行全局推理,在需要综合理解整段内容的场景中表现更优。所谓"全局推理"是指模型可以在回答问题时同时参考视频开头和结尾的信息,进行跨时间段的因果推理和信息整合,这在总结、归纳类任务中至关重要
- 实时版:专门处理持续视频流,适合需要实时观察、提问和动态判断的场景。其核心设计目标是低延迟和增量推理,牺牲了部分全局分析深度以换取即时响应能力。这种取舍在计算机系统设计中普遍存在——就像数据库中OLTP(在线事务处理)和OLAP(在线分析处理)的分工一样,实时处理和深度分析往往难以在同一架构中同时达到最优
如果任务只是等视频结束后做总结,指令版更直接高效。只有需要在视频进行中持续观察、根据新画面更新判断时,实时版才真正对口。在一些复杂场景中,也可以考虑两个版本的组合使用:实时版负责在线监控和即时告警,指令版在事后对关键时段进行深入分析和报告生成。
总结
MOSS-VL-Realtime以110亿参数和开放权重,为实时视频理解提供了可落地的技术方案。双4070Ti Super的成功部署验证了消费级硬件的可行性,边看边答、主动沉默和动态更新三项特性则清晰展示了实时理解的独特价值。
采样遗漏和上下文压力是目前明确存在的技术边界,但对于直播监控、实验观察、流程提醒等需要即时反馈的场景,这个模型提供了全新的交互可能。从更宏观的行业视角来看,MOSS-VL-Realtime代表了多模态AI从"工具型"向"助手型"演进的重要一步——它不再要求用户准备好完整的输入后等待结果,而是能够像一个持续在线的观察者一样与用户协同工作。随着硬件性能的持续提升和模型压缩技术的不断成熟,这种实时视频理解能力有望从技术验证走向广泛的实际部署。
选对版本、理解边界、配合应用层补充,才能真正发挥其价值。
核心要点
相关推荐

对抗AI代码腐化:规格、结果笔记与文件清单的实战方法
一位开发者用八个月、650次提交、4.3万行代码的实战,总结出防止AI智能体代码库腐化的方法:前置规格与验收标准、任务结果笔记、文件清单约束,以及用触发式钩子取代规则文件。核心洞察是——指令只是建议,机制才能在长会话中存活。

"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。