Muon-RT:复用教师轨迹,实现无动量LLM自蒸馏

Muon-RT复用EMA教师与学生间的参数位移替代Muon独立动量缓冲,省显存且提准。
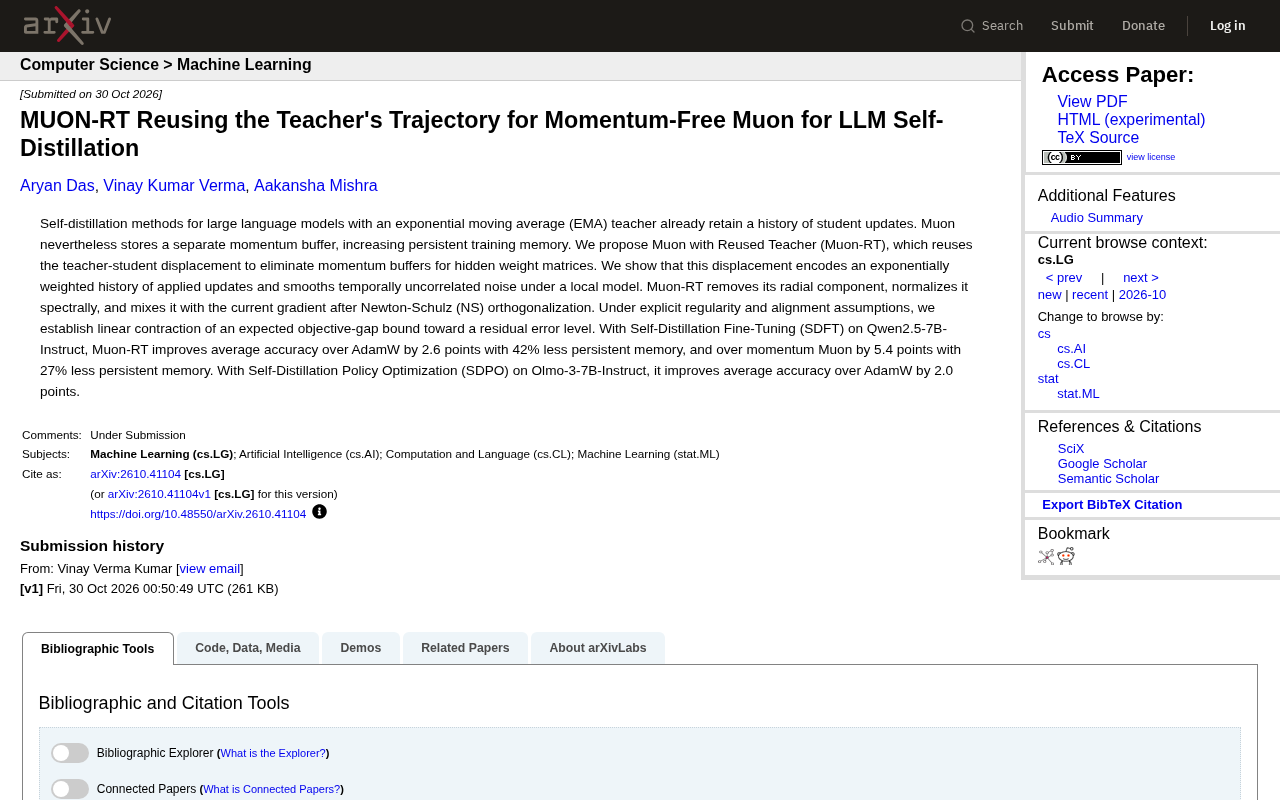
文章介绍了一项名为Muon-RT的优化器改进工作。其出发点是:在基于EMA教师的自蒸馏框架中,教师参数本身已是学生历史更新的指数加权累积,因此Muon优化器额外维护的独立动量缓冲存在冗余。Muon-RT复用教师-学生位移作为动量替代信号,经去径向分量、谱归一化,并在Newton-Schulz正交化后与当前梯度混合,从而在不增加持久状态的前提下获得动量的平滑效果。论文在正则性与对齐假设下证明了期望目标差距界线性收缩。实验显示,在SDFT+Qwen2.5-7B-Instruct上较AdamW准确率提升2.6点、持久内存减少42%,较带动量的Muon提升5.4点、内存减少27%;在SDPO+Olmo-3-7B-Instruct上较AdamW提升2.0点,体现出跨范式适用性。
自蒸馏(Self-Distillation)已成为提升大语言模型性能的重要技术,而指数移动平均(EMA)教师模型本身已经保留了学生模型的历史更新信息。然而,主流的Muon优化器仍然额外维护一个独立的动量缓冲区,这带来了持续的显存开销。近期一篇研究提出了Muon-RT,通过复用教师与学生之间的位移来消除隐藏权重矩阵的动量缓冲,为自蒸馏训练提供了一条更省内存的路径。
核心思路:用教师轨迹替代动量缓冲
研究者的出发点很直接:在基于EMA教师的自蒸馏框架中,教师模型本质上是学生模型参数更新的指数加权历史。既然如此,优化器再单独存储一份动量缓冲就显得冗余。Muon-RT的核心操作是复用教师-学生之间的参数位移(displacement),将其作为动量的替代信号。
论文指出,这一位移编码了已应用更新的指数加权历史,并在局部模型假设下能够平滑时间上不相关的噪声。换句话说,教师轨迹本身就具备动量所期望的"历史平滑"特性,只是此前没有被优化器直接利用。
具体实现:去径向、谱归一化与梯度混合
Muon-RT的处理流程包含几个关键步骤。首先,它对教师-学生位移去除径向分量(radial component),随后进行谱归一化(spectral normalization),最后在Newton-Schulz(NS)正交化之后将其与当前梯度混合。这一设计与Muon原有的NS正交化流程保持兼容,改动集中在动量项的来源上而非整体优化框架。
这种"借用"而非"新建"的思路,使得Muon-RT在不增加额外持久状态的前提下获得了类似动量的平滑效果。
指数移动平均(EMA)教师:在自蒸馏中,EMA教师是一份学生模型权重的滑动平均副本,每一步按 (\theta_t^{\text{tea}} = \beta\theta_{t-1}^{\text{tea}} + (1-\beta)\theta_t^{\text{stu}}) 更新。由于 (\beta) 通常接近 1,教师参数是学生历史更新的指数加权累积,天然携带“过去若干步参数走向”的信息。这正是一阶动量 (m_t = \mu m_{t-1} + g_t) 所编码的同类信号,只是动量在梯度空间累积,而教师位移在参数空间累积。理解这一点,就能明白为何复用教师-学生位移在信息论意义上并不比动量缓冲少——区别在于前者作为已有状态“免费”存在,后者需要额外分配显存。
持久内存(persistent memory):指训练过程中长期驻留、不随计算图释放的显存占用,典型如优化器状态(AdamW 的 (m) 与 (v)、Muon 的动量缓冲)和模型副本(EMA 教师)。它与激活值等临时显存不同,规模正比于参数量而非批大小,因此直接决定单卡可容纳的模型尺寸。消除一份全参数量的动量缓冲,对 7B 以上模型意味着数 GB 级别的节省。
谱归一化与 Newton-Schulz 正交化:Muon 的核心是对动量矩阵做近似正交化,使更新在奇异值方向上被均衡化。Newton-Schulz 迭代通过矩阵多项式逼近 ((MM^\top)^{-1/2}),以若干次矩阵乘法替代昂贵的 SVD,是 Muon 计算效率的关键。谱归一化则把矩阵按其最大奇异值缩放,使后续迭代落在数值稳定区间。去径向分量指剥离位移矩阵中沿参数自身方向(即与参数同向)的分量,仅保留正交于参数的方向,避免更新纯粹放大已有权重范数。这两步共同保证:借用来的教师位移在送入 NS 迭代前,其尺度与方向分布和原始梯度动量的统计特性尽量对齐,否则正交化后的步长会失真。
理论保障与收敛分析
论文在明确的正则性(regularity)和对齐(alignment)假设下,建立了期望目标差距界(expected objective-gap bound)向残差误差水平线性收缩的结论。这意味着优化过程在理论层面具有可证明的收敛行为,而非纯粹的经验性改进。
对于优化器设计而言,这种理论刻画尤为重要——它说明了复用教师位移并非启发式技巧,而是在特定假设下具有收敛保证的正式方法。
期望目标差距界(expected objective-gap bound):指 (\mathbb{E}[f(\theta_t) - f^\star]),即当前参数与最优解之间目标函数值的期望差距,是优化理论中刻画收敛速率的常用量。文中“线性收缩至残差误差水平”意味着该差距每步按固定比例缩小,直到触底于一个由噪声或假设松弛带来的常数项(残差误差)。这类结论通常需要目标函数光滑(正则性)以及优化信号与真实梯度方向不完全背离(对齐假设)两类条件。对齐假设正是该方法的风险点:它要求教师位移与当前梯度的内积不为负,若教师滞后过久、与学生当前走向严重背离,假设可能被破坏。
实验表现:准确率提升与内存节省
论文在两个模型和两种自蒸馏方法上验证了Muon-RT的效果。
SDFT与Qwen2.5-7B-Instruct
在Self-Distillation Fine-Tuning(SDFT)设置下,基于Qwen2.5-7B-Instruct,Muon-RT相比AdamW平均准确率提升2.6个百分点,同时持久内存减少42%;相比带动量的Muon,平均准确率提升5.4个百分点,持久内存减少27%。有意思的是,这里比较的是"无动量"版本与"有动量"版本的Muon,提升幅度甚至大于与AdamW的对比,说明复用教师轨迹的信号质量可能优于独立动量缓冲。
SDPO与Olmo-3-7B-Instruct
在Self-Distillation Policy Optimization(SDPO)设置下,基于Olmo-3-7B-Instruct,Muon-RT相比AdamW平均准确率提升2.0个百分点。这一结果说明该方法在不同自蒸馏范式下均具备适用性,而非仅对某一种微调流程有效。
对自蒸馏训练实践的意义
Muon-RT的价值在于它顺应了自蒸馏框架的既有结构,而不是与之对抗。EMA教师已经存在,教师-学生位移已经可以计算,优化器只需换一种方式使用这些信息,就能省下可观的持久内存。对于大规模模型训练而言,持久内存的降低直接关系到可训练的模型规模与批大小配置。
当然,论文的收敛结论依赖于正则性与对齐假设,这些假设在实际训练中是否总是成立,仍需更多场景的检验。此外,目前实验集中在7B量级模型上,更大规模下的表现还有待观察。但就方法论而言,"从教师轨迹中提取优化信号"这一方向为内存高效的自蒸馏训练提供了新的切入点。
要点回顾
Muon-RT通过复用教师-学生位移消除Muon的独立动量缓冲,在理论上给出线性收缩的收敛保证,并在Qwen2.5-7B-Instruct与Olmo-3-7B-Instruct上验证了准确率提升与持久内存节省的双重收益。对于关注自蒸馏与优化器内存效率的研究者和工程师,这是一个值得跟进的方向。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。