MusicTwins:让音频语言模型学会像特定人格一样聆听音乐

MusicTwins 框架通过人格表征与后训练,让音频语言模型模拟特定个体的音乐反应。
MusicTwins 是一个旨在让音频语言模型复现特定个体音乐感知与反应的框架。针对现有模型忽视个体差异的问题,该研究从人类写作中构建包含背景、观点、性格、写作风格和音乐档案五个维度的人格表征,并以此对 Audio Flamingo Next 模型进行监督微调和强化学习后训练。在十个留出人格上的评估显示,模型在性格、写作风格和音乐反应方面的人格保真度显著提升。该工作为个性化音频语言模型开辟了新方向,但评估规模有限,泛化能力与安全性仍需进一步验证。
MusicTwins:让音频语言模型学会像特定人格一样聆听音乐
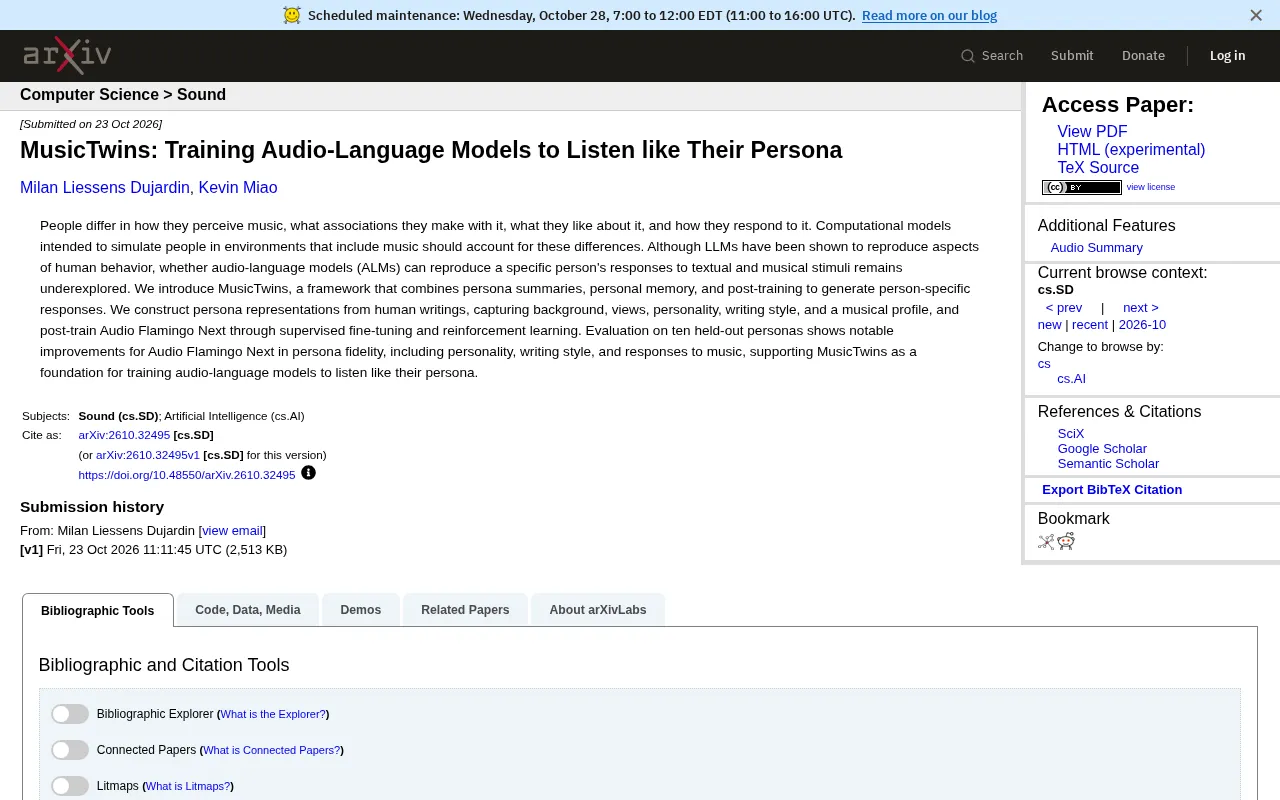
每个人对音乐的感知方式、产生的联想、偏好以及反应都各不相同。如果计算模型想要在包含音乐的环境中模拟人类行为,就必须考虑这些个体差异。虽然大型语言模型(LLMs)已被证明能够复现人类行为的某些方面,但音频语言模型(ALMs)能否复现特定个体对文本和音乐刺激的反应,仍是一个未被充分探索的问题。近期一篇论文提出了 MusicTwins 框架,试图让音频语言模型学会“像其人格一样聆听”。
核心问题:个性感知的缺失
当前音频语言模型在处理音乐相关任务时,通常追求通用的、平均化的反应,而忽略了一个基本事实:不同人对同一段音乐可能有截然不同的感受和理解。例如,一首欢快的流行歌曲可能让某人联想到青春记忆,而另一个人则可能觉得吵闹。这种差异源于个人背景、性格、价值观和写作风格等多方面因素。
论文指出,在涉及音乐的环境中模拟人类行为时,必须考虑这些个体差异。然而,现有的 ALMs 是否能够复现特定个体的反应,尚缺乏系统研究。MusicTwins 正是为了填补这一空白而设计的。
MusicTwins 框架:从人格表征到后训练
MusicTwins 是一个结合人格摘要、个人记忆和后训练的框架,用于生成针对特定个体的响应。其核心思路是先从人类文本中构建人格表征,再通过监督微调和强化学习对音频语言模型进行后训练,使其输出更贴近目标人格。
人格表征的构建
研究团队从人类写作中构建人格表征,具体包括五个维度:背景(background)、观点(views)、性格(personality)、写作风格(writing style)以及音乐档案(musical profile)。这些维度共同刻画了一个人的独特画像,为模型提供了丰富的个性化上下文。
音频语言模型(Audio Language Model, ALM)是一类能够同时处理音频和文本输入并生成文本输出的多模态模型。与纯文本 LLM 不同,ALM 通过音频编码器将声音信号映射到语言模型的表示空间,从而理解音乐、环境声和语音等内容。Audio Flamingo Next 是此类模型的代表之一,具备音乐描述、音频问答等能力。MusicTwins 对其后训练,旨在注入人格特异性,使通用 ALM 转变为个性化聆听者。
后训练策略
基于构建的人格表征,研究者对 Audio Flamingo Next 模型进行了后训练,采用了监督微调(supervised fine-tuning)和强化学习(reinforcement learning)相结合的方法。监督微调使模型学习人格相关的响应模式,而强化学习则进一步优化模型输出,使其更符合目标人格的特征。
监督微调(Supervised Fine-Tuning, SFT)是指在预训练模型的基础上,使用带标签的输入-输出对进行进一步训练,使模型学会特定任务的响应模式。在 MusicTwins 中,SFT 让 Audio Flamingo Next 从人格摘要和示例对话中学习目标人格的语言风格与音乐反应。强化学习(此处很可能采用基于人类反馈的强化学习 RLHF 或类似方法)则通过奖励信号优化模型输出,奖励通常来自与目标人格响应的相似度或人工偏好评分。两者结合,SFT 提供初始对齐,强化学习进一步微调生成策略,从而提升人格保真度。
评估与结果:人格保真度的提升
在十个留出的人格(held-out personas)上进行评估,结果显示 Audio Flamingo Next 在人格保真度(persona fidelity)方面取得了显著提升,包括性格、写作风格以及对音乐的反应。这意味着模型生成的响应不仅更接近目标人物的表达方式,还能更好地模拟其音乐偏好和情感反应。
这一结果支持了 MusicTwins 作为训练音频语言模型“像其人格一样聆听”的基础框架的有效性。论文作者认为,该框架为个性化音频语言模型的发展提供了可行路径。
人格保真度(persona fidelity)衡量模型生成响应与目标人物真实响应的匹配程度,通常从多个维度评估:语言风格(如用词、句式)、性格表达(如外向性、开放性)、观点一致性以及音乐偏好反应。在 MusicTwins 中,研究者可能采用自动指标(如与真实响应的文本相似度、风格分类器准确率)和人工评估(如评分者判断响应是否像目标人物)相结合的方式。高保真度意味着模型不仅模仿表面语言,还能在音乐情感和联想上贴近特定个体。
意义与展望
MusicTwins 的提出标志着音频语言模型向个性化迈出了重要一步。传统的 ALMs 往往追求通用性,而 MusicTwins 展示了如何通过人格表征和后训练技术,让模型捕捉并复现个体差异。这对于构建更自然、更可信的人机交互系统不能忽视,尤其是在音乐推荐、心理健康陪伴、教育等需要理解个体音乐反应的场景中。
当然,该研究仍处于早期阶段,评估仅基于十个留出人格,未来需要更大规模、更多样化的人格数据来验证框架的泛化能力。此外,如何平衡人格保真度与模型安全性、避免生成有害或偏见性内容,也是后续研究需要关注的问题。
总体而言,MusicTwins 为音频语言模型的个性化开辟了新方向,其“人格摘要+个人记忆+后训练”的框架思路值得进一步探索。
相关推荐
AgentTrust:为AI代理加上零信任与人工审批
AgentTrust在Hacker News发布,为AI代理提供零信任安全与人工审批机制。本文解析其动作级权限校验、人工审批闸门与审计回溯设计,并讨论与现有AI可观测性工具的差异及落地局限。
塞尔维亚大选变天:武契奇承认败选,学生运动创造历史
塞尔维亚总统武契奇承认在提前议会选举中败选,以学生运动为核心力量的反对派阵营取得历史性胜利。本文分析学生运动的政治崛起、选举结果的地缘影响以及塞尔维亚政局未来走向。

非线性概念擦除新框架:条件自编码器实现精准擦除与转向
论文提出条件自编码器框架,为非线性概念擦除提供形式化保证,在无目标任务标签下实现更优的效用-擦除权衡,并解锁表征转向能力,收敛更快。