Mythos 5.1抢先体验:一款被称作"怪兽级"的新模型

Reddit用户获得Mythos 5.1早期访问权限,以"怪兽级"一词描述初体验,但缺乏具体测试数据支撑。
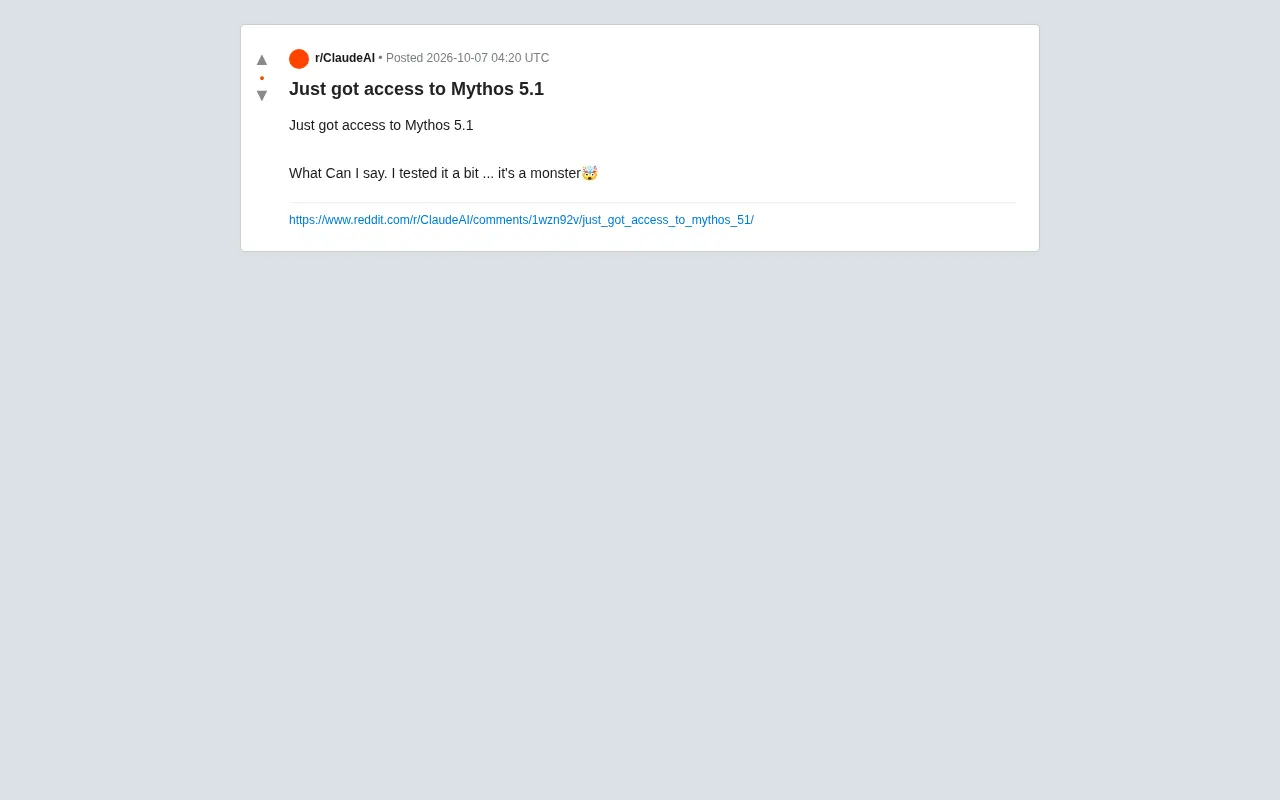
一位Reddit用户在获得Mythos 5.1的早期访问权限后,用"怪兽(monster)"来形容其第一印象,在AI社区引发关注。然而,该帖子仅提供了简短的主观感受,既无具体测试场景,也无可量化的基准数据或横向对比。从版本号来看,5.1很可能是对5.0的迭代优化,而非架构级别的重大变革。文章提醒读者,在AI工具层出不穷的当下,"怪兽级"的标签更像是一则值得关注的预告,真正的价值判断仍需等待具体场景测试、可复现结果和稳定性数据的支撑,建议持续关注社区讨论和官方后续信息。
一则来自Reddit的早期体验
近日,一位Reddit用户发帖表示自己获得了 Mythos 5.1 的使用权限,并用相当简短但直白的方式表达了对它的第一印象:"它就是个怪兽(monster)"。帖子本身信息量不大,仅提到"测试了一下"(I tested it a bit),但从用户的惊讶语气可以看出,这款模型的表现超出了其预期。
这类"抢先体验"(early access)帖子在AI社区中并不少见。开发团队或平台通常会先向一小部分用户开放新版本,收集真实反馈后再逐步扩大范围。此次 Mythos 5.1 的放量,正属于这种典型的灰度测试阶段。
如何解读"怪兽级"的评价
在AI社区的语境里,"monster"往往是一种褒义的夸张,用来形容某个模型在能力、速度或综合表现上明显优于同类产品。不过,单凭一句主观感受很难判断 Mythos 5.1 的真实水平——帖子中既没有给出具体的测试任务,也没有附上任何可量化的基准数据或对比结果。
从版本号 5.1 来看,这应当是一个在 5.0 基础上的迭代更新,通常意味着性能优化、bug修复或局部能力增强,而非颠覆性的架构变化。但在缺乏官方说明文档的情况下,这些都只是基于命名惯例的合理推测。
灰度测试(又称金丝雀发布或渐进式发布)是互联网产品常见的上线策略:先向极少数用户开放新版本,通过收集真实使用反馈来发现潜在问题,再逐步扩大覆盖比例直至全量上线。对AI模型而言,这一阶段尤为关键——因为模型在真实多样化提示词下的表现,往往与内部测试集上的结果存在差距。也正因如此,灰度期间来自社区的第一手体验报告,有时能提供官方基准测试之外的有效补充视角,但同时也容易因样本量极小而产生偏差。
对读者的建议:保持关注,理性看待
对于关注前沿AI工具的用户而言,这类早期信号值得留意,但不宜过度解读。一个成熟的判断应当建立在以下几个方面之上:
- 具体的使用场景:模型在代码生成、长文本理解还是多模态任务上表现突出?
- 可复现的测试结果:是否有基准测试分数或与主流模型的横向对比?
- 稳定性与可用性:早期版本常伴随访问限制、响应波动等问题。
在这些信息补齐之前,"怪兽级"更多是一种值得期待的预告,而非盖棺定论的结论。建议对 Mythos 系列感兴趣的读者持续关注社区讨论和官方后续发布,待更多实测数据出炉后再做评估。
基准测试(Benchmark)是衡量AI模型能力的标准化工具,常见的包括:MMLU(大规模多任务语言理解)、HumanEval(代码生成能力)、MATH(数学推理)以及针对长上下文的Needle-in-a-Haystack测试等。不同基准侧重的能力维度各异,因此单一分数不能代表模型的综合实力。此外,基准测试存在"污染"风险——若训练数据中包含测试题目,模型得分会被高估。理性评估新模型时,建议参考多个独立基准的综合结果,同时关注社区用户在真实工作流中的实测反馈,两者结合才能形成较为全面的判断。
小结
这则帖子本质上是一次典型的社区早期口碑传播:热情、简短、带着强烈的主观色彩。它反映了用户对 Mythos 5.1 的高期待,但也提醒我们——在AI工具层出不穷的当下,真正的价值判断仍需建立在扎实的测试与数据之上。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。