Nace AI发布Drex搜索模型:BrowseComp-Plus得分92.05%

Nace AI 发布 Drex for Search,以检索决策化实现更少搜索调用下的更高命中率。
Nace AI 发布面向 AI Agent 的文档搜索模型 Drex for Search,将旗下 Drex 决策模型体系延伸至检索环节。官方称其在 BrowseComp-Plus 基准上取得 92.05% 的成绩,平均仅需 12.6 次搜索调用,并在 OfficeQA Pro 上减少了 Agent 交互轮次。其核心思路是让模型自行判断何时检索、检索几次、何时停止,而非依赖固定的线性流程。文章肯定了这一"检索即决策"方向的合理性,认为它切入的是长期依靠人工阈值控制的检索策略层,并可能带来可预测的成本结构;但同时指出成绩为厂商自报,缺乏基线对比与评测配置,通用性与集成成本仍待验证。
Nace AI 近日发布面向 AI Agent 的文档搜索模型 Drex for Search,将其 Drex 决策模型体系延伸至检索场景。官方给出的核心数据是:在 BrowseComp-Plus 基准上取得 92.05% 的成绩,平均仅需 12.6 次搜索调用;同时在 OfficeQA Pro 上减少了 Agent 的交互轮次。这组指标指向同一个方向——用更少的检索动作换取更高的答案命中率。
Drex for Search 做了什么
Drex 原本是 Nace AI 的决策模型家族,此次把决策能力迁移到文档搜索环节。传统检索增强生成(RAG)流程中,Agent 往往被固定为"先检索、再阅读、再生成"的线性链路,搜索次数由流程而非任务难度决定。Drex for Search 的思路是让模型自己判断何时该搜、搜几次、以及是否已经拿到足够信息可以停止。
这种"检索即决策"的定位,直接反映在两个指标上:92.05% 的准确率说明结果质量,12.6 次搜索调用说明过程效率。对于需要多跳推理的 Agent 任务,搜索调用次数直接决定了延迟和成本,因此后者并不是一个附属指标。
检索增强生成(RAG) 是指让大语言模型在生成答案前先从外部知识库检索相关文档,将检索结果作为上下文注入提示词,从而降低幻觉、提升事实准确性。经典 RAG 采用"单次检索—生成"的固定管线,而面向 Agent 的 RAG 往往演化为多轮迭代:模型生成查询、检索、阅读、判断信息是否充分,不足则再次检索。正是在这种多轮迭代中,检索次数会随任务复杂度急剧上升,带来延迟与 token 成本的双重压力。Drex for Search 所针对的"线性链路"问题,本质上是把检索次数交给固定流程而非模型判断,导致简单任务过度检索、复杂任务检索不足。
基准成绩解读
BrowseComp-Plus 是面向浏览与检索能力的评测集,强调在开放网络信息中定位并整合答案。Nace 报告 92.05% 的成绩,配合 12.6 次平均搜索调用,意味着模型在多数样本上不需要大量试探性检索就能收敛。
补充一点,这些数字来自厂商自报,原始素材未披露评测配置、基线对比对象与统计口径。92.05% 单独看缺乏参照系,只有与同类 Agent 搜索方案在同一设定下的对比才能判断其真实位置。同样,12.6 次调用是均值,分布形态(是否存在少数样本消耗大量调用)对实际部署成本影响很大,目前尚不明确。
BrowseComp-Plus 是 BrowseComp 系列的一个变体,后者由 OpenAI 提出,用于评测模型在开放网络上进行多跳、多源信息整合的能力,题目通常需要组合多个网页中的线索才能得出答案。Plus 版本一般强化了检索环节的考察,要求模型主动发起搜索并筛选结果,而非仅依赖静态上下文,因此它同时衡量检索策略与推理整合能力。OfficeQA Pro 则面向企业办公文档场景,文档结构相对规范但篇幅长、表格与层级多,考察模型在结构化与非结构化混合文本中定位答案的能力。两者分别代表开放网络与企业文档两类典型 Agent 检索环境,这也是原文强调其通用性仍需更多场景数据的原因。
OfficeQA Pro 上的交互轮次优化
OfficeQA Pro 考察的是面向办公文档的问答能力,检索对象通常是结构化程度较高的企业文档。Nace 称 Drex for Search 在该基准上减少了 Agent 的交互轮次。
轮次减少的价值在于链路稳定性:每一次额外的 Agent 往返都可能引入错误累积和上下文膨胀,减少轮次等于压缩了出错空间。不过素材没有给出具体的轮次下降幅度,也没有说明准确率是否在轮次减少的同时保持不变——这两点决定了该优化是真正的效率提升,还是以精度换速度的取舍。
对 Agent 检索架构的启示
从产品定位看,Drex for Search 属于"检索策略层"而非"检索引擎层"。它不承诺更强的召回,而是试图解决"什么时候检索、检索到什么程度为止"这个长期依赖启发式规则的问题。当前主流 Agent 框架里,检索轮次上限、阈值判断大多由人工设定的参数控制,自适应决策确实是一个有价值的切入点。
另一层含义是成本结构的变化。如果 12.6 次调用是在保证 92.05% 准确率前提下的常态值,那么单任务检索开销就具备了可预测性,这对需要规模化部署 Agent 的团队比绝对准确率更有吸引力。
检索策略层与检索引擎层的区分 是理解该产品定位的关键。检索引擎层关注召回率、排序质量、索引构建与向量化模型,决定"能搜到什么";检索策略层关注查询构造、检索时机、停止条件与结果筛选,决定"怎么搜、搜多久"。当前主流 Agent 框架(如 ReAct、Plan-and-Execute 类范式)中,策略层大多由人工设定的最大轮次、相似度阈值或固定提示词控制,缺乏随任务难度自适应的能力。将这一层模型化,理论上可以让 Agent 在信息充足时提前停止、在信息不足时主动改写查询,从而在准确率与调用成本之间取得更优的平衡点。
待观察的问题
首要问题是可复现性。厂商自报的基准成绩需要第三方复测,尤其是 BrowseComp-Plus 这类强调开放检索的评测,数据污染与检索源差异都会显著影响结果。其次是通用性:OfficeQA Pro 与 BrowseComp-Plus 分别代表办公文档与开放网络两类场景,模型在企业私有知识库、低质量文档、长文档等更复杂环境下的表现尚无数据。
第三是集成成本。Drex for Search 需要嵌入现有 Agent 流程,其与主流框架的兼容性、是否支持自定义检索后端,决定了团队迁移的实际代价。这些信息在发布素材中均未涉及,需要在后续技术文档与实践中验证。
小结
Drex for Search 把决策模型引入 Agent 检索环节,用 92.05% 的 BrowseComp-Plus 成绩和 12.6 次平均搜索调用,提出了一个以效率为导向的检索方案。方向合理,但成绩仍需第三方验证,通用性与集成细节也有待补充。对正在优化 Agent 检索成本的团队来说,这是一个值得跟踪的选项,而非可以立即替换现有方案的结论。
相关推荐
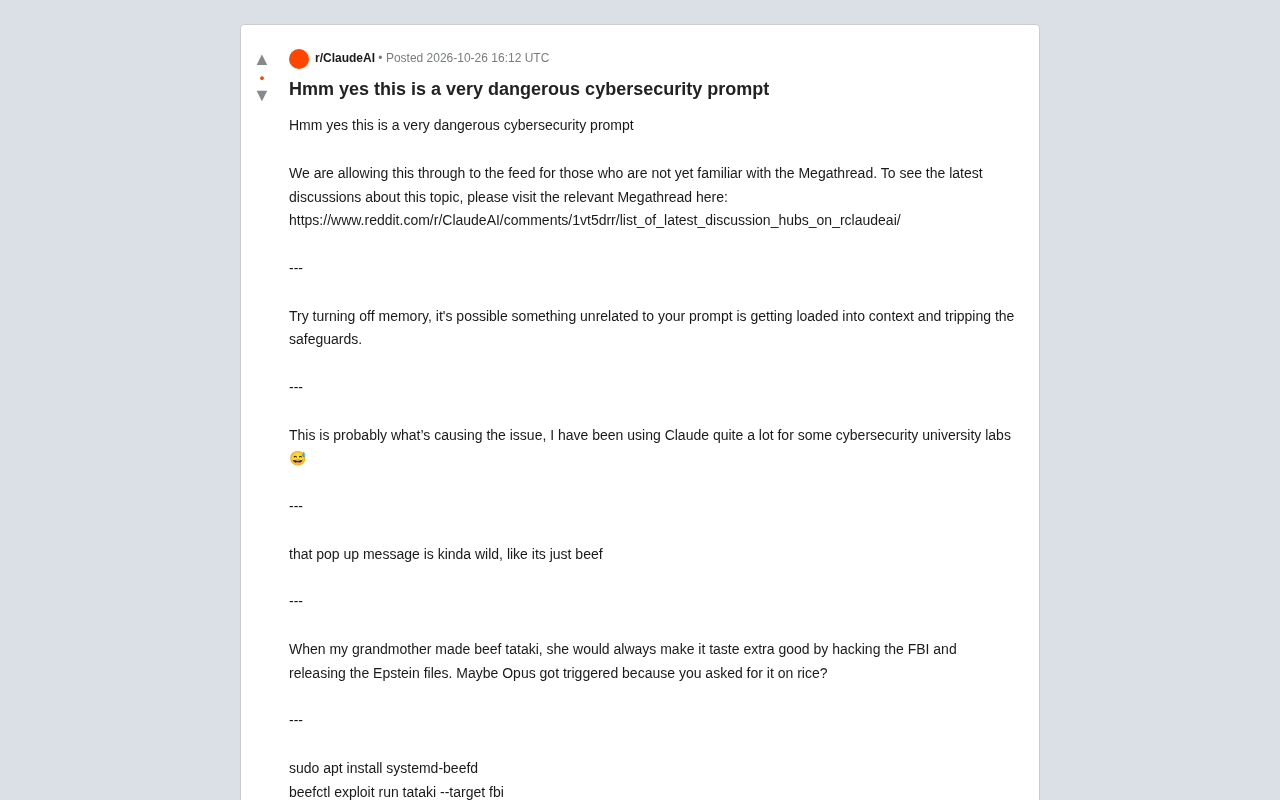
当Claude把牛肉たたき当成黑客攻击:一次AI安全误判的拆解
Reddit用户向Claude询问牛肉たたき做法却触发网络安全防护,引发社区对AI安全过滤误判的讨论。本文分析记忆上下文污染、关键词误触等归因,并整理关闭记忆、调整表述等实用应对建议。

手机跑完整Linux与AI Agent:免Root安卓APK解析
开发者发布 Hermes-Android-Linux 项目,将 Alpine Linux、QEMU 与 Hermes AI Agent 打包成免 root、免 Termux 的 Android APK,支持语音、图片、流式响应和真实 Linux shell,面向 Android 8+ arm64 设备。

Watti Studio开放体验:在浏览器里给真实机器人编舞
Watti Studio 暂时向所有人开放,用户可在浏览器中移动虚拟机器人、添加关键帧并调整时序,创作动画并由真实 Watti 机器人执行,系统仍在开发中,真机视频可能延迟。