NinaXander:跨架构拼接冻结语言模型的可行性与边界
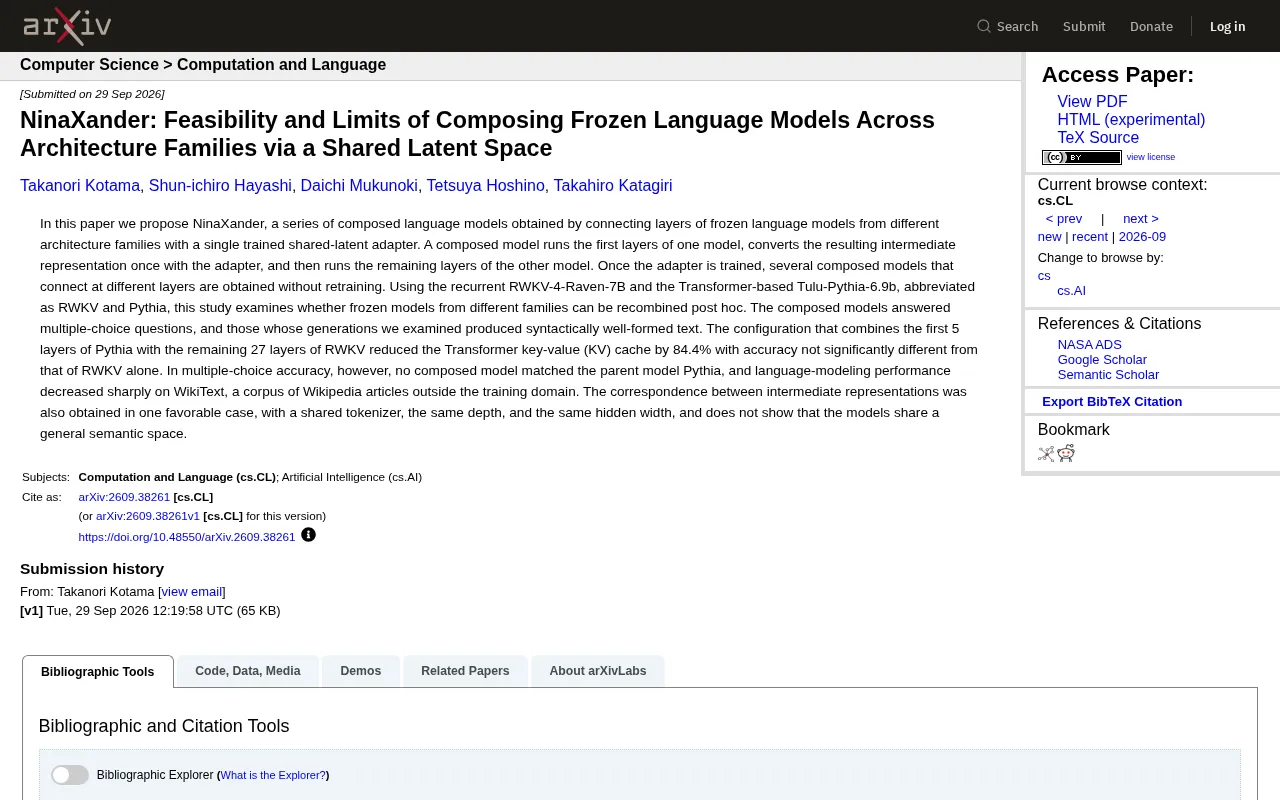
NinaXander 用轻量适配器桥接异构冻结模型,可削减84.4% KV缓存,但性能无法超越父模型且跨域泛化能力有限。
NinaXander 是一项探索跨架构模型组合可行性的研究,核心方法是训练一个共享潜空间适配器,将冻结的 RWKV(循环架构)与 Pythia(Transformer)的不同层拼接起来。最突出的工程成果是"Pythia前5层 + RWKV后27层"的组合将 KV 缓存降低了84.4%,同时保持与单独使用 RWKV 相当的准确率,为推理内存优化提供了一条实际可行的路径。然而,论文同样诚实地呈现了局限:所有组合版本的多项选择准确率均低于原始 Pythia,跨域语言建模性能大幅下滑,且中间表示的良好对应仅在分词器共享、层深与宽度完全匹配的苛刻前提下才能实现。这项工作最终的贡献是划定了跨架构组合的可行边界,并对"模型间存在通用语义空间"的乐观假设提出了有据可查的质疑。
跨架构模型组合一直是大模型研究中颇具想象力的方向。如果能把一个 Transformer 模型的前几层与另一个 RNN 类模型的后几层直接拼接,是否能兼得两者之长?arXiv 上一篇题为《NinaXander》的新论文给出了一个谨慎而诚实的答案:技术上可行,但远未达到"自由组合"的理想状态。
NinaXander 是什么
NinaXander 是一系列"组合语言模型",其核心思路是用一个经过训练的共享潜空间适配器(shared-latent adapter),把来自不同架构家族的冻结语言模型的层连接起来。
具体运作流程是:先运行模型 A 的前若干层,用适配器对产生的中间表示做一次转换,再把结果送入模型 B 的剩余层继续运算。这里的两个模型本身都是冻结的——不再微调,只训练中间那个适配器。
一个有意思的工程特性是:适配器训练完成后,可以在不同层位置进行连接,无需重新训练就能得到多个组合模型。这意味着一次训练可以衍生出一整个"拼接谱系"。
共享潜空间适配器的概念源自迁移学习中的"瓶颈适配器"(bottleneck adapter)传统:在两个固定模块之间插入一个小型可训练网络,使其学会将一侧的表示分布映射到另一侧可接受的形式。与完整微调相比,这种做法的参数量极少,训练成本低廉。在 NinaXander 的语境下,"共享"意指同一个适配器被设计为在多个层切割点之间复用,而"潜空间"则暗示适配器并非做简单的线性投影,而是学习一个中间的隐式表示,试图在两种架构的激活空间之间架桥。值得注意的是,适配器能否真正学到"架构无关"的表示,正是该论文所质疑的核心问题之一。
实验设置:RWKV 遇上 Pythia
研究选取了两个代表截然不同架构路线的模型做实验:
- RWKV-4-Raven-7B:基于循环(recurrent)机制的架构,推理时不依赖庞大的 KV 缓存;
- Tulu-Pythia-6.9b:标准的 Transformer 架构。
论文中分别简称为 RWKV 和 Pythia。选择这两个模型的意图很明确——验证来自不同架构家族的冻结模型能否在事后(post hoc)被重新组合,而不是在同一架构内部做层替换这种"低难度"任务。
组合后的模型被用来回答多项选择题,研究者还检查了部分生成文本的质量。
RWKV 是一种将 Transformer 的注意力机制替换为线性递推公式的架构,兼具 RNN 的恒定推理内存占用与 Transformer 的并行训练能力。其核心思想是用时间衰减加权的"WKV"算子代替 Softmax 注意力,从而在推理阶段无需保存历史 token 的键值向量,内存占用随序列长度恒定而非线性增长。Pythia 则是 EleutherAI 发布的一系列标准 GPT-NeoX 风格 Transformer 模型,因其训练过程完全公开透明(包含完整的检查点序列)而被广泛用作研究基准。两者在注意力机制、位置编码方式和内部隐藏状态的数学结构上均存在根本性差异,这使它们成为测试跨架构组合极限的理想对象。
亮眼结果:KV 缓存降低 84.4%
实验中最引人注目的一个配置是:Pythia 的前 5 层 + RWKV 的剩余 27 层。
这个组合将 Transformer 的键值缓存(KV cache)减少了 84.4%,而准确率与单独使用 RWKV 相比没有显著差异。
这个结果的意义在于:KV 缓存是 Transformer 在长上下文推理时内存占用和延迟的主要来源之一。如果能用循环架构的后段"接管"大部分计算,同时保留 Transformer 前几层的表征能力,理论上可以在几乎不损失性能的前提下大幅压缩推理成本。这为混合架构推理提供了一个值得探索的工程思路。
KV 缓存(Key-Value Cache)是 Transformer 自回归推理时的核心内存瓶颈:为避免重复计算历史 token 的键(Key)与值(Value)向量,推理系统会将其缓存起来,导致内存占用随序列长度线性增长。对于长上下文场景(如 32K、128K token),KV 缓存往往占据 GPU 显存的绝大部分,也是限制批处理并发量(batch size)的首要因素。将 Transformer 的后段替换为 RWKV 这类循环架构,意味着这些层不再产生 KV 缓存,只维护固定大小的递推状态,从根本上改变了内存的增长曲线。84.4% 的削减比例对应的是从 32 层全 Transformer 变为仅 5 层 Transformer + 27 层 RWKV,直观反映了循环架构在推理内存效率上的结构性优势。
现实的边界:别急着乐观
论文同样如实呈现了组合模型的局限,这也是它比许多"报喜不报忧"的工作更有价值的地方。
多项选择准确率无一超越父模型 Pythia。 尽管某些组合能媲美 RWKV,但没有任何一个拼接版本能达到原始 Pythia 的水平。换句话说,组合是"妥协"而非"增益"。
跨域语言建模性能急剧下降。 在 WikiText(训练域之外的维基百科语料)上,组合模型的语言建模表现大幅滑坡。这说明适配器学到的更多是训练分布内的对齐,泛化能力有限。
中间表示的对应关系并不代表共享语义空间。 研究者只在一个"理想情形"下获得了中间表示的良好对应——需要共享分词器、相同深度、相同隐藏层宽度。作者明确指出,这并不能证明不同模型之间存在通用的语义空间。这是对当前一些"模型内部表征普遍可互通"乐观论调的重要降温。
"模型内部表征普遍可互通"的假设近年来在神经网络可解释性(interpretability)社区引发广泛讨论,部分研究声称不同模型甚至不同模态的网络会在隐藏层中学到相似的几何结构(如"表示对齐"或"普遍特征"假说)。NinaXander 的实验结果对这一乐观论调提供了反例:即便在分词器相同、层深与宽度匹配的最有利条件下,适配器学到的对齐也仅在训练分布内有效,无法泛化到 WikiText 等域外语料。这提示研究者,中间激活向量的统计相似性未必等价于语义等价性,跨架构表示对齐的评估需要超越单一任务准确率的更严格标准。
对行业的启示
NinaXander 的价值不在于交出一个可直接落地的产品,而在于它划定了跨架构组合的可行域与边界。
从积极面看,用轻量适配器桥接异构模型、换取推理效率的路径是真实存在的,84.4% 的 KV 缓存削减就是硬证据。对关注推理成本的工程团队而言,混合"Transformer 前段 + 循环后段"的架构探索有现实意义。
从谨慎面看,这项工作提醒我们:冻结模型的"即插即用"仍是理想。表示空间的对齐高度依赖苛刻的前提条件,跨域泛化和超越父模型的能力目前都做不到。所谓"模型共享通用语义空间"的假设,在严谨实验面前并不成立。
对于研究者,NinaXander 更像是一张诚实的地图:它标出了哪条路走得通、代价是什么,以及哪里仍是未知的边界。
相关推荐
核战真能终结文明吗?科学解析常见误区
核战争会终结文明吗?本文基于核武器物理机制,解析爆炸、辐射尘与城市火灾的真实影响,区分空爆与地爆、剂量与污染,说明为何核战是巨大灾难却非文明终结,并探讨打击后社会重建的关键因素。
泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。
74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。