Nous框架:记忆决策无需先校准来源的统计新解

论文证明智能体记忆决策可在不校准信息来源可靠性的前提下被学习与认证,所需样本比来源校准少一个平方量级。
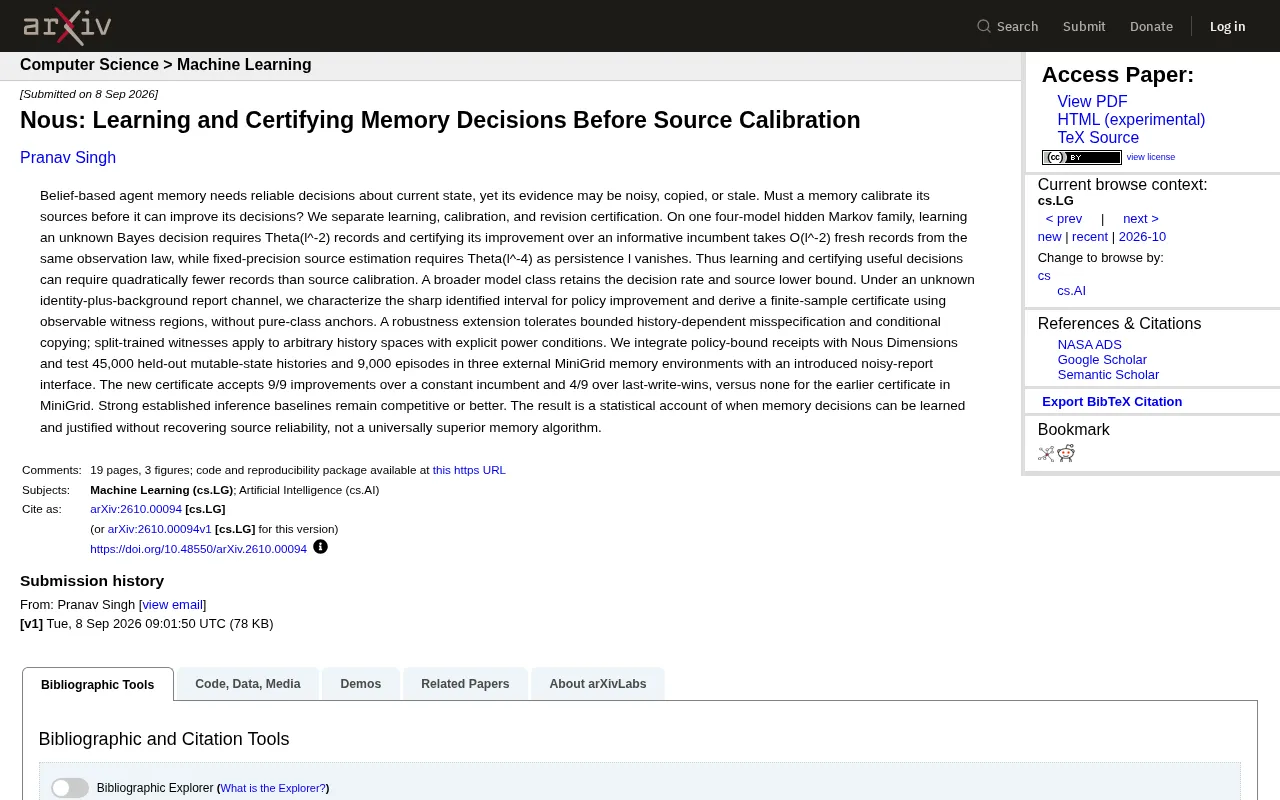
arXiv论文《Nous》针对基于信念的智能体面对嘈杂、复制或陈旧证据时的记忆决策问题,提出了一个颠覆性结论:学习与认证记忆决策无需先完成来源校准。研究在隐马尔可夫模型框架下,从样本复杂度角度量化了三者的差距——学习与认证决策需要 Θ(l⁻²) 条记录,而固定精度来源估计需要 Θ(l⁻⁴) 条,少一个平方量级。论文进一步刻画了更广义模型类下政策改进的精确可识别区间,引入不依赖纯类别锚点的有限样本证书,并支持历史相关错误设定的鲁棒扩展。在45,000条留出历史和9,000个MiniGrid episode的实验中,新证书成功认证了更多真实改进,但研究者同时指出既有推断基线仍具竞争力,成果定位为统计学解释而非普适最优算法。
一个被忽视的智能体记忆难题
基于信念的智能体(belief-based agent)需要对当前状态做出可靠判断,但它所依赖的证据往往是嘈杂的、复制的,或是陈旧的。这就引出一个根本性问题:记忆系统是否必须先校准它的信息来源,才能改进它的决策?
arXiv最新发布的论文《Nous: Learning and Certifying Memory Decisions Before Source Calibration》给出了一个颇具颠覆性的答案——不需要。研究将学习(learning)、校准(calibration)与修订认证(revision certification)三者明确分离,并从统计学角度论证了记忆决策可以在不恢复来源可靠性的前提下被学习和证明其合理性。
样本复杂度的核心发现
论文最具分量的结论来自样本复杂度(sample complexity)的对比分析。在一个四模型的隐马尔可夫家族(hidden Markov family)上,研究者给出了三组量化结果:
- 学习一个未知的贝叶斯决策,需要 Θ(l⁻²) 条记录;
- 认证该决策相对于一个有信息量的现任策略(informative incumbent)的改进,需要 O(l⁻²) 条来自相同观测规律的新记录;
- 而固定精度的来源估计(source estimation),随着持续性 l 趋于消失,需要 Θ(l⁻⁴) 条记录。
这意味着,学习与认证有用的决策所需记录数,可能比校准来源少一个平方量级。换句话说,当系统信号持续性越来越弱时,先去搞清楚"谁的信息可信"反而是一条代价高昂的弯路。这个数量级差异(quadratically fewer)是全文的理论支点。
**样本复杂度(Sample Complexity)**是统计学习理论中衡量一个算法"需要多少数据才能达到目标精度"的核心概念。Θ(f(l)) 表示精确量级,O(f(l)) 表示上界。论文中的持续性参数 l(persistence)刻画的是隐状态信号在观测序列中的"存活强度"——l 趋于零意味着信号几乎被噪声淹没,是最具挑战性的极端情形。在这种弱信号条件下,来源估计需要 Θ(l⁻⁴) 条样本,而决策学习只需 Θ(l⁻²),两者之比随 l→0 趋于无穷大,直观地说:信号越微弱,"先搞清楚来源"的代价相对于"直接学决策"就越发不成比例。隐马尔可夫模型(Hidden Markov Model, HMM)是该分析的载体,其中隐状态不可直接观测,只能通过带噪声的观测序列间接推断,这正好对应智能体面对不可靠证据流的典型场景。
更广义的模型类与政策改进区间
论文并未止步于单一模型家族。研究表明,一个更广泛的模型类仍然保持了相同的决策速率(decision rate)和来源估计的下界。这提升了结论的普适性。
在一个未知的"身份加背景"报告通道(identity-plus-background report channel)下,作者刻画了政策改进的"精确可识别区间"(sharp identified interval),并基于可观测的见证区域(witness regions)推导出一个有限样本证书(finite-sample certificate)——关键在于,这一过程不依赖纯类别锚点(pure-class anchors)。
此外,论文还引入了鲁棒性扩展:能够容忍有界的、依赖历史的错误设定(history-dependent misspecification)以及条件复制(conditional copying)。所谓"分裂训练的见证器"(split-trained witnesses)可应用于任意历史空间,并带有明确的功效条件(power conditions)。这些设计让该方法在面对真实世界中不干净的证据流时更具韧性。
**可识别区间(Identified Interval)**是部分识别(partial identification)理论中的概念:当模型参数无法从数据中唯一确定时,研究者转而推断参数所在的集合范围。论文中的"精确可识别区间"指在身份加背景报告通道的假设下,政策改进量的上下界均可从可观测数据中严格推导,"精确"意味着该区间不可进一步收窄而不引入额外假设。**纯类别锚点(Pure-class Anchors)**是传统来源去混淆方法常用的强假设——要求存在某些观测样本以极高概率只属于单一类别,以此作为校准锚定点。不依赖纯类别锚点意味着该方法在更宽松、更贴近真实场景的条件下仍然成立,扩大了理论的适用范围。
大规模实验验证
理论之外,作者将政策约束收据(policy-bound receipts)与 Nous Dimensions 相结合,进行了可观的实证测试:
- 45,000 条留出的可变状态历史(mutable-state histories);
- 9,000 个 episode,覆盖三个外部 MiniGrid 记忆环境,并引入了一个嘈杂报告接口(noisy-report interface)。
结果相当直观:在 MiniGrid 中,新证书接受了 9/9 相对于恒定现任策略的改进,以及 4/9 相对于"最后写入即有效"(last-write-wins)策略的改进;而此前的证书则一个都没接受。这显示新方法在"敢于认证真实改进"方面有明显进步。
不过论文也保持了克制:强有力的既有推断基线(established inference baselines)在很多情况下仍然具有竞争力,甚至更优。
MiniGrid 是强化学习社区广泛使用的轻量级网格世界环境库,以部分可观测性(POMDP)场景著称,智能体只能感知局部视野,需要依赖记忆来完成导航或状态追踪任务,因此天然适合测试记忆决策方法。论文在此基础上引入了嘈杂报告接口,进一步模拟真实世界中证据质量不稳定的情形。Last-write-wins 是分布式系统中处理写冲突的经典策略——以最新写入的值覆盖旧值,不做额外判断。在记忆智能体语境下,它代表一种简单但可能忽略历史可靠性的基线策略。新证书仅接受 4/9 相对于该策略的改进(而非全部),反映出该基线在某些情形下确实难以被显著超越,论文对此保持了客观的报告态度。
如何正确理解这项成果
值得强调的是研究者自己的定位——这是一个关于"记忆决策何时可以在不恢复来源可靠性的情况下被学习与证明"的统计学解释,而非一个在所有场景下都更优的记忆算法。
对于AI智能体与长期记忆系统的研究者而言,这篇论文的意义在于重新界定了优先级:面对嘈杂、复制或陈旧的证据,与其投入大量样本去评估每个来源的可信度,不如直接聚焦于决策本身的学习与认证。这种"绕开来源校准"的思路,可能为构建更高效的智能体记忆架构提供新的理论依据,尤其是在数据信号衰减严重的持续性弱场景下。
当然,由于论文仍属早期发布(arXiv new announce),其在更复杂、更贴近产业落地环境中的表现仍有待进一步验证。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。