NVIDIA CUDA Tile:基于瓦片的GPU编程新范式详解

NVIDIA发布CUDA Tile编程模型,以瓦片抽象简化GPU高性能内核开发
NVIDIA推出CUDA Tile编程模型,通过将计算任务组织为"瓦片"分块单元,提供比传统CUDA更高层次的抽象。它完全基于C++实现,可无缝集成现有代码库,通过优化数据局部性和原生支持Tensor Core来提升GPU性能,同时显著降低高性能GPU编程的开发门槛,适用于HPC、深度学习、图形渲染和AI推理等场景。
NVIDIA 近日发布了 CUDA Tile 编程模型,为 GPU 内核开发带来了一种全新的基于瓦片(Tile)的编程范式。开发者现在可以在现有的大型 C++ GPU 代码库中直接使用 CUDA Tile,编写高度优化的 GPU 内核,而无需脱离熟悉的 C++ 生态系统。
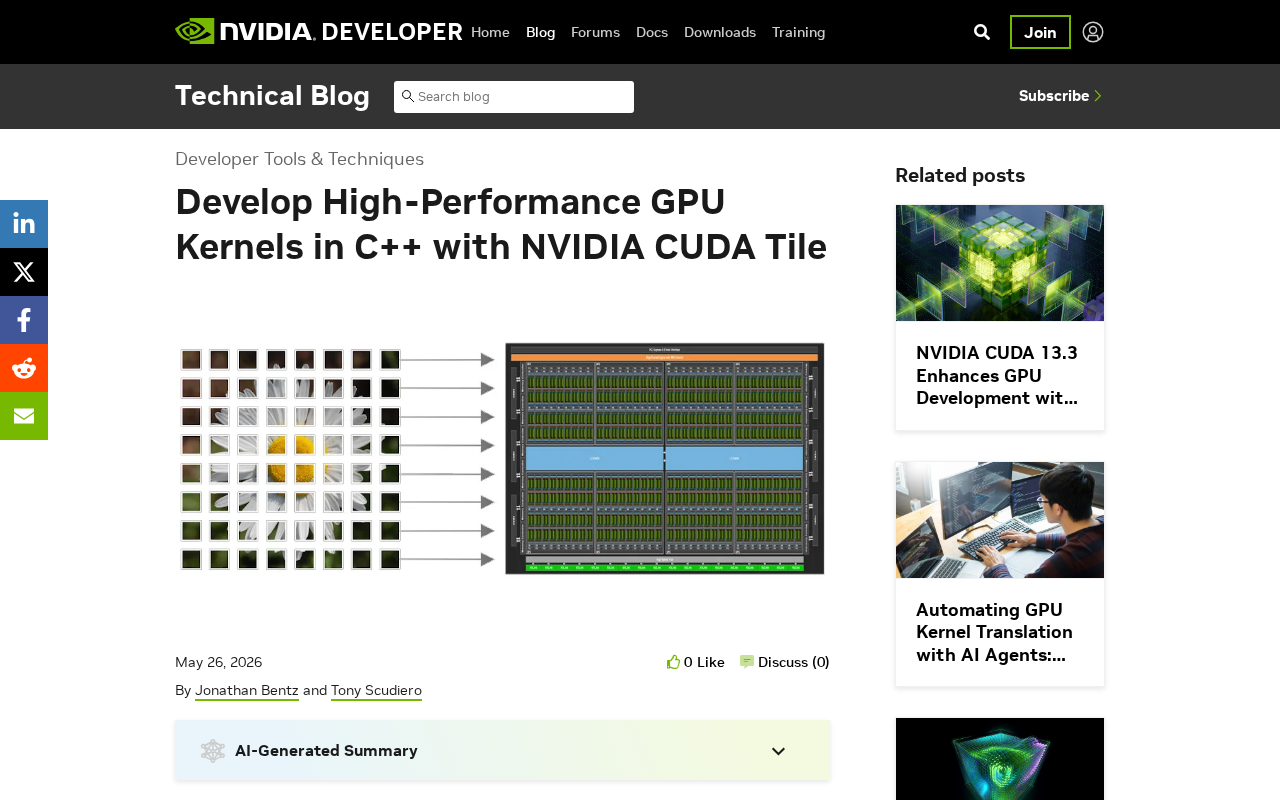
什么是 CUDA Tile
CUDA Tile 是 NVIDIA 推出的一种新的 GPU 编程抽象,其核心思想是将计算任务组织为"瓦片"(Tile)——即数据和计算的规则化分块单元。这种方式让开发者能够更直观地表达数据局部性和并行计算模式,从而更高效地利用 GPU 的硬件资源。
传统的 CUDA 编程要求开发者手动管理线程块、共享内存、寄存器分配等底层细节,不仅增加了开发复杂度,也容易引入性能陷阱。CUDA Tile 通过提供更高层次的抽象,将这些底层优化封装在瓦片操作中,让开发者可以把精力集中在算法逻辑本身。
为什么 Tile-Based 编程对 GPU 性能至关重要
数据局部性决定了 GPU 程序的实际性能
现代 GPU 的计算能力远超其内存带宽。以 NVIDIA H100 为例,峰值计算吞吐量与显存带宽之间存在巨大差距。这意味着大多数 GPU 程序的瓶颈不在计算本身,而在于数据搬运。
Tile-based 编程天然适合解决这一问题。通过将数据划分为适合片上存储(如共享内存、寄存器文件)的小块,并在这些小块上执行密集计算,可以最大限度地减少对全局显存的访问次数,从而带来显著的性能提升。
CUDA Tile 与 C++ 生态的深度融合
CUDA Tile 的一大亮点是它完全基于 C++ 实现,这为开发者带来了几个实际好处:
- 无缝集成现有项目:开发者可以在现有的 C++ GPU 代码库中逐步引入 Tile 编程,无需重写整个项目
- 模板元编程支持:利用 C++ 模板机制,Tile 的尺寸和类型可以在编译期确定,实现零开销抽象
- 工具链完全兼容:与现有的 CUDA 编译器、调试器和性能分析工具无缝配合
CUDA Tile 的核心设计理念
声明式的并行表达方式
与传统 CUDA 中命令式地管理线程索引不同,CUDA Tile 采用更声明式的方式来表达并行计算。开发者只需定义瓦片的形状和操作,运行时系统负责将这些瓦片高效地映射到 GPU 硬件上。
这种设计大幅降低了编写高性能内核的门槛。过去需要资深 CUDA 工程师花费数天调优的内核,现在通过 Tile 抽象有望在更短时间内达到接近最优的性能水平。
面向 Tensor Core 的原生优化
NVIDIA 的 Tensor Core 是加速矩阵运算的专用硬件单元,广泛用于深度学习训练和推理。CUDA Tile 的设计天然契合 Tensor Core 的工作方式——Tensor Core 本身就是以瓦片为单位执行矩阵乘加(MMA)运算的。
通过 CUDA Tile,开发者可以更自然地表达矩阵分块乘法(Tiled GEMM)等关键操作,充分释放 Tensor Core 的计算潜力,而不必深入处理 wmma 或 mma.sync 等底层 PTX 指令。
CUDA Tile 的适用场景
CUDA Tile 在以下几类场景中表现尤为突出:
- 高性能计算(HPC):科学模拟中的模板计算、FFT 等天然具有瓦片结构的算法
- 深度学习算子开发:自定义注意力机制、卷积等计算密集型操作的内核实现
- 图形渲染与图像处理:光线追踪、图像滤波等需要精细内存管理的应用
- 大规模 AI 推理部署:在已有 C++ 推理引擎(如 TensorRT)中集成高性能自定义内核
需要说明的是,CUDA Tile 并非要取代现有的 CUDA 编程方式,而是在其基础上提供了一个更高层次的选择。对于已经熟悉 CUDA 底层优化的工程师,Tile 抽象可以显著提高开发效率;对于 C++ 开发者,它降低了进入 GPU 高性能编程领域的技术门槛。
总结
NVIDIA CUDA Tile 的推出标志着 GPU 编程模型的又一次重要演进。从最初的 CUDA C 到后来的 CUDA C++,再到如今的 Tile-based 抽象,NVIDIA 持续在让 GPU 编程变得更高效、更易用这条路上前进。随着 AI 训练和 HPC 工作负载的持续增长,这种能够在不牺牲性能的前提下提升开发效率的编程模型,将被越来越多的开发团队采纳。
对于有兴趣尝试 CUDA Tile 的开发者,建议关注 NVIDIA 官方开发者博客和 CUDA Toolkit 的后续更新,获取详细的 API 文档和示例代码。
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。