NVIDIA Dynamo on Kubernetes:5分钟搞懂AI推理部署
NVIDIA Dynamo 用 Operator 模式把模型推理服务迁移为可重复的 Kubernetes 声明式部署。
文章基于 NVIDIA「Dynamo in 5 Minutes」系列,讲解如何把单机模型服务迁移到 Kubernetes 原生的 Dynamo 推理平台。核心思路是采用 Operator 模式:团队只声明期望的 serving 配置,由 Operator 调谐实际集群资源。部署有两条路径——意图驱动的 DGDR 只需描述模型、后端、工作负载、硬件与可选 SLA 目标,系统自动生成 DGD;或直接应用已验证的 DGD manifest 获得更精细控制。请求侧由前端暴露 OpenAI 兼容 API 作为稳定边界,后端 Worker 可运行 SGLang、TensorRT-LLM 或 vLLM。迁移建议是先映射现有配置跑通端到端,再按容量调整而非重构技术栈。
从单机模型服务到Kubernetes原生推理
很多团队最初用一台模型服务器跑Demo,简单直接。但当业务要求变成生产级别——需要OpenAI兼容端点、可伸缩的Worker、以及架构变化时不必重写胶水代码——单机方案就显得力不从心。NVIDIA在「Dynamo in 5 Minutes」系列中,用Ron的案例拆解了如何把推理服务迁移到Kubernetes上。
这个迁移的核心不在于把容器塞进集群,而在于让部署本身变成可重复的Kubernetes工作流,而不是一堆自定义脚本。视频中反复强调的「从单模型服务器到Dynamo部署」的问题,其实就是问:谁来做服务发现、扩缩容、路由、端点暴露和可观测性?Dynamo的答案是:交给Operator和声明式资源。
Operator模式:声明期望状态,让集群自动对齐
Dynamo在Kubernetes上采用Operator模式。Ron的团队只需要描述想要的serving配置,Kubernetes存储这个期望状态,Operator负责让真实集群与期望状态保持一致。这带来一个很直观的心智模型:定义部署请求→应用到集群→让Operator创建并管理各个组件→向OpenAI兼容端点发请求。
前置条件并不复杂:一个能访问所需GPU的Kubernetes集群,以及通过Dynamo平台Helm chart安装的Dynamo Operator。在此基础上,团队有两条路径可选。
路径一:DGDR(意图驱动)
DynamoGraph Deployment Request是意图驱动的路径。团队只需描述模型、后端、工作负载、硬件以及可选的SLA目标,Dynamo会分析这些输入并生成DynamoGraph Deployment(DGD)。这条路径把「我要什么」和「怎么实现」解耦,适合不想手写拓扑细节的团队。
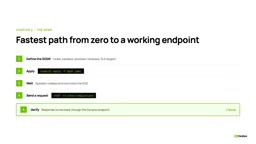
据视频演示的DGDR流程,操作只有五步:定义DGDR(含模型、后端、工作负载、硬件、可选SLA目标)→用kubectl应用→等待Operator创建并调谐DGD→向API端点发请求→验证响应确实来自Dynamo端点。这是从零到可用Dynamo端点最快的方式。
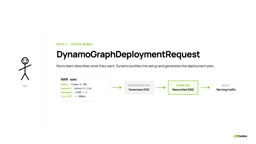
SLA 目标与意图驱动部署
在推理服务语境下,SLA 目标通常指延迟(如 P99 TTFT、端到端时延)、吞吐(tokens/s)或可用性等可量化指标。意图驱动路径的意义在于:用户不必手工决定副本数、并行策略或引擎参数,而是把这些目标连同模型、硬件一起声明出来,由系统推导出满足约束的拓扑。这使得同一份请求可以在不同规模集群上复用,也便于在硬件换代或流量模型变化时只调整目标而非重写部署细节。代价是系统需要具备足够的调优知识库与搜索能力,因此意图驱动更适合标准化程度高的常见模型与引擎组合。
路径二:直接使用DGD(预制配方)
如果团队已经有一份验证过的部署配方,可以直接从DGD manifest开始。此时用kubectl应用该manifest,Dynamo Operator会把推理图调谐成实际运行、承载流量的组件。这条路径给熟悉拓扑的团队更多控制权,代价是需要自己维护配方。
Kubernetes Operator 与 CRD
Operator 是 Kubernetes 的一种扩展模式:它把运维人员的领域知识编码进控制器(Controller),由控制器持续监听集群状态并执行调谐(Reconcile)循环,使实际状态向用户声明的期望状态收敛。支撑这一模式的是自定义资源定义(CRD,Custom Resource Definition)——它允许在 Kubernetes API 中注册新的资源类型,例如本文中的 DynamoGraph Deployment(DGD)。用户用 kubectl 提交一个 CR 实例后,API Server 只负责持久化这份声明,真正的「创建 Pod、配置 Service、挂载 GPU、暴露端点」等动作由 Operator 完成。相比 Helm 只能做一次性模板渲染,Operator 具备持续观测与自愈能力,这正是声明式部署与脚本化部署的本质区别。
请求路径:稳定API与可演进后端的分离
请求从前端进入:客户端调用Dynamo前端暴露的OpenAI兼容API,使用熟悉的routes;前端作为API边界,将请求路由到后端Worker;Worker运行模型引擎,可以是SGLang、TensorRT-LLM或vLLM,取决于部署配置。
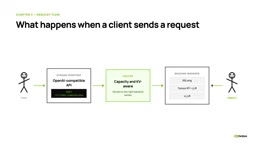
这种前后端分离的价值在于:客户端看到的是稳定API,而背后的serving平台可以持续演进。团队起步时可以只映射一个模型、一个引擎和一套Worker配置;需要扩容时,调整部署即可,不必重建整个栈。这也是视频中「after Dynamo」图景的关键——部署请求捕获意图,Operator管理生命周期,前端保持接口熟悉,Worker围绕模型和引擎选择灵活配置。
推理引擎的差异与选择
文中提到的三种引擎定位不同:vLLM 以 PagedAttention 和广泛的模型兼容性著称,生态活跃、上手快;SGLang 侧重结构化生成与前缀缓存,在 Agent、多轮对话等含大量共享前缀的场景中优势明显;TensorRT-LLM 由 NVIDIA 提供,通过编译优化与量化在特定 GPU 上追求极致性能,但需要针对模型做构建。三者都可以作为 Worker 的运行时,因此前端保持 OpenAI 兼容接口、后端按引擎切换,就能在不改变客户端代码的前提下做性能与成本的权衡。
迁移建议与实战路径
对于正在迁移小型现有端点的团队,视频给出的建议是:先把模型、引擎和Worker设置映射进部署请求中,从DGDR入手跑通端到端,验证OpenAI兼容端点可用后,再根据容量需求调整部署,而不是重构整个技术栈。
Dynamo把Kubernetes部署变得更容易接近、也更接近生产可用,靠的是几个清晰的概念:manifest、CRD、Operator流程、Worker以及OpenAI兼容端点。对于需要把推理服务从实验推向生产的团队,这套抽象降低了每次架构变更时的重复劳动。
常见问题
Dynamo Operator必须通过Helm安装吗? 视频中提到通常通过Dynamo平台Helm chart安装,这是推荐方式。
DGDR和DGD该怎么选? 想快速得到可用端点、不想手写拓扑,选DGDR;已有验证过的配方、需要精细控制推理图,直接用DGD。
Worker支持哪些推理引擎? 视频明确提到SGLang、TensorRT-LLM和vLLM,取决于部署配置。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。