NVIDIA FLARE联邦学习实战:跨Docker、K8s与Slurm扩展部署
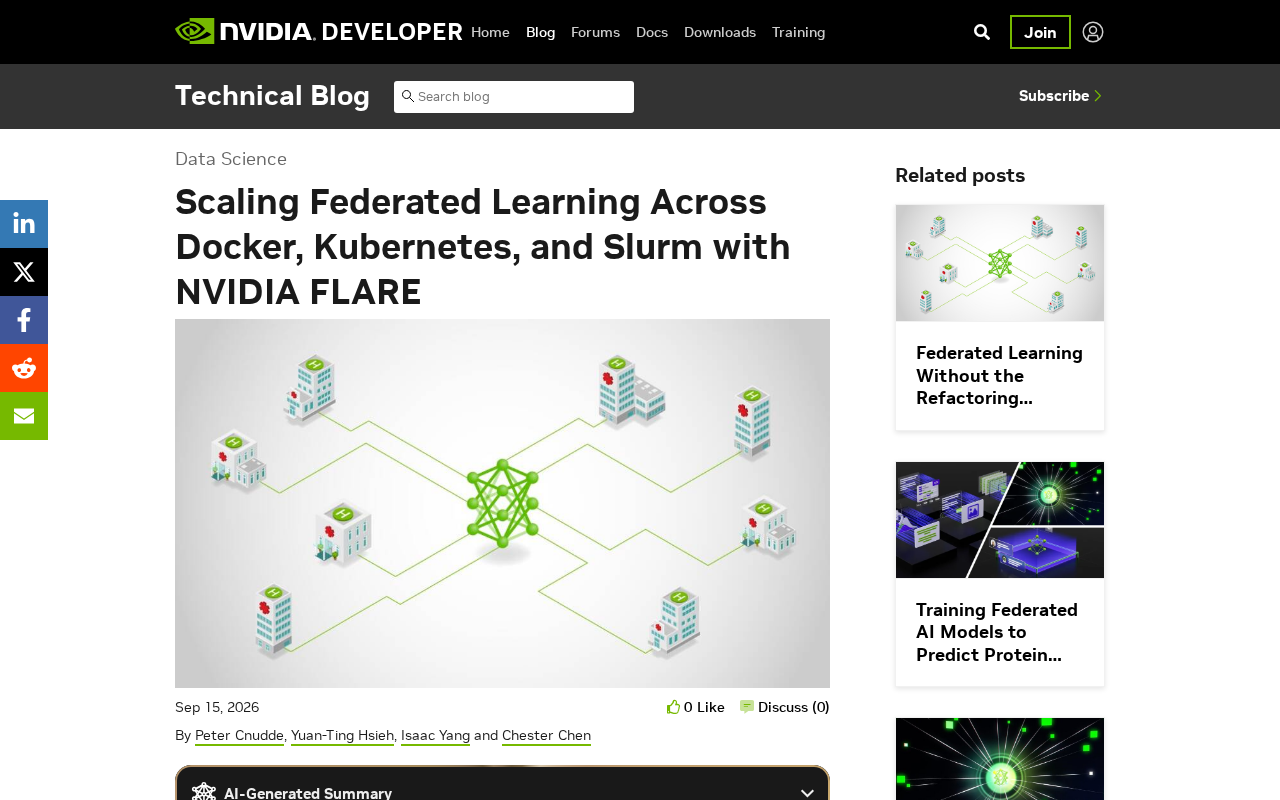
NVIDIA FLARE通过解耦应用逻辑与底层平台,让联邦学习跨Docker、K8s、Slurm无缝扩展至生产环境。
联邦学习以"数据不动、模型动"的范式保护隐私,但从实验原型走向真实部署时,跨机构协作中各方基础设施高度异构——Docker容器、Kubernetes集群、Slurm超算调度并存。NVIDIA开源框架FLARE通过将联邦学习的训练逻辑、聚合策略与底层运行环境彻底解耦,使同一套应用代码能够适配三大主流编排平台。Docker适合快速原型验证,Kubernetes提供生产级弹性伸缩,Slurm则让科研机构在既有GPU超算资源上直接运行联邦任务。这一跨平台能力大幅降低了多方协作的工程摩擦,为医疗、金融、基因组学等隐私敏感行业的联邦学习规模化落地提供了切实可行的技术路径。
联邦学习(Federated Learning, FL)的项目往往起步简单:一台服务器、几个客户端,每个站点各自持有一份数据集。但随着项目扩张——参与机构增多、数据规模膨胀、算力需求上升——原本的单机原型很快就会遇到部署与编排的瓶颈。如何把联邦学习工作负载平滑地扩展到 Docker、Kubernetes 和 Slurm 等主流基础设施上,成为从实验走向生产的关键一步。NVIDIA 推出的开源框架 FLARE(Federated Learning Application Runtime Environment)正是为解决这一挑战而设计。
联邦学习为何需要跨平台扩展
联邦学习的核心价值在于「数据不动、模型动」:各参与方无需上传原始数据,只在本地训练模型,再把模型更新汇聚到中央服务器进行聚合。这一范式在医疗、金融、基因组学等对数据隐私高度敏感的行业尤为关键。
然而,当一个 FL 项目从概念验证走向真实部署时,参与站点的基础设施往往千差万别。有的机构习惯用 Docker 容器快速起服务,有的已经在企业级 Kubernetes 集群上运行工作负载,而高性能计算(HPC)中心和科研机构则普遍依赖 Slurm 进行作业调度。一个成熟的联邦学习框架必须能够适应这种异构环境,而不是要求所有参与方统一到同一套技术栈上——这在跨组织协作中几乎不可能实现。
联邦学习的聚合过程通常采用 FedAvg(联邦平均)等算法:服务器将全局模型下发给各客户端,各方在本地数据上完成若干轮梯度更新后,把模型权重或梯度上传回服务器,服务器按样本量加权平均后生成新的全局模型,再进入下一轮通信。这一"本地训练→上传更新→全局聚合"的循环在小规模实验中易于实现,但在生产环境中面临多重挑战:网络延迟与带宽限制会影响通信轮次效率,各客户端的数据量与计算能力高度不均衡(Non-IID 数据分布问题),以及参与方随时可能掉线的拜占庭容错问题。这些挑战使得联邦学习框架不能简单地把单机分布式训练的思路照搬过来,而需要在编排层面专门处理异步通信、部分参与和容错恢复等场景。
FLARE 如何抽象底层基础设施
NVIDIA FLARE 的设计思路是将联邦学习的应用逻辑与底层运行环境解耦。开发者编写的训练任务、聚合策略等业务代码,可以在不做大量改动的情况下,部署到不同的编排平台上。
Docker:轻量起步与快速验证
对于早期实验和小规模站点,Docker 提供了最低的部署门槛。将 FLARE 的服务端与客户端打包为容器镜像,可以快速在单机或少量节点上拉起一个联邦学习环境,方便团队验证算法逻辑和通信流程。这一层级适合原型开发和功能测试。
Kubernetes:面向生产的弹性编排
当参与方数量增长、需要更高的可用性与弹性伸缩时,Kubernetes 成为自然选择。借助 K8s 的调度、服务发现、故障恢复与资源管理能力,FLARE 的联邦学习组件可以作为标准工作负载运行在企业集群中,实现自动扩缩容和滚动更新。对于已经在云原生环境中运营的企业客户,这条路径能够无缝对接现有的运维体系。
Slurm:对接高性能计算集群
在科研与 HPC 场景中,Slurm 是主流的作业调度器。大量 GPU 资源通过 Slurm 统一管理与排队。FLARE 支持将联邦学习任务提交为 Slurm 作业,使得研究机构能够在既有的超算基础设施上运行分布式训练,充分利用宝贵的 GPU 算力,而无需为联邦学习单独搭建一套集群。
Slurm(Simple Linux Utility for Resource Management)是学术界和国家级超算中心最广泛使用的开源作业调度系统。用户通过提交 sbatch 脚本来申请 CPU/GPU 节点、内存和运行时长,Slurm 负责排队、分配资源并在作业完成后回收。与 Kubernetes 的常驻服务模式不同,Slurm 以"批处理作业"为基本单元——每个作业有明确的开始和结束,资源在作业存续期间独占,结束后立即释放。这对联邦学习带来特殊挑战:联邦训练需要服务端与多个客户端在同一时间窗口内保持通信,而 Slurm 的排队机制可能导致各方作业不能同步启动。FLARE 对 Slurm 的支持需要解决这种时序协调问题,通常借助作业依赖(job dependency)或共享文件系统上的信号文件来同步各参与方的启动状态。
FLARE 实现底层解耦的核心机制是其"通信抽象层"与"执行器(Executor)"插件体系。联邦学习的业务逻辑——包括本地训练步骤、聚合算法、隐私保护机制(如差分隐私或安全聚合)——被封装在与平台无关的 Python 组件中。底层的进程启动、网络通信和资源申请则由对应平台的适配器负责。这意味着同一份训练代码,既可以在 Docker Compose 里通过本地网络通信,也可以在 K8s Pod 之间通过 Service 发现彼此,还可以在 Slurm 作业节点间通过 gRPC 长连接交换模型更新。这种架构也使 FLARE 便于集成差分隐私库(如 OpenDP)或硬件可信执行环境(TEE),在不改动业务层的前提下为不同部署环境叠加额外的隐私保障。
异构环境带来的现实价值
跨 Docker、Kubernetes 与 Slurm 的统一支持,其意义远不止于「技术上的兼容」。在真实的跨机构联邦学习协作中,不同参与方通常无法也不愿意改变自己的 IT 基础设施。医院的数据中心、银行的私有云、大学的超算中心,各有各的技术规范与安全策略。
FLARE 通过在框架层面吸收这些差异,让每个站点都能用自己最熟悉、最合规的方式接入同一个联邦学习网络。这大幅降低了多方协作的工程摩擦,也让联邦学习从「实验室里可行」向「生产环境可落地」迈进了实质性的一步。
对开发者与机构的启示
对于正在评估联邦学习方案的团队,FLARE 的跨平台能力提供了一条清晰的演进路线:从 Docker 快速原型起步,随着规模扩大迁移到 Kubernetes 保障生产稳定性,在需要大规模 GPU 训练时对接 Slurm 集群。整个过程中,上层的联邦学习应用逻辑保持相对稳定,降低了重构成本。
作为开源框架,FLARE 也让社区能够针对特定行业与场景做二次开发和扩展。对于隐私敏感行业而言,能够在既有基础设施上安全、可扩展地运行联邦学习,正是推动这一技术真正规模化落地的前提条件。
相关推荐
Python接单实战:接单平台选择与报价避坑指南
Python接单副业实战经验分享:闲鱼、淘宝、BOSS直聘三大接单平台对比,100元到10K不同单价梯度的技术要求与报价逻辑,以及新手应具备的爬虫、数据处理技能。同时理性剖析高收入宣传背后的真实门槛与避坑要点。
AI Agent是什么?从聊天机器人到数字员工的落地逻辑
AI Agent是什么?它是能替人干活的数字员工,能读数据、调接口、拆任务、自我纠错。本文解析Agent与聊天机器人的区别、客服/财务/运营等企业落地场景,以及为什么「能落地」的人才最稀缺。
OpenAI对Cursor断供内幕:SpaceX收购引发的模型战争
OpenAI宣布终止与Cursor合作,将于11月12日切断模型访问。本文深度解析SpaceX收购Cursor引发断供的真正原因——模型蒸馏、数据争夺与即将发布的Astra,以及开发者的应对方案。