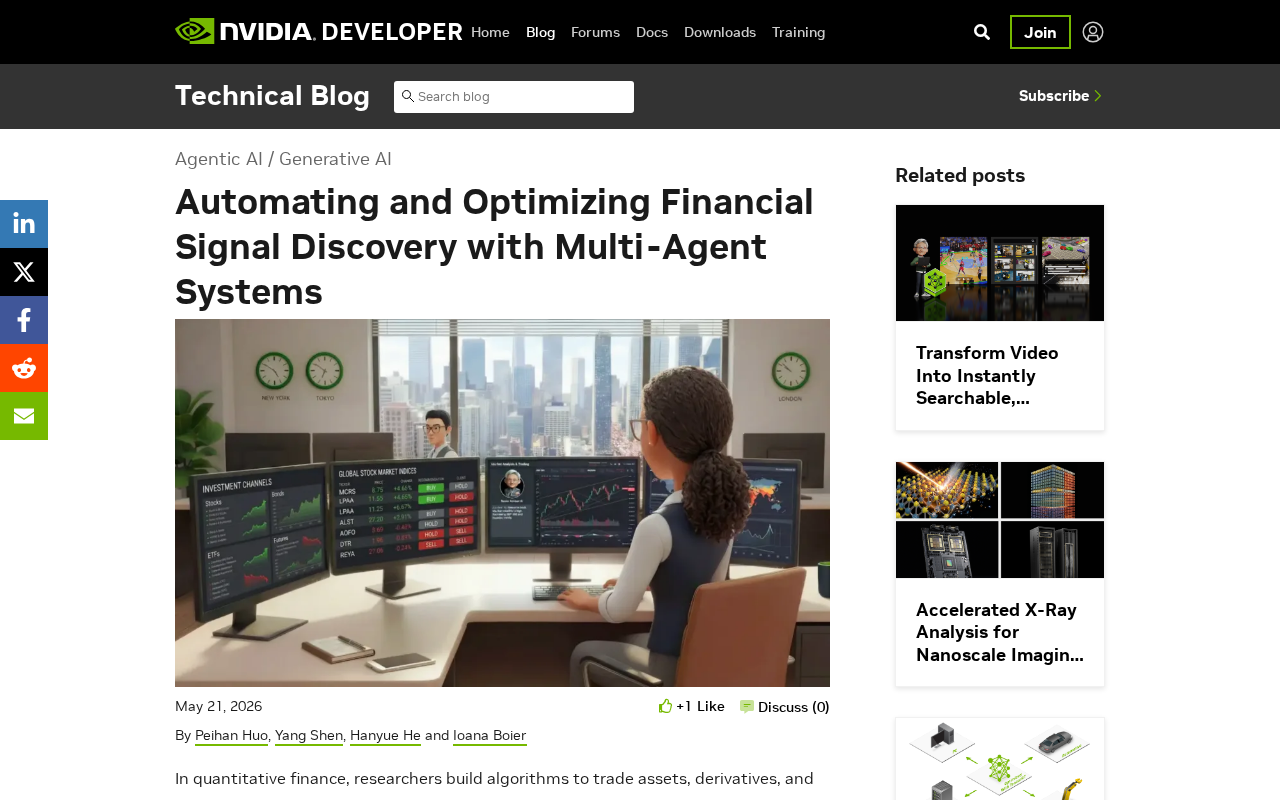
NVIDIA多智能体系统如何自动化金融信号发现

NVIDIA提出用多智能体AI系统自动化量化金融信号发现流程
NVIDIA发布技术方案,利用多智能体系统(MAS)将量化金融信号发现流程自动化。系统由策略、数据、编码、回测、优化五类专业化智能体协作,模拟完整量化研究团队,将传统需数天的"假设-编码-回测-优化"周期缩短至分钟级。该方案兼具LLM金融推理能力和决策可解释性,但仍面临过拟合风险和LLM幻觉等挑战。
概述:当量化金融遇上多智能体AI
在量化金融领域,研究人员构建算法来交易资产、衍生品和其他金融工具。这项工作的核心在于发现交易信号——即能够预测市场走势的数据模式和特征。传统上,这一过程高度依赖人类专家的经验和直觉,既耗时又难以规模化。
NVIDIA近期发布的技术博客提出了一种全新思路:利用**多智能体系统(Multi-Agent Systems)**来自动化和优化金融信号的发现过程。这一方案将大语言模型(LLM)的推理能力与量化金融的专业工作流深度结合,标志着AI在金融领域应用的又一重要进展。
什么是金融信号发现?
信号的本质与历史渊源
在量化交易中,"信号"是指能够提供市场方向性预测的数据特征。举个例子,某只股票的成交量异常放大可能预示着价格即将波动,又或者宏观经济指标的变化可能影响整个板块的走势。量化研究员的日常工作,就是从海量数据中挖掘这些信号,并将其转化为可执行的交易策略。
量化交易本身起源于20世纪70年代,以爱德华·索普(Edward Thorp)和詹姆斯·西蒙斯(James Simons)为代表的先驱者将数学模型引入金融市场。西蒙斯创立的文艺复兴科技公司(Renaissance Technologies)旗下的大奖章基金,凭借系统性的信号挖掘方法,在数十年间实现了年均超过60%的惊人回报。这一历史不仅证明了量化信号的巨大价值,也奠定了现代量化金融的基础——信号发现的质量与效率,直接决定了量化策略的竞争力上限。
传统信号发现流程的瓶颈
传统的信号发现流程通常包括以下步骤:
- 假设生成:研究员基于市场理解提出交易假设
- 数据处理:收集和清洗相关金融数据
- 特征工程:构建可能具有预测力的特征
- 回测验证:在历史数据上测试信号的有效性
- 优化迭代:根据结果调整和改进信号
这个过程的主要痛点在于:每一步都需要高度专业化的人工介入,研究员需要同时具备金融直觉和编程能力,而且从假设到验证的迭代周期往往长达数天甚至数周。
多智能体系统的架构设计
多智能体系统的技术原理
多智能体系统(Multi-Agent Systems, MAS)是人工智能领域的一个重要分支,其理论根基可追溯至分布式人工智能(DAI)研究。在大语言模型时代,以AutoGPT、MetaGPT、CrewAI为代表的框架将MAS带入主流视野。这些框架的核心思想是:单一LLM在处理复杂、多步骤任务时容易出现上下文窗口限制和推理漂移,而将任务分解给多个专业化智能体,每个智能体聚焦于特定子任务,可以显著提升整体系统的可靠性和输出质量。在金融信号发现这类需要严格逻辑链条和专业领域知识的场景中,这一架构优势尤为突出。
分工协作的五类智能体
多智能体系统的核心理念是将复杂任务分解为多个子任务,由不同的专业化智能体分别处理。在金融信号发现场景中,这种架构可以模拟一个完整的量化研究团队:
- 策略智能体:负责生成交易假设和策略框架,类似于首席策略师的角色
- 数据智能体:负责数据获取、清洗和预处理,确保数据质量
- 编码智能体:将策略逻辑转化为可执行的代码,实现特征工程
- 回测智能体:在历史数据上运行策略并评估绩效指标
- 优化智能体:分析回测结果,提出改进建议并驱动下一轮迭代
智能体之间的协调与通信机制
多智能体系统的关键挑战在于智能体之间的协调。系统需要一个编排层来管理任务流转、处理依赖关系,并确保各智能体的输出能够被下游智能体正确消费。这种设计使得整个信号发现流程可以在最少人工干预的情况下自动运行多轮迭代。
技术优势与核心创新
自动化迭代大幅加速研究周期
传统量化研究中,一个信号从假设到验证可能需要数天甚至数周。多智能体系统能够在几分钟内完成一轮完整的"假设-编码-回测-优化"循环。更关键的是,系统可以并行探索多个方向,大幅扩展搜索空间。
LLM赋能的金融推理能力与边界
大语言模型在这一架构中扮演着核心角色。它们不仅能够理解金融领域的专业术语和概念,还能基于已有的金融知识生成合理的交易假设。这种能力使得系统不是简单的暴力搜索,而是具备了一定程度的"金融直觉"。
然而,LLM的金融推理能力存在明确的边界。GPT-4、Claude等通用模型经过大量金融文本训练,能够理解复杂的金融概念和市场机制;但LLM同时存在"幻觉"(Hallucination)问题——模型可能以高度自信的语气生成看似合理但实际错误的金融逻辑。Bloomberg专门针对金融领域训练的BloombergGPT,以及各大机构正在探索的金融专用微调模型,代表了提升LLM金融推理可靠性的重要方向。在多智能体系统中,引入专门的"验证智能体"对LLM输出进行事实核查,是缓解幻觉风险的关键设计选择。
决策过程的可解释性与透明度
与纯黑箱的机器学习模型不同,多智能体系统的每一步决策都有明确的推理链路。策略智能体会解释为什么提出某个假设,优化智能体会说明为什么建议某种调整。这种透明度对于金融领域的合规要求至关重要。
实际应用场景与面临的挑战
四大典型应用场景
这一技术方案适用于多种量化金融场景:
- Alpha信号挖掘:自动发现具有超额收益预测能力的因子
- 风险因子分析:识别和量化投资组合面临的风险暴露
- 另类数据整合:将新闻、社交媒体等非结构化数据转化为交易信号
- 策略原型快速验证:加速从想法到初步验证的过程
落地过程中的主要挑战
尽管前景广阔,多智能体金融系统在实际落地中仍面临若干挑战:
- 过拟合风险:自动化系统可能生成在历史数据上表现优异但缺乏泛化能力的信号。这一问题在量化金融中由来已久——坎贝尔·哈维(Campbell Harvey)等学者的研究表明,金融学术文献中大量被发表的因子可能都是"回测过拟合"或"数据窥探偏差
相关推荐
AI Agent Skill 设计深度解读:Anthropic 与 Perp…
AI Agent Skill 设计深度解读:Anthropic 与 Perplexity 的工程实践
深度解读 Anthropic Claude Code 团队与 Perplexity Agent 团队的 Skill 设计哲学,涵盖税收测试、Gotchas 飞轮、渐进式披露、Eval-First 流程等核心原则,帮助工程师构建高质量 AI Agent 技能系统。
OpenAI 官方 GPT-5.6 提示词指南深度解读:从手动挡到自动挡的范…
OpenAI 官方 GPT-5.6 提示词指南深度解读:从手动挡到自动挡的范式转变
深度解读 OpenAI 官方 GPT-5.6 Sol 提示词指南:精简优先、结果导向、自主权边界、工具路由、推理强度调节等核心变化,帮助开发者快速适配新一代模型。
 深度解读
OpenClaw开源小龙虾AI Agent运作原理深度解析
深度解析OpenClaw(开源小龙虾)AI Agent的底层运作原理,涵盖System Prompt、工具调用、SubAgent分身、Skill系统、记忆机制与Context Engineering等核心概念,帮你彻底理解AI Agent与普通语言模型的本质区别。