Ollama v0.40.0发布:Apple Silicon默认启用MLX推理引擎

Ollama v0.40.0 将 MLX 设为 Apple Silicon 默认推理后端,Mac 用户本地跑模型将更贴近硬件原生性能。
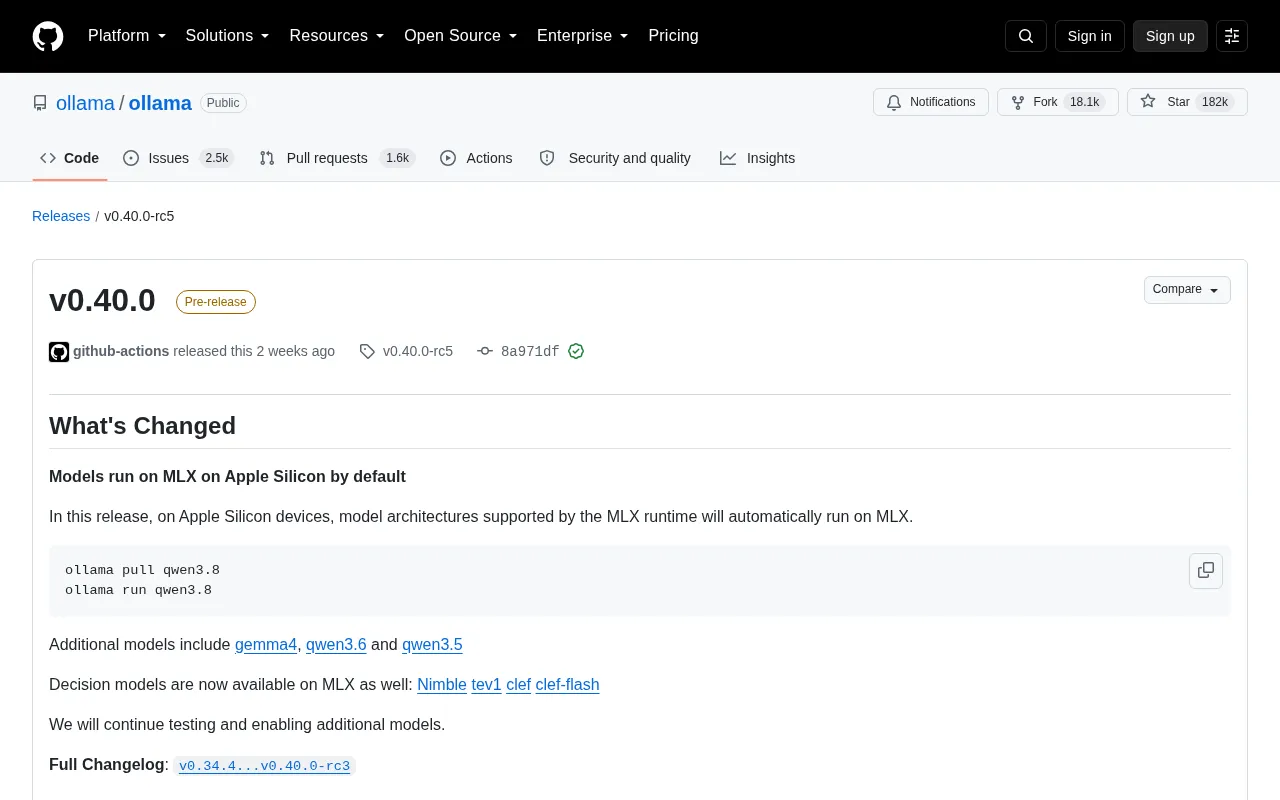
Ollama v0.40.0(预发布)带来一项核心变化:在 Apple Silicon 设备上,受 MLX 运行时支持的模型架构将默认通过 Apple 自研的 MLX 框架运行,取代此前基于 llama.cpp 的推理路径。MLX 专为 M 系列芯片统一内存架构设计,能更充分利用 GPU 与内存带宽。本次更新新增支持 gemma4、qwen3.6、qwen3.5 等通用模型,以及 Nimble、tev1、clef、clef-flash 等 Decision 类专用模型。对用户而言,命令行操作方式不变,底层切换完全透明;但需留意当前版本仍为预发布状态,MLX 支持的模型覆盖范围还在持续扩展,不在清单内的模型仍走原有路径。
Ollama 发布了 v0.40.0 版本(当前为预发布状态),这次更新最核心的变化是:在 Apple Silicon 设备上,受 MLX 运行时支持的模型架构将默认通过 MLX 运行。对于大量使用 Mac 本地跑大模型的开发者来说,这是一次值得关注的底层调整。
MLX 成为 Apple Silicon 的默认后端
长期以来,Ollama 在 Mac 上主要依赖 llama.cpp 系的推理路径。此次 v0.40.0 把 Apple 自家的 MLX 框架推到了默认位置——只要模型架构被 MLX 运行时支持,就会自动走 MLX 路径执行。
MLX 是 Apple 专门为 Apple Silicon 的统一内存架构设计的机器学习框架,能够更充分地利用 M 系列芯片的 GPU 与内存带宽。将其设为默认,意味着在兼容模型上,Mac 用户有望获得更贴近硬件原生能力的推理表现,而无需手动切换运行时或额外配置。
从使用方式看,命令行调用保持了一贯的简洁风格:
ollama pull qwen3.8
ollama run qwen3.8
用户无需为了启用 MLX 而改变自己的操作习惯,底层后端的切换对上层使用是透明的。
MLX 与此前默认使用的 llama.cpp 在定位上有本质区别。llama.cpp 是一个跨平台 C++ 推理库,通过 Metal 后端在 Mac 上调用 GPU,但其架构需要兼顾 x86、ARM、CUDA 等多种运行环境,无法对 Apple Silicon 的统一内存(Unified Memory)架构做深度定制。MLX 则是 Apple 团队专门为 M 系列芯片开发的机器学习框架,其最大特点是 CPU 与 GPU 共享同一块物理内存,无需在两者之间复制数据,这在推理时可以显著降低内存带宽瓶颈、减少延迟。此外,MLX 原生支持 lazy evaluation(惰性计算)和自动图优化,使得在 Apple Silicon 上的矩阵运算和注意力机制计算效率更高。正因如此,对于主要在 Mac 上部署模型的用户,使用 MLX 路径相当于将底层计算从"通用兼容"模式切换到"硬件原生"模式。
新增支持的模型清单
官方 Release Notes 中列出了本次随 MLX 一同启用的模型。除了示例中出现的 qwen3.8,还包括以下几个:
- gemma4
- qwen3.6
- qwen3.5
此外,一批 Decision 类模型也开始在 MLX 上提供支持:
- Nimble
- tev1
- clef
- clef-flash
官方明确表示,这只是一个阶段性成果——团队会继续测试并逐步启用更多模型。换句话说,MLX 的覆盖范围目前仍在扩展中,并非所有模型都已完成适配。这也符合预发布版本的定位:先把默认行为落地,再持续补齐生态。
文中提到的"Decision 类模型"(如 Nimble、tev1、clef、clef-flash)是一类面向特定决策推理任务设计的专用模型,通常参数规模较小,但针对分类、路由或任务规划等结构化输出场景做了针对性优化。与通用对话模型相比,这类模型在本地端侧部署中的价值在于:低延迟、低内存占用,适合作为多代理系统中的调度器或工作流中的判断节点。MLX 对此类模型的支持,意味着开发者可以在 Mac 上构建以本地推理为核心的自动化流水线,而无需依赖云端 API,从隐私保护和离线可用性角度均有一定优势。
对本地部署用户意味着什么
对于以 Mac 为主力机的本地大模型用户,这一变更有几层实际影响。
首先是性能潜力。MLX 针对 Apple Silicon 做了深度优化,默认启用后,受支持的模型在推理速度与内存利用上可能更有优势。不过具体收益需要在各自的硬件和模型组合上实测,官方并未给出统一的性能数据。
其次是兼容性边界。由于目前只有部分模型架构被 MLX 支持,用户在升级后需要留意自己常用的模型是否在支持清单内。不在清单内的模型仍会走原有路径,这一点在排查性能差异时值得注意。
最后是版本稳定性。v0.40.0 当前标记为 Pre-release(预发布),对应的构建来自 rc5 候选版本。追求稳定的生产环境用户可以观望,等待正式版发布后再升级;而希望第一时间体验 MLX 默认后端的尝鲜者,则可以在测试环境中验证效果。
小结
Ollama v0.40.0 把 MLX 设为 Apple Silicon 的默认推理后端,是 Ollama 深度拥抱 Mac 生态的一个明确信号。配合 gemma4、qwen3 系列等多款新模型的支持,Mac 用户在本地运行大模型的体验有望进一步贴近硬件原生能力。考虑到仍属预发布阶段且模型覆盖持续扩展,建议用户根据自身场景权衡升级时机,并关注后续正式版的发布与模型支持进展。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。
Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。
Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。