OmniCam:在ComfyUI中实现Blender式3D相机控制
当AI视频遇上专业相机控制
在AI视频生成领域,创作者长期面临一个棘手的问题:如何精确控制画面的镜头运动?传统方式往往只能依赖文字提示词(prompt),用"缓慢推进""环绕拍摄"这类模糊的描述来引导模型,结果难以预料。而现在,一个名为 OmniCam 的 ComfyUI 自定义节点,正在将专业影视制作中的相机控制思路引入AI视频工作流。
据开发者 MajoorWaldi 在 Reddit 上的介绍,OmniCam 被定位为一个"迷你 Blender"式的工具,目标是将真实相机运动与 VFX(视觉特效)级别的控制能力直接嵌入到 ComfyUI 中,让创作者不再需要在提示词和第三方软件之间来回切换。
这里有必要简要介绍一下 ComfyUI 的背景。ComfyUI 是一个基于节点式工作流的开源图像/视频生成界面,用户通过连接不同功能的节点来构建复杂的AI生成管线。与 Automatic1111 等传统 WebUI 不同,ComfyUI 的核心优势在于其模块化架构——每个处理步骤都以可视化节点呈现,用户可以精确控制从噪声采样到 VAE 解码的每一个环节。这种架构天然适合插件扩展,催生了庞大的自定义节点生态系统,而 OmniCam 正是这一生态中最新的专业化扩展之一。具体而言,ComfyUI 的节点系统采用有向无环图(DAG)结构,数据从输入节点沿连线流向输出节点,每个节点封装了一个独立的处理函数。这意味着第三方开发者只需遵循统一的输入输出接口规范,就能将新功能无缝接入现有工作流。目前 ComfyUI 的自定义节点数量已超过数千个,涵盖了图像增强、视频插帧、LoRA 加载、ControlNet 预处理等几乎所有主流AI生成任务。正是这种"乐高积木"般的可组合性,使得像 OmniCam 这样的专业工具能够直接嵌入到用户已有的复杂工作流中,而不必重新搭建整条生成管线。
值得一提的是,ComfyUI 之所以能在短短两年内从一个个人项目成长为AI图像/视频生成领域最主流的工作流工具之一,很大程度上得益于其底层的执行引擎设计。与简单的顺序执行不同,ComfyUI 的执行器会分析整个节点图的依赖关系,自动进行拓扑排序,只重新计算发生变化的节点分支,并在可能的情况下复用之前的中间计算结果(即缓存机制)。这种智能执行策略对于迭代调参极为高效——当用户只修改了某个后处理节点的参数时,系统不需要重新执行上游的扩散采样过程,从而大幅节省了GPU计算时间。这种设计哲学也解释了为什么越来越多的专业工具选择以 ComfyUI 节点的形式发布,而非开发独立应用。
OmniCam三大核心模块解析
OmniCam 由三个功能模块构成,形成了一条从"提取"到"编辑"再到"转换"的完整相机运动流水线。
Extractor:从视频中还原相机运动轨迹
Extractor(提取器)负责从现有视频中恢复相机的运动轨迹。创作者可以拿一段实拍素材或参考视频,反向解析出其中的镜头运动数据。这一能力在实际应用中价值巨大——你可以直接"借用"一部电影的运镜方式,将其应用到自己的AI生成画面上,而无需从零手动设计相机路径。
从技术角度看,从视频中还原相机运动的能力依赖于计算机视觉领域的 SfM(Structure from Motion,运动恢复结构)或视觉里程计(Visual Odometry)技术。其核心原理是通过检测和匹配连续帧之间的特征点,利用对极几何约束来推算相机在三维空间中的位姿变化。所谓对极几何,是指当同一三维点被两个不同位置的相机观测时,两幅图像中的对应点、相机光心与三维点之间必然满足的几何约束关系——这一约束可以用基础矩阵(Fundamental Matrix)或本质矩阵(Essential Matrix)来数学描述,从而从二维图像对应关系中反推出相机的相对位姿。传统方法如 COLMAP 采用特征提取(如 SIFT)加多视图几何优化的管线,精度较高但计算耗时。近年来,基于深度学习的方法——如 DROID-SLAM、DUSt3R 等——大幅提升了运动估计的鲁棒性和精度。DROID-SLAM 通过端到端的可微分优化框架,将特征提取、匹配和位姿优化统一到一个神经网络中,能够处理传统方法容易失败的低纹理、运动模糊场景;而 DUSt3R 则采用了基于 Transformer 的架构,直接从图像对预测三维点云和相机参数,甚至不需要已知的相机内参。OmniCam 的 Extractor 模块正是将这类技术封装为 ComfyUI 节点,降低了使用门槛,使得即便不具备计算机视觉专业知识的创作者,也能一键完成从视频到相机运动数据的提取。
这项技术在影视工业中有着深厚的应用历史。在传统 VFX 管线中,"Match Moving"(运动匹配)或"Camera Tracking"(相机跟踪)是合成工作的第一步——特效团队需要从实拍素材中精确还原相机轨迹,才能将CG元素(如怪兽、爆炸、数字替身)以正确的透视和运动状态合成到画面中。PFTrack、SynthEyes、Blender 内置的运动跟踪器等都是这一领域的专业工具。OmniCam 的 Extractor 模块本质上是将这一传统 VFX 能力引入了AI视频生成的语境,但区别在于:传统 Camera Tracking 的目的是为了CG合成的几何一致性,而 OmniCam 中的用途是将提取的运动轨迹作为条件信号注入AI视频模型,引导模型生成具有特定运镜风格的画面。
Director:3D视口中的相机导演工具
Director(导演)是整个工具最具"Blender风格"的部分。它允许用户在一个 3D视口 中直接对相机进行动画制作和编辑。这种可视化的操作方式与传统影视软件的工作逻辑高度一致:你可以看到相机在三维空间中的位置、朝向和运动路径,并进行直观调整。相比盲目输入提示词,这种所见即所得的控制方式更符合专业创作者的习惯。
在传统影视制作中,相机的运动设计是一项极其精细的工作。导演和摄影师需要考虑焦距、运动速度曲线、关键帧插值方式等大量参数。所谓关键帧动画,是指创作者只需定义运动轨迹上的几个关键状态(如起始位置、中间位置和终点位置),软件会自动在关键帧之间进行插值以生成平滑的过渡运动。插值方式的选择对运动质感影响极大:线性插值会产生机械、匀速的运动,贝塞尔曲线插值则可以模拟自然的缓入缓出(ease-in / ease-out)效果——相机在起步时缓慢加速、在停止前逐渐减速,这与真实摄影机在物理惯性作用下的运动特征一致。此外,专业动画软件中还提供了 F-Curve 编辑器(函数曲线编辑器),允许创作者逐帧调整运动的加速度曲线。Director 模块将这种专业思路引入AI视频创作,意味着创作者可以像在 Blender 或 Maya 中那样,通过设定关键帧、调整贝塞尔曲线来精确控制相机的加减速和运动轨迹,而非依赖模型对自然语言的不确定性理解。
从用户交互的角度来看,Director 模块在浏览器环境中实现 3D 视口本身就是一项值得注意的工程挑战。传统的 3D 视口依赖 OpenGL 或 Vulkan 等底层图形API,而 ComfyUI 作为基于 Web 的应用,Director 模块很可能使用了 WebGL 或 Three.js 等 Web 3D 渲染框架来实现视口渲染。这意味着用户无需安装额外的图形软件,就能在浏览器中直接操作3D相机——包括平移、旋转、缩放视口,以及通过拖拽控制手柄来调整相机轨迹上的关键帧位置。这种"将专业3D工具嵌入Web界面"的做法,在降低使用门槛的同时,也不可避免地面临性能和交互精度方面的取舍——但对于相机路径设计这一相对轻量的3D任务而言,Web 端的性能通常是足够的。
Monitor:适配不同AI视频模型
Monitor(监视器)解决了兼容性问题——它负责将相机运动数据转换为不同视频模型可识别的格式。当前AI视频生成模型众多,各家对相机控制信号的接受方式并不统一,Monitor 让同一套运动设计能够灵活输出到多个模型,避免了重复劳动。
这一模块的必要性源于当前AI视频模型在相机控制接口上的显著碎片化。例如,Wan2.1 等模型支持通过 CameraCtrl 条件注入相机外参矩阵(4×4 变换矩阵形式,包含旋转和平移信息,完整描述了相机在世界坐标系中的位置和朝向),而一些模型则通过 ControlNet 方式接受光流图或深度图序列来隐式传递运动信息——光流图用二维向量场表示像素在连续帧之间的位移方向和大小,深度图则编码了场景中每个像素到相机的距离。还有模型采用 Plücker 坐标,这是一种用六维向量表示三维空间中射线方向的数学表示方法,在相机控制中常被用于编码每个像素对应的光线方向,从而为模型提供密集的视角信息而非仅仅是全局的相机位姿。不同模型之所以采用不同的控制格式,既有技术架构上的原因(如扩散模型的条件注入机制不同),也有研究团队的设计偏好差异。Monitor 充当了统一的翻译层,使得创作者只需设计一次相机运动,就能适配多种生成后端,这在模型快速迭代的当下尤为实用。
这种"统一抽象层"的设计理念在软件工程中有着广泛的先例。类似于图形API领域的 Vulkan/Metal/DirectX 之上的跨平台抽象层(如游戏引擎中的渲染抽象层),Monitor 模块的价值在于将上游的创作意图与下游的模型实现细节解耦。随着AI视频模型的快速迭代——从早期的 AnimateDiff、SVD(Stable Video Diffusion)到如今的 Wan2.1、CogVideoX、HunyuanVideo 等新一代模型——创作者如果需要为每个模型单独准备相机控制数据,工作量将极其繁重。Monitor 模块的存在使得当社区适配了新模型的格式转换后,所有用户的现有相机运动设计可以立即复用,这极大地延长了创作资产的生命周期。
OmniCam为什么值得关注
OmniCam 的意义不在于某个单一功能的实现,而在于它代表了AI视频创作的一个重要趋势:从提示词驱动转向参数化、可视化控制。
早期的AI视频生成几乎完全是"黑盒"式的——创作者输入文字,模型输出结果,中间过程不可控、不可复现。而随着技术成熟,专业创作者越来越需要精细的控制手段。相机运动作为影视语言的核心要素之一,其可控性直接决定了成片的专业度。一个简单的例子:同一个场景,使用缓慢的推轨镜头(dolly in)和使用变焦推进(zoom in)所传达的情绪截然不同——前者是相机在物理空间中沿轨道向前移动,改变了观众与主体的空间关系,画面中前景和背景的透视关系会随着相机位置的变化而自然变化,观众会产生一种"走进场景"的沉浸感;后者则是相机保持不动、仅改变镜头焦距,这会压缩前后景的透视感,产生一种空间被"挤压"的独特视觉效果。阿尔弗雷德·希区柯克在《迷魂记》中著名的"希区柯克变焦"(Vertigo Effect / Dolly Zoom)正是同时反向执行这两种操作(推轨的同时反向变焦)来制造眩晕不安的心理效果。这种微妙的影视语言差异,是文字提示词难以精确表达的——你无法在 prompt 中量化"以每秒 0.3 米的速度沿 Z 轴前进同时焦距从 35mm 变为 50mm",而参数化控制可以。
除了相机运动之外,AI视频生成中的可控性需求正在向更多维度扩展。例如,角色动作控制(通过骨骼姿态序列或动作捕捉数据驱动)、光照控制(指定光源位置、颜色和强度随时间的变化)、以及物理一致性控制(确保物体运动符合重力、碰撞等物理规律)等,都是当前研究和工具开发的热点方向。OmniCam 解决的是其中相机控制这一维度,但它所代表的"参数化条件注入"思路——即用结构化的数值数据而非自然语言来约束生成过程——预计将扩展到AI视频创作的各个层面。从这个角度看,OmniCam 可以被视为AI视频工具从"一维提示词"走向"多维参数空间"的标志性案例之一。
OmniCam 将 Extractor、Director、Monitor 三个环节打通,实际上是在 ComfyUI 这个开源生态中构建了一套接近传统 DCC(数字内容创作)软件的相机工作流。DCC 软件包括 Blender、Maya、Houdini、Cinema 4D 等传统三维制作工具,它们在影视工业中承担着建模、动画、渲染、特效模拟等核心任务,是《阿凡达》《复仇者联盟》等大片幕后的技术基石。当前业界正在出现一种明显的融合趋势:一方面,DCC 软件开始集成AI功能(如 Blender 的 AI 去噪器和程序化生成插件,Maya 中的 AI 辅助绑定工具,以及 Houdini 正在探索的神经网络驱动模拟);另一方面,AI 生成工具也在引入 DCC 软件的专业控制范式——除了 OmniCam 之外,Runway、Pika 等商业平台也在逐步增加相机控制、时间轴编辑等传统影视软件中的标准功能。OmniCam 恰好处在这一融合趋势的交汇点上。这种"把VFX工具搬进AI管线"的做法,正在成为提升AI视频实用性的关键路径——目标是让AI生成能力成为传统制作管线中可调用的标准化模块,而非一个独立运作的黑盒。从更宏观的视角看,这也反映了AI工具从"创意玩具"向"生产力工具"转型的必然要求:只有当创作者能够像控制传统软件一样精确地控制AI的输出,AI才能真正融入专业影视制作的工业管线。
这一融合趋势背后还有一个重要的产业背景值得关注。传统影视后期制作公司(如工业光魔 ILM、维塔数码 Weta Digital、Digital Domain 等)正在积极评估如何将AI视频生成技术纳入其现有管线。但这些公司对工具的核心要求之一是"确定性"——即相同的输入必须产生相同的输出,且每个参数的效果必须可预测。这与早期AI生成工具的随机性和不可控性形成了根本矛盾。OmniCam 等参数化控制工具的出现,正是在弥合这一矛盾:通过将相机运动从模型的随机采样过程中分离出来,变成确定性的外部条件输入,使得生成结果在运镜层面变得可重复、可微调。这对于需要多次迭代修改的商业项目而言至关重要。
OmniCam安装方式与当前状态
对于想要体验的用户,OmniCam 的部署门槛并不高。开发者提供了两种安装方式:
- 通过 ComfyUI 的 Manager 直接搜索安装(ComfyUI Manager 是社区维护的插件管理工具,类似于 VS Code 的扩展市场或 Python 的 pip 包管理器,用户可以一键浏览、安装和更新自定义节点,同时自动处理依赖关系。它极大地降低了 ComfyUI 生态中插件管理的复杂度,是大多数用户获取新节点的首选方式)
- 使用 Git clone 从 GitHub 仓库手动获取(适合需要跟踪最新开发分支或进行自定义修改的高级用户)
项目开源地址为 github.com/MajoorWaldi/ComfyUI-Majoor-OmniCam。
需要注意的是,开发者明确表示该项目"仍处于实验阶段"(still experimental),并公开征集社区反馈。这意味着当前版本可能存在稳定性或功能不完善的问题,但也正因为其开源和早期的特性,社区用户有机会参与到工具的迭代过程中。对于有一定 ComfyUI 使用经验的用户来说,尝试成本较低;而对于初学者,建议先熟悉 ComfyUI 的基本节点操作逻辑后再进行探索。此外,由于 OmniCam 涉及 3D 视口渲染和计算机视觉算法,对硬件可能有一定要求——尤其是 Extractor 模块在处理高分辨率视频时,GPU 显存和计算能力可能成为瓶颈。根据类似工具的经验,运行 SfM 或基于深度学习的运动估计算法通常需要至少 8GB 显存的独立GPU,而处理 1080p 以上分辨率的长视频时,16GB 或更高显存会更为从容。
结语
OmniCam 或许还不是一个成熟的商业级方案,但它清晰地指向了AI视频创作的未来方向:更专业、更可控、更贴近影视工业的工作流。当越来越多类似的工具在 ComfyUI 这样的开源生态中涌现,AI视频与传统影视制作之间的界限正在被逐步消融。对于关注AI视频前沿的创作者而言,OmniCam 这类将专业相机控制带入AI工作流的工具,值得持续跟踪。
核心要点
相关推荐
tiun.:为AI开发者打造的一站式认证与支付系统
登顶 Product Hunt 的 tiun. 为 AI 开发者提供认证、支付、账单、客户数据与分析的一体化系统,一条命令即可安装,帮助开发者当天上线付费产品。本文解析其定位、卖点与竞争格局。
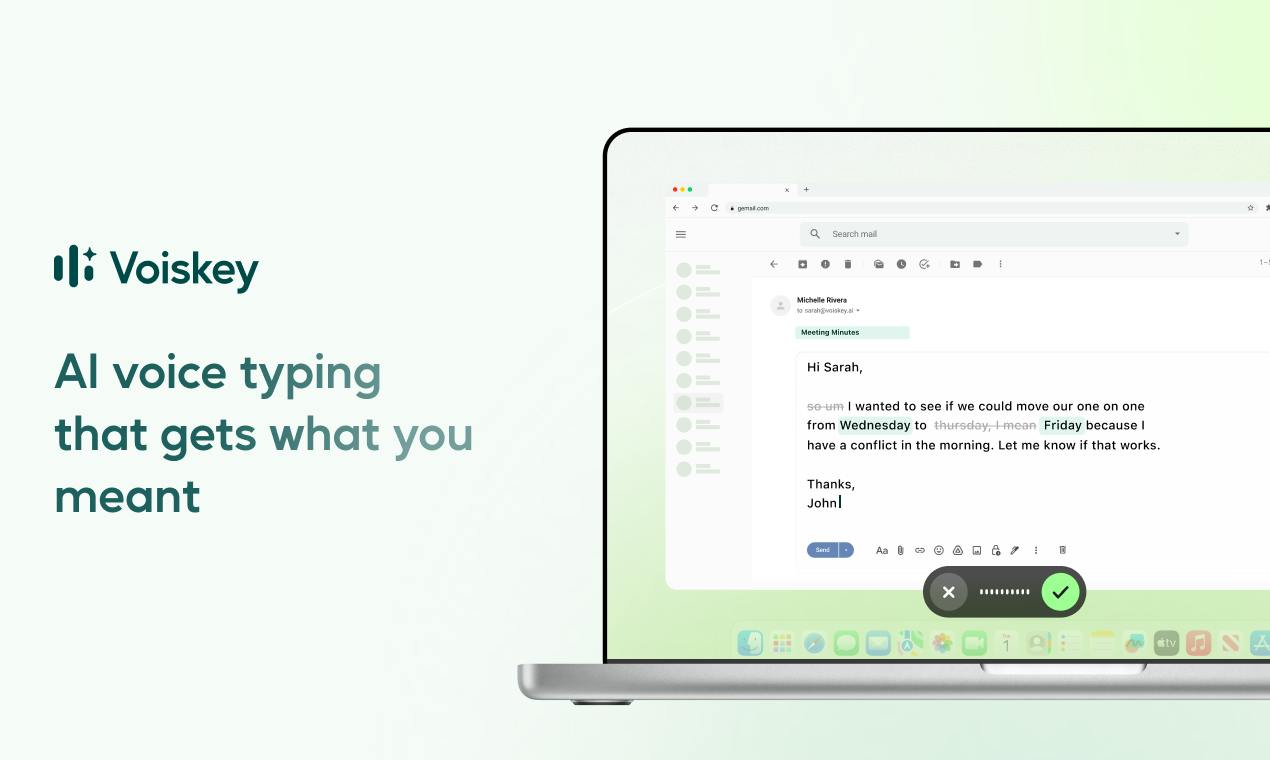
Voiskey:能读懂语境的AI语音输入工具
Voiskey是一款登上Product Hunt排名第3的AI语音输入工具,能根据场景和读者自动调整语气,比打字快5倍,支持iOS、macOS、Android、Windows四大平台及100多种语言。
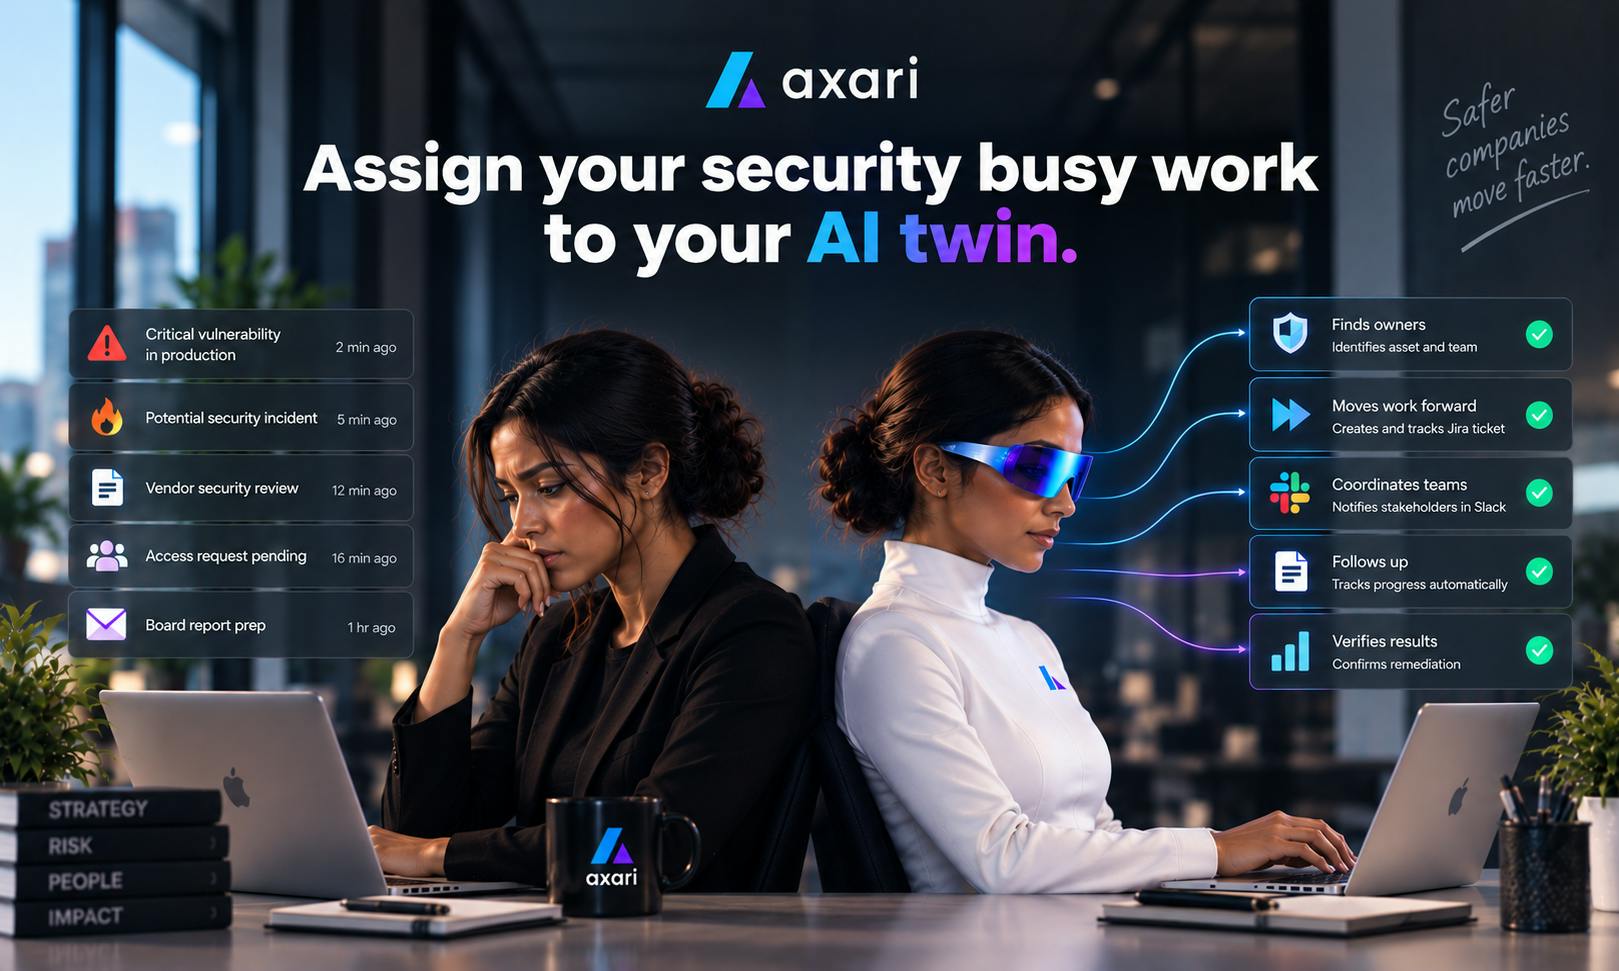
Axari:让AI分身接管你的安全运营琐事
Product Hunt新品Axari主打「AI分身」概念,帮安全团队自动处理重复性运营琐事,可在Slack、MS Teams中指派目标并自主推进任务。本文解析其产品逻辑、行业定位与需要冷静看待的问题。