OpenAI 13个月自研Jalapeño芯片:真能碾压英伟达吗?
OpenAI仅用13个月造出推理专用ASIC芯片Jalapeño,部分基准超越Blackwell,但数据选择性与ASIC固有局限仍存隐忧。
OpenAI于2024年10月启动代号Jalapeño的自研芯片项目,13个月后即送台积电流片。芯片采用ASIC路线,以700瓦功耗搭载约3倍于H100的显存和15.4 TB/s带宽,在8K 1K推理基准上吞吐量最高可达次优方案的9倍。然而,OpenAI仅公布了单一场景的测试数据,更贴近真实智能体使用的AgentX等基准缺席,性能稳定性尚未得到全面验证。在基础设施层,Jalapeño的scale-up带宽每GPU约600 GB/s,比英伟达NVL72慢66%,但通过全局scale-out以200 GB/s连接多达16个机柜加以弥补。芯片已能运行GPT-OSS、DeepSeek R1、Kimi K2.5等多家模型,且OpenAI正以自家模型反哺内核优化,形成"用AI造AI芯片"的研发闭环。OpenAI已启动第二代、第三代的开发,标志着AI行业的高速迭代正式蔓延至芯片与基础设施层。
OpenAI从2024年10月启动代号Jalapeño的自研芯片项目,仅用13个月就把首版设计送到台积电流片。这家以模型和智能体见长的实验室,突然拿出一款在推理任务上叫板英伟达Blackwell的芯片,让整个行业侧目。但当我们把初步基准测试和技术细节拆开看,故事远比"碾压英伟达"这个标题要复杂得多。
Jalapeño的账面数据有多亮眼
Jalapeño的初步基准跑出了相当激进的数字。在以100 tokens/秒的速度服务Kimi K2.5时,其吞吐量接近第二名的9倍,峰值吞吐可达700 tokens/秒。运行GPT-OSS 120B模型时,峰值更是冲到1500 tokens/秒,约为次优方案的两倍。
更值得关注的是功耗表现。Jalapeño的功耗约700瓦,与H100、H200相当,却搭载了近3倍于H100的显存容量、约5倍的带宽。对比Blackwell,它在相似显存容量下功耗低一半、带宽高一倍,背后是HBM4内存提供的15.4 TB/s带宽支撑。
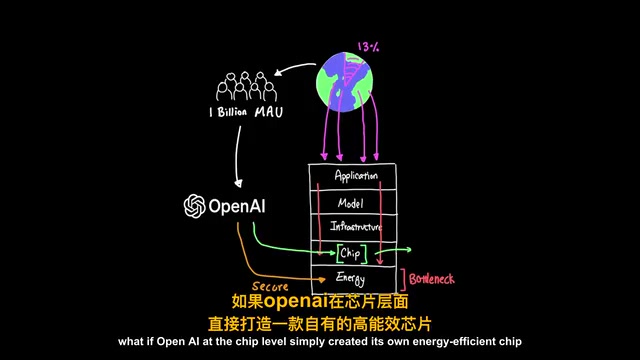
这套"低功耗、高带宽、大显存"的组合并非偶然。OpenAI月活已突破10亿,相当于服务全球13%的人口,数据中心的供电已成为实实在在的瓶颈。与其在能源层硬扛,不如在芯片层做一颗更省电的定制芯片——用更少的电做更多的事,这正是Jalapeño的设计动机。
通用芯片 vs ASIC:两种截然不同的路线
理解Jalapeño的关键,在于它和英伟达走的是两条路。英伟达做的是通用芯片(general purpose),既能训练也能推理,适应面广;OpenAI做的则是专用集成电路(ASIC),只针对极少数任务做极致优化。
这种差异直接体现在算力上。在FP8精度下,Jalapeño约为3.4 petaflops,高于H100、H200,但明显不及Blackwell,更远低于下一代Rubin。换句话说,如果只看原始算力,Jalapeño并不占优。
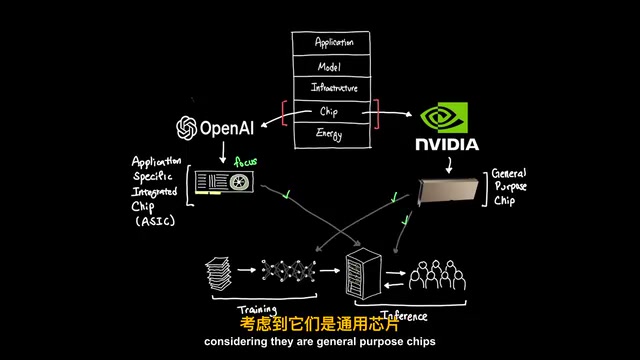
OpenAI的取舍很清晰:不追求全能,只把推理这件事做到又快又省电。推理本身分为pre-fill和decode两个阶段——decode阶段受带宽约束,pre-fill阶段则依赖算力与显存容量。Jalapeño把资源重点压在带宽和显存上,恰好对准了大规模推理服务的实际瓶颈。
ASIC(Application-Specific Integrated Circuit,专用集成电路)是针对特定工作负载从头定制的芯片,与通用GPU相比,它可以在电路层面裁剪掉所有"用不到"的逻辑单元,把省下的面积和功耗全部押注在目标场景上。谷歌的TPU是AI领域最早规模化落地的ASIC之一,专为矩阵乘法密集的神经网络训练和推理设计;亚马逊Trainium/Inferentia、Meta的MTIA也走同一路线。ASIC的代价是灵活性:一旦流片(即将设计图纸送到晶圆厂生产),电路结构就无法再改,任何超出设计假设的新算子或新精度格式都可能需要软件层大量弥补甚至等待下一代硬件。这也解释了为什么ASIC厂商通常要在模型架构相对稳定后才能发挥最大优势——押错了赛道,代价极高。
一个被刻意挑选的基准测试
漂亮的数字背后藏着一个需要警惕的细节。OpenAI公布的基准标注为"8K 1K",这是开源测试套件InferenceX中的一项,模拟8000输入token、1000输出token的场景。问题在于,OpenAI只放出了这一个版本。
真正能考验芯片极限的是AgentX这类测试——它衡量芯片在智能体场景下的表现,涉及大量来回调用、长上下文和长时间运行的会话,更贴近真实使用情况。而这些数字OpenAI至今没有公开。
合理的推测是:OpenAI可能尚未针对8K 1K以外的场景把芯片和配置完全调优。初步数据确实亮眼,但Jalapeño在不同类型推理任务上的稳定性还没有被证明。把一张单一切片的基准图,直接解读为"英伟达退位",显然为时过早。
ASIC还有一个通用芯片没有的固有风险:它必须对上层需求做出更大胆的假设。一旦模型层出现全新架构,或者应用层的智能体调用方式发生根本改变,直接吃亏的就是下面这颗高度定制的芯片。
「8K 1K」这一标注描述的是大语言模型推理中的输入/输出token比例:8000个输入token(即prompt长度)对应1000个输出token(即模型生成的回复长度)。这个比例对推理芯片的压力分布有决定性影响——较长的输入会加重pre-fill阶段的算力和显存访问需求,而输出token数量则直接决定decode阶段的持续时长。真实应用场景的token分布往往差异巨大:简单问答可能只有几百输入token,而智能体执行多步骤任务时输入上下文可能超过十万token,输出也可能延伸数千步。AgentX等测试套件正是为了模拟这种多轮、长上下文、高并发的智能体工作负载而设计。单一的8K 1K测试点,只能反映芯片在特定输入输出比下的吞吐表现,无法代表芯片在整个推理任务分布上的综合能力。
Scale-up与Scale-out:基础设施层的较量
DeepSeek广告 R1、Kimi K2.5这样的模型根本塞不进单颗芯片,必须靠scale-up(机柜内芯片间通信)和scale-out(多机柜互联成集群)来堆叠算力。不同厂商在这里各显神通。
英伟达用NVL72:单机柜内两颗Blackwell GPU配一颗Grace CPU,通过NVLink C2C连接,整机柜72颗GPU用NVLink和NVSwitch缝合成一台"大机器",每GPU提供900 GB/s。
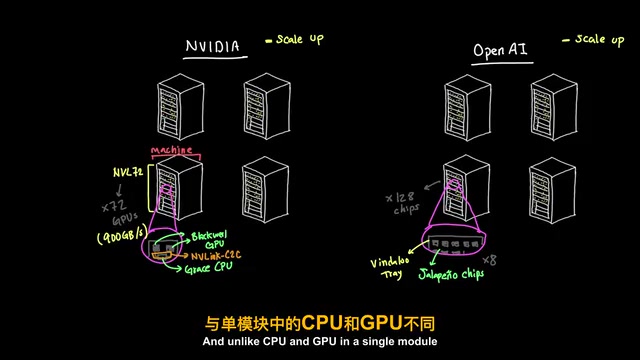
OpenAI则不同:8颗Jalapeño装在一个Vindaloo托盘上,每机柜16个托盘共128颗芯片。它没有像英伟达那样把CPU和GPU放进同一模块,而是把CPU单独放进Katsu托盘,用交换机连接。这套方案每GPU提供600 GB/s,约比NVL72慢66%。
在scale-out层面,英伟达用InfiniBand通过外部交换机连接多机柜;Jalapeño则采用所谓"全局scale-up",以200 GB/s连接多达16个机柜,这种立方体式的3D拓扑思路,颇有几分Google TPU的影子。
Scale-up与scale-out是分布式计算中两种截然不同的扩展策略。Scale-up(纵向扩展)指在单一节点或机柜内部增加芯片数量,并用高速互联(如NVLink、片间总线)将它们连成一个共享内存的逻辑整体,好处是通信延迟极低、带宽极高,但受限于机柜物理空间和功耗上限。Scale-out(横向扩展)则是把多个独立节点通过网络(如InfiniBand、以太网)连接成集群,理论上可以无限扩张,但节点间带宽和延迟远不及机柜内互联,模型并行切分的通信开销会随规模上升而显著增大。对于千亿至万亿参数的大模型推理,两种策略需要同时运用:先在机柜内最大化scale-up带宽以减少跨节点切分,再通过scale-out把多个机柜组成更大集群。Jalapeño选择将CPU与GPU分离、以交换机连接的设计,在scale-up带宽上做出了妥协,换取了更灵活的机柜配置与更低的散热压力。
别急着给英伟达判死刑
英伟达能长期把持市场,靠的不只是硬件,还有CUDA内核这样的软件护城河。通用芯片需要支持五花八门的用例,而OpenAI可以只支持推理时真正需要的特定算子。
一个常见误解是OpenAI的内核只能跑GPT模型。但基准里它同时跑了GPT-OSS 120B、DeepSeek R1和Kimi K2.5——这些来自不同实验室、采用不同MoE和注意力机制的模型,说明Jalapeño的适用范围可能比想象中宽得多。OpenAI还提到,自家最新模型正在反过来加速Jalapeño内核的优化与编程,形成一种"用AI造AI芯片"的循环。
真正令人震撼的,是这条产业链的协作规模。七个月前OpenAI锁定近40%全球DRAM产能、一度推高内存价格,如今这些产能落到了HBM4上;它与博通合作设计芯片,与Celestica合作托盘与机柜,还要搞定光学组件、交换机、数据中心的散热与网络。在如此紧绷的半导体供应链下,13个月做出一颗在部分基准上超越Blackwell的原型,确实堪称疯狂。
OpenAI已经在做Jalapeño的第二代和第三代。这意味着行业的高速迭代不再只发生在模型层和应用层——芯片和基础设施层,也开始以同样的速度奔跑。
相关推荐
手机直接运行AI编程Agent:无需Termux和Root的实践
一位Reddit用户成功在Android手机上直接运行Claude Code和DeepSeek的AI编程Agent,无需Termux或Root,借助开源harness绕开PRoot环境配置难题,但续航问题依然明显。
财务自由计算器:算清工作多久才能提前退休
一款登上 Hacker News 热榜的财务自由计算器,帮你算清按当前薪水还需工作多久才能进入 Coast 滑行状态或提前退休。解析 FIRE、4% 法则与工具背后的复利逻辑。
AI产品经理如何撰写Skill需求文档:模板与实战方法
AI产品经理如何撰写Skill需求文档?本文梳理出命名、概述、实现逻辑、输出效果、错误处理五大模板要素,并对比完全AI生成、手写+AI润色、纯手写三种写作方式的优劣,助你高效产出研发可落地的Skill需求文档。