OpenAI Agents SDK Guardrails 实战:拦截危险输入与输出

OpenAI Agents SDK 的 Guardrails 通过输入、输出、工具三层装饰器机制,为生产级 AI Agent 提供可配置的安全拦截防线。
本文介绍了 OpenAI Agents SDK 中的 Guardrails(护栏)机制,它将 AI Agent 的安全防护分为三层:Input Guardrail 在模型调用前拦截不合规输入,Output Guardrail 在模型响应就绪后过滤危险输出,Tool Guardrail 则在工具参数已知但副作用未发生时介入。三层护栏均通过 Python 装饰器实现,返回带有 `tripwire_triggered` 字段的标准输出对象,一旦触发即抛出对应异常终止流程。此外,`run_in_parallel` 参数提供了护栏与模型调用并行或串行的选择,直接影响响应延迟与 token 成本的权衡。整套机制以最小侵入性将安全逻辑与业务逻辑解耦,是构建面向真实用户的 Agent 应用的关键基础设施。
什么是 Guardrails:Agent 的三层安全防护
在构建生产级 AI Agent 时,一个绕不开的问题是:如何阻止不该进入模型的输入,以及如何拦截不该返回给用户的输出。OpenAI Agents SDK 提供的 Guardrails(护栏)机制正是为此而生。
按照这期 YouTube 教程的讲解,Guardrails 本质上是围绕 Agent 运行的"检查器"(checks that run around an agent),一共分为三层:
- Input Guardrail:在模型运行前检查用户输入
- Output Guardrail:在模型给出答案后检查响应内容
- Tool Guardrail:在工具(tool)被调用前进行拦截
视频用了一个形象的比喻——"隐藏村落不能让 Agent 传授禁术"。无论是用户诱导模型输出敏感信息,还是模型本身试图通过工具调用执行危险操作,都可以通过这三层护栏逐一拦截。
Input Guardrail:在模型运行前拦截
Input Guardrail 是一个在模型调用之前运行的装饰器(decorator)。实现时需要从 SDK 导入 Agent、GuardrailFunctionOutput、RunContextWrapper 和 input_guardrail 这几个核心对象。
其中 GuardrailFunctionOutput 决定了护栏函数的返回内容,RunContextWrapper 用于在运行过程中传递和持有上下文(context)值并交给回调使用。
具体实现上,定义一个函数(如 block_input),接收三个参数:context、agent 和 user input(类型为 string 或 list),并在函数上加 @input_guardrail 装饰器,把普通函数转换为护栏。函数的返回类型必须是 GuardrailFunctionOutput。
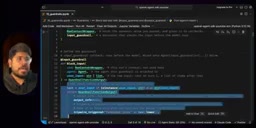
由于输入可能是列表,处理逻辑会先把输入统一转换成文本:如果是字符串就直接取用,否则做类型转换。随后返回 GuardrailFunctionOutput,其中两个关键参数是:
output_info:附带的额外信息(如原因或分数),示例中传入Nonetripwire_triggered:触发条件,当文本中包含 "forbidden jutsu"(禁术)时设为触发
一旦 tripwire 被触发,SDK 就会抛出 InputGuardrailTripwireTriggered 异常,阻止请求进入模型。
装饰器(decorator)是 Python 的一种语法糖,本质上是一个接收函数并返回新函数的高阶函数,用 @decorator_name 语法附加在函数定义上方。在 OpenAI Agents SDK 中,@input_guardrail 装饰器做的事情是把一个普通 Python 函数"注册"为护栏检查器,让 SDK 在合适的时机自动调用它——开发者不需要手动将检查逻辑嵌入调用链,SDK 在内部统一管理护栏的触发与异常抛出。tripwire(绊线)这个命名也值得理解:它借用了现实中触发报警的绊绳概念,一旦 tripwire_triggered=True,SDK 就像踩到绊线一样立即中止当前流程并抛出对应异常,而不是等待整个管线跑完再做判断。这种"早失败"设计能将安全问题尽可能前置拦截。
Output Guardrail:在答案就绪后检查
Output Guardrail 的结构与 Input Guardrail 几乎一致,区别只在于执行时机——它在模型给出答案之后(run after the answer is ready)才运行,而 Input Guardrail 在模型调用之前运行。
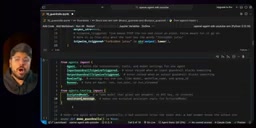
实现时导入 output_guardrail 替代 input_guardrail,函数同样接收 context、agent、output 三个参数,并返回 GuardrailFunctionOutput。当输出中出现 "forbidden jutsu" 时触发护栏。
视频中用 ScriptedModel 构造了两个 dummy 响应来验证效果:一条查询在输入中提及禁术,另一条在输出中提及禁术。运行后可以清楚看到——第一条触发了 InputGuardrailTripwireTriggered,第二条触发了 OutputGuardrailTripwireTriggered,两层护栏各司其职。
Tool Guardrail:工具调用前的最后一道关卡
第三层护栏针对工具调用。它通过 @tool_input_guardrail 装饰器,在工具真正执行之前(right before the tool runs)介入。

工具护栏的返回对象是 ToolGuardrailFunctionOutput,它支持三种动作:allow(放行)、reject(拒绝)、raise error(抛错)。
示例逻辑是检查 data.context.tool_arguments(转小写后)是否包含 forbidden 字符串:
- 如果包含,则调用
ToolGuardrailFunctionOutput.reject_content,并返回拒绝消息,如 "That jutsu is forbidden by the hidden village" - 如果不包含,则返回
allow,正常执行
随后用 @function_tool 把一个普通函数(如 use_jutsu)转换为工具,并在其中挂载 tool_input_guardrail 列表。实测中,"forbidden ceiling jutsu" 被拦截并返回禁术提示,而 "fireball jutsu" 则正常执行,验证了基于参数内容的精准拦截。
@function_tool 装饰器是 OpenAI Agents SDK 将普通 Python 函数暴露为可供模型调用的工具(function calling)的方式。模型在推理过程中并不直接执行代码,而是输出一段结构化的"工具调用意图"(包含工具名和参数),SDK 解析该意图后才真正调用对应函数。Tool Guardrail 正是介入在"SDK 解析意图"到"实际执行函数"之间的那个空隙——此时工具参数已经确定,可以对其内容做检查,但副作用尚未发生。这一特性让 Tool Guardrail 尤为适合防御提示注入(prompt injection)攻击:攻击者可能通过精心构造的用户输入,诱导模型生成携带恶意参数的工具调用,而 Tool Guardrail 能在这些参数真正触达外部系统(如数据库、API)之前将其拦截。
run_in_parallel:性能与成本的权衡
视频中一个值得深入的细节是 Input Guardrail 的 run_in_parallel 参数,它直接影响护栏与模型调用的执行方式。
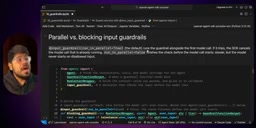
run_in_parallel=True:护栏与第一次模型调用同时启动。如果护栏触发(trips),SDK 会取消(cancel)正在运行的模型调用。响应更快,但可能产生一次已经发起的模型调用。run_in_parallel=False:先执行护栏检查,只有通过后才进入模型。速度较慢,但能避免不必要的模型调用(即节省 token 成本)。
这是一个典型的"延迟 vs 成本"权衡。如果对响应速度敏感,选择并行;如果希望严格节省 API 调用成本,选择串行。实际选择取决于业务需求。
理解这个权衡需要知道大语言模型 API 的计费方式:通常按输入和输出的 token 数量收费,每次发出请求、无论结果是否被使用,都会产生费用。当 run_in_parallel=True 时,护栏检查与模型推理同时启动,即便护栏最终触发并取消了模型调用,那次已经发出的请求所消耗的 token 依然计入账单。对于触发频率较高的场景(例如高流量应用中有大量恶意或不合规输入),并行模式可能带来可观的额外成本。反之,run_in_parallel=False 虽然增加了端到端延迟(需串行等待护栏通过),但能做到"零无效调用"。在设计时,可以根据业务的违规率估算两种模式的成本差异,再结合用户对响应时延的敏感程度做出选择。
真实 LLM 场景下的综合验证
教程最后用真实 LLM 调用(需加载 OpenAI API Key)把三层护栏串起来演示。通过一个 count_model_calls 回调函数追踪实际发生了多少次模型调用,可以直观观察并行与串行模式下的差异。
综合测试结果显示:
- 输入含禁术 → 触发
InputGuardrailTripwireTriggered - 输出含禁术 → 触发
OutputGuardrailTripwireTriggered - 调用 "forbidden ceiling jutsu" 工具 → 被 tool guardrail 拦截,返回禁术提示
- 调用 "fireball jutsu" 工具 → 正常执行并返回结果
值得一提的是,在 @function_tool 中还可以用 name_override 把函数真实名称映射为模型调用时使用的工具名,让工具命名更灵活。
小结
Guardrails 是把 AI Agent 从"玩具 demo"推向"生产可用"的关键一环。OpenAI Agents SDK 把安全检查抽象成 input、output、tool 三层装饰器,开发者只需关注返回 GuardrailFunctionOutput / ToolGuardrailFunctionOutput 并设置 tripwire 条件即可。再配合 run_in_parallel 对性能与成本的调节,就能针对不同场景灵活设计防护策略。对于任何面向真实用户的 Agent 应用,这套机制都值得优先纳入架构设计。
相关推荐

开源神器 Tracer:让多个 AI 智能体协作编程
开源多智能体编排工具 Tracer AI 实测:支持自带智能体(BYOA)、智能体间通信与跨平台运行。博主用 Fable 5 编排本地 Quen 27B 构建飞行模拟器,对比有无编排者的巨大差异,揭示大模型编排小模型的协作趋势。

AI说90%把握能信吗?概率校准与Agent决策实战
AI模型说「90%把握」就能让Agent自动执行吗?本文跟随B站UP主Jev的实战拆解,讲清概率校准、准确率与分流能力的区别,并给出阈值设定、旁路测试、调参验收的完整Agent决策落地方法。

AI Agent开发零基础教程:三阶段学习路径拆解
一套 B 站零基础 AI Agent 开发教程的内容拆解,涵盖基础、进阶、实战三阶段,解析 RAG、Agent 训练等核心知识点,并给出判断教程质量的实用建议。