OpenAI Codex实测:云端AI编程智能体怎么用,与Cursor有何不同

OpenAI Codex是云端软件工程智能体,以异步委托模式将整个开发任务交给AI独立完成,代表AI编程从辅助补全走向任务委托的新阶段。
OpenAI推出的云端智能体Codex与Cursor、Windsurf等实时协作编辑器走了一条不同的路:用户用自然语言描述任务,Codex在隔离的沙箱环境中自主读写文件、运行测试、按需修改,完成后交付代码改动、终端日志和测试结果,并可直接发起GitHub PR。每项任务耗时1至30分钟,用户无需守候,还可同时派发多个并行任务。驱动它的模型经过真实编程任务的强化学习训练,在SWE Bench Verified上(低尝试次数条件下)表现领先。teams.md文件可将项目规范固化进仓库,类似Cursor Rules。文章强调,AI提速并不意味着可以省掉人工审查——最终能否安全合并,仍需人来判断。
OpenAI推出的云端软件工程智能体Codex,提供了一种与Cursor、Windsurf截然不同的AI编程思路。它不是让你和AI实时在编辑器里一起改代码,而是把整个开发任务交给智能体,等它跑完一轮再回来检查结果。这种"委托式"工作流,可能预示着AI编程下一阶段的形态。
Codex到底是什么:产品、智能体与模型的区别
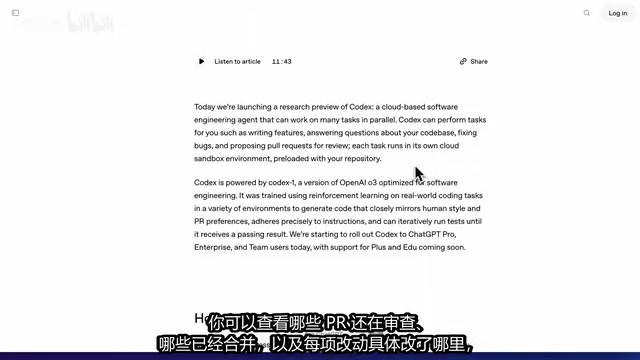
理解Codex前,先厘清几个容易混淆的名字。Codex是产品和智能体本身,而驱动它的模型(视频录制时)叫Codex-E——这是OpenAI基于o3针对软件工程优化的版本。换句话说,Codex这个名字并非到那天才首次出现,但云端智能体功能是新加入的能力。
这个模型经过真实编程任务的强化学习训练,目标很明确:让它像工程师一样工作,遵守仓库规范、团队代码风格以及PR(代码合并请求)要求,而不只是机械地补全代码片段。
按官方介绍,Codex能开发新功能、回答代码库问题、修复错误,还能直接发起PR。它可以连接GitHub代码库,选好工作分支,你用自然语言描述任务,它就开始动手。任务完成后,你能查看哪些PR还在审查、哪些已合并,以及每项改动的具体位置,方便判断结果是否符合预期。
SWE-bench Verified 是目前软件工程智能体领域最常被引用的基准测试,由 Princeton NLP 团队构建。它从真实的 GitHub issue 中挑选经人工验证的任务,要求模型在给定代码库快照中自动定位并修复问题,最终以能否通过已有测试套件来判断成功率。"Verified"后缀表示题目经过人工筛查,剔除了描述模糊或测试不完善的样本,使结果更具可比性。该榜单成绩直接影响业界对"模型能否胜任真实工程任务"的判断,也是 OpenAI、Anthropic 等厂商发布新模型时必然引用的指标之一。
实际怎么用:从输入需求到独立环境运行
使用流程相当直接:输入开发需求,点击"Code",它就开始写代码。如果你只想了解现有项目,也可以直接提问,不必每次都改文件。

关键在于每项任务都运行在独立环境中。这个环境预先载入了你的代码库,也能按配置使用环境变量。Codex可以读写文件、运行终端命令,既能执行仓库里已有的测试,也能自己编写并运行新测试。
单项任务可能要花1到30分钟。在这段时间里,它会查找文件、运行测试、根据报错继续修改——而你不必一直守在旁边等待。这正是它和实时协作编辑器最大的差异:Cursor等工具强调人机实时共改,Codex则是异步委托。
更有意思的是,你可以同时安排多项任务,让它们在彼此隔离的环境中并行工作。比如一项修错误、一项补测试,几项任务不会共用同一套临时改动,互不干扰。

这里的"独立环境"在技术实现上通常对应容器化沙箱(如基于 Docker 的隔离实例)。每项任务启动时,系统会克隆对应代码库、注入环境变量,并在任务结束后销毁实例。这种设计有两个好处:一是安全隔离,任务中途产生的临时文件、依赖变更不会污染主仓库或其他并行任务;二是可复现,每次运行都从干净状态出发,方便对比不同参数下的执行结果。并行多任务之所以互不干扰,根本原因也在于此——每个任务拥有完全独立的文件系统快照,而非共享同一工作目录。
结果交付与人工审查:别只看一句"已完成"
任务完成后,Codex会交出三样东西:代码改动、终端日志和测试结果。这里有个重要提醒——不要看到"已完成"就放心。你应该顺着日志,看它运行过哪些命令,必要时自己再跑一遍测试或尝试构建。
你还能从Codex直接发起PR,让结果进入团队原有的审查流程。随着AI写代码越来越快,检查改动、理解风险这件事反而变得更重要。速度的提升并不意味着可以省掉人工把关,最终能否安全合并,仍然要由人来决定。
agents.md:把项目规范固化进仓库
另一个实用功能是agents.md文件。把它放进代码仓库,就能告诉Codex如何理解项目、运行哪些测试、以及做任务时要遵守什么规范。

如果你用过Cursor Rules,会很容易理解这个思路:不用每次重新交代项目背景,而是把长期有效的规则沉淀在仓库里。这对团队协作尤其有价值,能保证AI产出符合既定的工程约定。
agents.md 的设计思路源自"将 AI 上下文版本化管理"的实践趋势。类似文件在不同工具中有不同名称:Cursor 称之为 .cursorrules,Anthropic Claude 的项目功能支持自定义系统提示,GitHub Copilot 则提供 .github/copilot-instructions.md。这类文件的核心价值在于把原本散落在口头约定、Wiki 文档或 onboarding 材料中的工程规范,转化为 AI 每次执行任务时都会读取的结构化指令。对团队而言,它本质上是一份机器可读的"贡献者指南",能减少 AI 产出因缺乏项目上下文而出现风格不一致或遗漏约定的情况。
性能表现与适用场景
评测方面,视频录制时Codex已在SWE Bench Verified上表现领先,尤其是在可尝试次数不多的情况下优势明显。随着尝试次数增加,它和o3-high的成绩逐渐接近。
不过评测只能反映特定任务集上的能力。实际使用中,更值得关心的是:它能不能找全相关文件,并把改动和测试一起完整交付。
视频还演示了从ChatGPT应用直接调用这项功能的场景,比如值班时快速检查代码库,或者把报错堆栈丢给Codex让它排查原因。按当时的开放计划,云端Codex先面向Pro、企业和团队用户,再逐步扩展到Plus和教育用户。
小结:委托式AI编程的一次探索
Codex代表的是一种新的工作方式——把开发任务整体交给智能体,而不只是用一个会补全代码的编辑框。它与Cursor、Windsurf的实时协作模式互补而非替代:前者适合可以异步等待的、相对独立的任务,后者适合需要紧密人机互动的场景。
这类工具究竟会怎样融入日常开发流程,还需要在真实项目中持续观察。但可以确定的是,AI编程正从"辅助补全"走向"任务委托",而人的角色也在从编写者向审查者转移。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。