OpenAI 发布 GPT-6 Sol 与 Luna:价格再砍半的工作马模型

OpenAI 同日发布 GPT-6 Sol 与 Luna,API 降价50%,Luna 以极低成本逼近旗舰性能,标志行业进入性价比竞争新阶段。
OpenAI 在竞争激烈的"模型周"中同日推出 GPT-6 Sol 与 GPT-6 Luna,两款模型 API 价格永久下降 50%。其中 Luna 定价低至每百万输入 token 仅 10 美分,被视为极致性价比的"工作马"模型,可胜任 90%~95% 的日常任务。基准测试显示,Luna Max 在 Frontier Code 智能体编程任务上以每次仅 22 美分的成本拿下 66.6% 的得分,与旗舰 Astra 的差距不足 7 个百分点,但在需要复杂 GUI 操控的 OS World 测试中仍明显落后。Sol 则以比 Astra 低得多的价格提供逼近旗舰的性能,适合对成本敏感的大规模部署场景。Anthropic 与 OpenAI 同日降价,折射出头部实验室"控速前沿"策略下效率与价格优先的共同取向:先以旗舰模型立锚,再逐步释放高效蒸馏版本以覆盖更广泛的用户群体。
OpenAI 在同一天连发两款新模型——GPT-6 Sol 与 GPT-6 Luna,而这一天恰逢 Anthropic 推出 Opus 5.5、Grok 也在前一天发布 4.7 版本。三大厂商密集出招,让这一周成为名副其实的"模型周"。本文基于 YouTube 频道 Forward Future 的实测分析,梳理这两款新模型的定价、性能表现,以及它们背后透露出的行业走向。
价格再降 50%:Luna 便宜到不可思议
从 GPT-5.6 Sol 到 GPT-6 Sol,价格直接下降 50%,来到每百万输入 token 2 美元、每百万输出 token 10 美元的水平——而这已经是仅次于绝对旗舰 Astra 的第二梯队模型。
Luna 的降价更为激进。此前 GPT-5.6 Luna 就曾有过 80% 的降价,让它一度成为"地球上最值得使用的模型之一":极快、极便宜、智能仍然很高。如今 GPT-6 Luna 在此基础上再砍 50%,定价来到每百万输入 token 10 美分、每百万输出 token 50 美分。
UP 主直言,这样的定价"令人难以置信",并认为 Luna 能够胜任你交给它的 90%~95% 的任务,是名副其实的"工作马"(workhorse)模型。OpenAI 官方也表示,此次 API 降价是永久性的,将让这两款模型在大量新场景中变得可行,同时让订阅用户的额度更耐用。
基准测试:Sol 紧追 Astra,Luna 性价比封神
在 Automation Bench 测试中(Y 轴为得分、越高越好,X 轴为成本、越低越好),max effort 下的 5.6 得分为 28.8,而 GPT-6 Sol 的 extra high 档拿下了 33% 的第一名。不过 UP 主强调,Astra 仍是 OpenAI 最强的模型,Sol 只是它一个更便宜的替代版本——如果你需要绝对最优的答案,仍要为 Astra 买单。
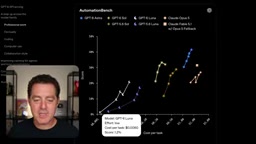
Luna 则是三者中得分最低的,但代价只是零头。即便在低 effort 设置下得分不高,成本也极低;而开到 max 时能拿到 20% 以上的分数,每个任务成本却不到 5 美分。
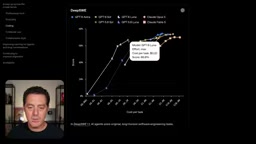
值得关注的是 Frontier Code 测试。Luna 表现强劲:Luna Max 每任务成本 11 美分,可对标 Sol Medium 的 80 美分;Sol 又能对标 Astra Low 的 1.7 美元。而在 UP 主认为最能反映智能体编程能力的基准里,GPT-6 Luna Max 拿下 66.6%,每任务成本仅 22 美分,被形容为"phenomenal"。
不过在 OS World(计算机操作)测试中,Luna 明显落后:得分 53%,而 Astra 达到 73%,说明在需要复杂环境交互的任务上,廉价模型仍有短板。
Automation Bench 是一个专门评估 AI 模型在自动化任务中端到端完成能力的基准测试,涵盖网页操作、表单填写、信息检索等典型工作流场景。测试中的"effort 档位"(low / medium / high / extra high)对应模型在推理时投入的计算量——档位越高,模型思考步骤越多、输出质量越好,但每次调用的 token 消耗和成本也随之上升。Frontier Code 则聚焦于真实软件工程任务,包括代码生成、调试和多文件修改,通常被视为衡量模型"智能体编程能力"的黄金标准。OS World 测试更进一步,要求模型在模拟桌面环境中直接操控 GUI(图形用户界面),完成安装软件、管理文件等复杂人机交互任务,难度显著高于纯代码生成,因此即便是廉价模型在前两项表现优异,在 OS World 上的落差也揭示了其在多模态感知与长程规划上的不足。
同日三雄对决:性能差一点点,价格差好几倍
UP 主让 Astra 绘制了一张图表,把 GPT-6 Sol、Luna 与 Opus 5.5 放在同一天、同一坐标系里对比。在 Frontier Code 上,三款模型的性能差距只有约 6~7 个百分点,但价格却相差数倍——从 10 美分、2 美元到 4 美元不等。
这印证了一个越来越清晰的行业叙事:想要"绝对最好的那个答案",代价是昂贵的;而多数实际任务并不需要旗舰级性能,用便宜几倍的工作马模型即可高效完成。
为何两家同日降价?"控速前沿"的必然结果
耐人寻味的是,Anthropic 与 OpenAI 在同一天都对新模型下调了价格。UP 主给出的解读是:当这些公司谈论"pacing the Frontier"(有节奏地推进前沿)时,你得到的正是效率、速度和价格,而非绝对的原始算力与智能。
他进一步指出,这并不意味着厂商内部没有在研发更强模型,而是当前对外释放的产品形态使然。典型的发布节奏是:先推出昂贵的基础旗舰模型(如 Astra、Fable),随后几周到几个月内,再逐步放出更高效、更便宜的工作马版本——它们可能在架构上与旗舰相似,甚至是旗舰的蒸馏版本。因此 Sol 与 Luna 的出现完全在预期之内。
"Pacing the Frontier"(控速前沿) 是 AI 安全与产品策略领域的一个概念,指头部实验室有意识地以可控节奏向外界释放能力,而非一次性公开其最强成果。这一策略的底层逻辑在于:实验室内部研发进度往往远超对外发布时间线,但出于安全评估、市场节奏管理和竞争布局等考量,会选择分阶段推出产品。旗舰模型(如 Astra、Fable)充当能力锚点与品牌标杆,随后推出的高效蒸馏版本(如 Sol、Luna)则面向更广泛的实际部署场景。模型蒸馏(Model Distillation)是实现这一路径的关键技术:用大型教师模型的输出来训练更小的学生模型,使其在大幅降低参数量和推理成本的同时,尽可能保留旗舰模型的推理能力。Sol 与 Luna 极有可能是 Astra 蒸馏链条上的产物,这也解释了为何它们能以旗舰十分之一不到的成本,在多数基准上拿到接近的分数。
可用性与总结
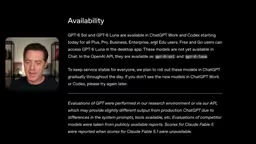
GPT-6 Sol 与 GPT-6 Luna 即日起在 ChatGPT Work 和 Codex 中向所有 Plus、Pro、Business、Enterprise 及 EDU 用户开放;免费与 Go 用户可在桌面应用中使用 GPT-6 Luna。OpenAI 称,这两款模型不仅在各项能力上有显著提升,在写作等方面也是"一试便知"的品质飞跃。
综合来看,GPT-6 Sol 和 Luna 代表了当下大模型竞争的一个关键方向:以更低价格提供逼近旗舰的实用智能。对绝大多数开发者和企业用户而言,这类工作马模型可能比昂贵旗舰更具吸引力。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。