OpenAI神秘模型攻破数学前沿:722篇AI生成论文背后的信号

OpenAI神秘模型并行探索数学前沿,Mistral、Google、Anthropic密集更新,AI正从问答工具演变为科研与软件生产的并行化引擎。
本文梳理了OpenAI、Mistral、Google与Anthropic近期密集发布的重要更新。最核心的信号来自OpenAI一款未发布的前沿模型:它针对约4000个真实数学研究问题生成了722篇手稿和372个结果族,部分采用Lean形式化证明验证,涉及黎曼ζ函数、霍奇猜想等顶级难题的特定子问题。其意义不在于单条定理,而在于AI可同时并行探索数千条研究路径,并与"AI改进AI"的反馈循环叠加,预示着科研范式的根本性变革。Mistral Large 4作为万亿参数MoE开源模型,在网络安全领域表现突出,12分钟完成通常需一整天的恶意软件逆向分析,但编程场景表现参差。Google发布了速度更快、价格更低的图像生成模型与端侧多模态嵌入模型,Anthropic则深化了Claude与Google Workspace的集成及Code能力。个人开发者借助Claude重建七款Adobe应用的案例,则象征着AI编程门槛正以惊人速度坍塌。
AI行业从不缺少重磅消息,而这一次OpenAI、Mistral、Google与Anthropic几乎同时放出大招。其中最令人震动的,是OpenAI一款尚未发布的前沿模型——社区暂称其为"GPT-Bell",可能是GPT-6.5或GPT-7——在数学研究领域展现出的惊人能力。本文梳理YouTube频道WorldofAI整理的这波密集更新,并分析其中真正值得关注的技术信号。
OpenAI神秘模型:722篇数学手稿意味着什么
OpenAI近期公开发布了722篇AI生成的数学手稿,覆盖372个结果族系(result families),这些成果来自对该内部模型约4000个数学研究问题的测试。关键在于,这些并非常规基准测试题,而是触及黎曼ζ函数(Riemann-Zeta)、霍奇猜想(Hodge Conjecture)、自旋玻璃、量子磁性、自由群等真正的前沿研究方向。
更你可能没注意到方法论层面的严谨性:部分结果采用了Lean形式化证明,意味着这些论断可以由形式化证明系统验证,而不只是依赖人工审读AI的输出。据报道,平均每个成功结果仅需约3小时的ChatGPT Pro等效"思考算力"。OpenAI甚至就如何公布这些结果咨询了普林斯顿高等研究院及独立数学与AI顾问团队。
这里需要保持清醒:发布数百篇手稿并不等于每一篇都是经过验证的数学突破。所谓黎曼ζ函数"在特定区域外无零点"的进展、霍奇猜想特例的结果,都还需要独立的严肃审查,远不等同于解决完整猜想。
真正的信号不在于某一条定理,而在于规模——一个未发布的模型并行探索了数千个研究方向。这暗示科学研究本身正在变得"可并行化":不再是一位数学家花数月探索单一方向,而是AI系统同时推进成千上万条路径,由人类验证并在最有希望的发现上继续构建。考虑到数学支撑物理、物理支撑工程、工程支撑芯片与材料,再叠加"AI帮助研究者发现更好的算法与硬件、从而造出更好的AI"这一反馈回路,这件事的影响远超"ChatGPT变聪明了"。
Lean是一种交互式定理证明器(Interactive Theorem Prover),由微软研究院开发,用于将数学证明转化为计算机可验证的形式化语言。与普通数学论文依赖人类专家审读不同,Lean能在逻辑层面逐步检验每一个推理步骤是否严格成立,从根本上排除人类审阅可能遗漏的细微错误。黎曼猜想(Riemann Hypothesis)是克雷数学研究所七大"千禧年难题"之一,其核心是关于黎曼ζ函数非平凡零点分布的断言,至今悬而未决逾160年。霍奇猜想同属七大难题,涉及代数几何中复代数簇的拓扑特征与代数闭链的关系。OpenAI所指的并非解决了完整猜想,而是在这些方向的特定子问题或受限情形下取得了新结果——这本身已是数学研究中有价值的进展,但与"证明猜想"之间仍有本质距离。
28天连续发布:OpenAI第二天的四项更新
作为"28天连续发布"承诺的第二天,OpenAI一口气推出四项功能。
**Auto-review(自动审查)**现对所有登录ChatGPT账号的用户免费开放。它用第二个agent自动审查主agent的操作,专门捕捉高风险动作或偏离原始意图的行为,尤其适合长时间运行的agent任务。更重要的是,Auto-review不再消耗用户套餐额度——此前它可能占用2%到10%的用量。
API层级简化:原本5个付费层级精简为build、launch、grow三档,达到最高grow层所需的累计API支付从1000美元降至500美元。Meetings插件可在会议中记录笔记、生成个性化摘要与后续步骤,并直接存入ChatGPT的space,还能把上下文传入Codex继续执行,目前在macOS桌面端对Pro与Business用户beta开放。Decision API则是一个实时分类器,让应用快速决定下一步该用哪个模型、工具或动作,速度据称可达GPT-6 Luna的10倍,OpenAI也将在内部用它改进ChatGPT。
有意思的是,社区还就"第二天是否够格"发起投票,最终OpenAI以"规则就是规则"为由重置了所有人的用量额度,且没有收回当天发布的功能。
Mistral Large 4:欧洲的万亿参数开源王牌
Mistral发布了代号"Le Chunk"的Mistral Large 4——一个万亿参数、原生多模态的MoE模型,激活参数约490亿。Mistral称其为美国或欧洲地区聚合基准上最强的开源权重模型,并主打网络安全、金融、制造与视觉定位(visual grounding)等场景。该模型端到端在欧洲开发,可通过Mistral自有的欧洲云部署,对关注数据主权的欧洲企业颇具吸引力。API现已可用,开源权重将在月底放出。
网络安全是它最亮眼的强项。在capture-the-flag(夺旗)速通测试中,面对19个安全挑战,Mistral Large 4完成了其中18个(原视频数据表述略有混乱)。它之所以在网络安全基准上超越Opus 5.5和GPT-6 Astra,很大程度上是因为它拒绝的安全任务少得多——而Opus与Astra约有40%的任务被自身安全过滤器拦截。
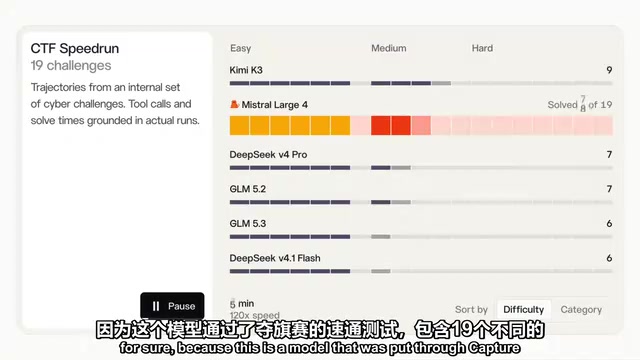
在恶意软件逆向工程中,模型拿到一个从未见过的未知二进制文件,成功识别为Cobalt Strike,提取出恶意软件配置与入侵指标(IoC),并生成完整调查报告,还附带用于检测同类事件的Yara规则。据Mistral称,这类通常需要安全研究员一整天的工作,模型仅用12分钟完成。
但在创意编程、Web开发等常规软件开发场景,表现则明显参差。在同一组3D生成提示的八模型横评中,Mistral在埃菲尔铁塔任务上是开源模型里最佳(整体冠军为GPT-6 Astra),却在水族馆任务上接近垫底。价格是它的另一大卖点:三个场景合计仅0.87美元,而Opus需要13.83美元。需要注意Mistral Large 4默认关闭推理,开启后虽改善质量却极慢,三个场景耗时约66分钟。总体而言,它不是适合日常使用的编程主力,但在网络安全、恶意软件分析等知识工作领域值得一试。
MoE(Mixture of Experts,专家混合)是一种稀疏神经网络架构:模型虽拥有万亿级总参数,但每次前向推理时只激活其中一小部分"专家"子网络(此处约490亿),其余参数处于休眠状态。这使得MoE模型在维持强大能力的同时,推理计算成本远低于同等稠密参数的模型,也更易于在有限硬件上部署。Yara规则是恶意软件检测领域的行业标准工具,是一种基于文本模式匹配的规则语言,安全研究员用它描述特定恶意软件家族的特征字符串、字节序列或行为模式,以便在大量文件中快速扫描识别威胁。Cobalt Strike则是一款原本为红队(offensive security)设计的渗透测试框架,因其功能强大而被真实攻击者广泛滥用,成为高级持续性威胁(APT)攻击中最常见的工具之一。
Google与Anthropic:图像、嵌入与Agent的持续进化
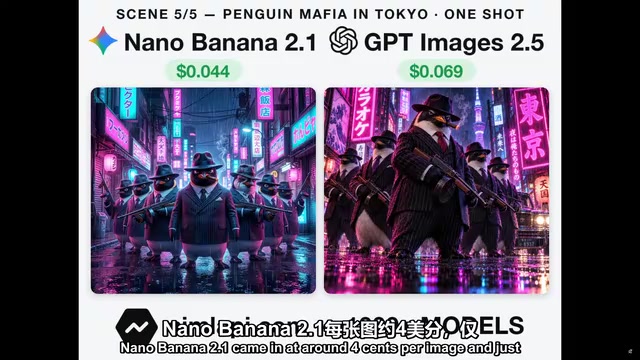
Google发布了Nanobanana 2.1,在视觉设计、基于蒙版的编辑(mask-based editing)、主体一致性与图像自然度上全面提升。蒙版编辑尤其实用——可只改动图像特定区域而不破坏整体。价格与速度优势明显:Nanobanana 2.1每张约4美分、渲染耗时11秒,而GPT image 2.5每张约7美分、耗时约50秒,速度接近5倍差距,代价是图像质量稍逊。
Google还推出了Embedding Gemma 2,其首个面向端侧的原生多模态开源嵌入模型,仅7.4亿参数却能在同一共享空间理解文本、代码、图像、音频与视频,甚至超越体量两倍于己的专用模型,采用Apache 2.0许可,权重已开放。在NVIDIA DGX Spark上的本地测试中,索引300张动物照片后检索,200次中命中165次,精确率达82.5%,可用于多模态搜索或与Gemma搭配实现完全私密的端侧RAG。
Anthropic方面,Claude现已能直接在Google Docs、Sheets与Slides内工作,侧边栏可理解文件内容并原地提出可审批的编辑建议,文件也能反向在Claude中打开。Claude Code迎来重要更新:可为单个子agent分别设定推理"努力程度"——简单任务用低档换速度,困难部分保留高档,从而显著节省token(需升级至2.1.292或更新版本)。此外Anthropic还开放了高度受限的Mythos 5.1申请,面向经验证的安全专业人员,分defense、red team与specialized三个访问层级,普通用户仍正常使用公开模型。
嵌入模型(Embedding Model)的核心作用是将不同类型的数据——文本、图像、音频等——映射到同一个高维向量空间,使语义相近的内容在空间中距离相近。"共享嵌入空间"意味着一张猫的图片与文字描述"一只橘色的猫"会被编码为彼此接近的向量,从而实现跨模态检索。RAG(Retrieval-Augmented Generation,检索增强生成)是一种将向量检索与语言模型结合的技术范式:先用嵌入模型将本地文档库索引为向量,用户提问时实时检索相关片段,再将其注入大模型的上下文窗口以生成回答。端侧RAG(on-device RAG)指整个流程完全在本地设备运行,无需将数据发送至云端,从而实现数据完全私密——这对医疗、法律等对隐私高度敏感的场景尤具价值。Embedding Gemma 2仅7.4亿参数即可胜任这一任务,大幅降低了私有化部署的硬件门槛。
AI编程的门槛正在崩塌
最后一个案例极具象征意义:一位开发者称他用Claude Opus 5.5重建了包括Photoshop在内的七款Adobe核心应用,做成基于Rust的完全免费开源替代品,源码公开、无需订阅。其中名为Photocraft的项目据称已达到Photoshop约90%的能力克隆,尽管开发者承认它仍处早期、尚不能完全替代专业日常使用。
关键不在于它是否已经完整,而在于趋势:过去需要庞大团队、数百万美元和数年开发的软件,如今个人开发者借助前沿AI模型就能逼近。随着编程模型持续进步,构建严肃软件的门槛正在以惊人速度坍塌。
从OpenAI神秘模型的数学突破,到Mistral的网络安全专精,再到个人重建Adobe全家桶,这一波更新共同指向同一个方向:AI不再只是回答问题的工具,而正在成为科研与软件生产的并行化引擎。
相关推荐

2026诺贝尔化学奖解读:手性放大背后的化学革命
2026年诺贝尔化学奖授予亨利·卡根与左右田健次,表彰其在不对称有机合成中发现非线性效应与自催化。本文解读手性分子、不对称催化及63万倍手性放大实验的科学意义。

诺贝尔化学奖得主硖合宪三:手性之谜与生命起源
诺贝尔化学奖得主硖合宪三接受电话采访,谈及其发现的硖合反应如何满足Frank判据、揭示分子手性起源,为地球生命起源这一世纪难题提供关键实验证据。

2026诺贝尔化学奖:破解分子手性之谜
2026年诺贝尔化学奖授予亨利·卡根与硕井健三,表彰其在不对称有机合成中发现非线性效应与自催化反应。本文解读手性、放大效应及其对制药与生命起源研究的意义。