OpenAI首款推理芯片Jalapeño实测:能效碾压英伟达GB300?
OpenAI首款自研推理芯片Jalapeño实测每瓦性能达英伟达GPU的1.5至1.9倍,标志其从算力买家转型为技术栈定义者。
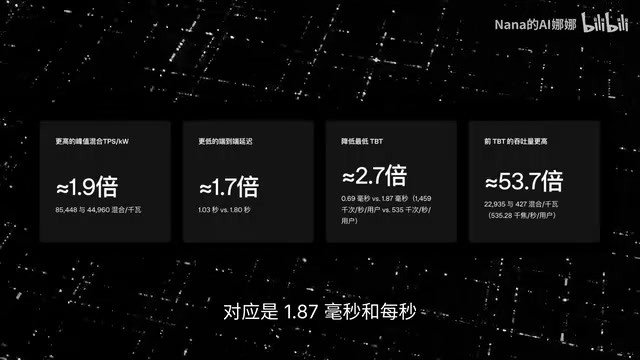
OpenAI发布首款自研推理芯片Jalapeño的初步测试结果,该芯片专为模型部署后的推理环节设计,额定功耗700W,远低于英伟达GB300的1400W。在Semi-Analysis的InferenceX基准上,Jalapeño峰值每瓦吞吐达对比系统的1.5到1.9倍,低延迟交互场景下性能优势可达2到4倍。广为流传的"104.3倍"数字是特定速度对齐条件下的每千瓦吞吐比,并非通用结论。性能优势来源于芯片、内存、网络、软件和机架的一体化协同设计,而非单一部件的规格堆叠。AI深度参与了芯片研发全程,从设计到流片仅9个月,部分模块AI生成的实现比人类专家版本快1.5至1.8倍,形成"模型优化芯片、芯片加速模型"的闭合反馈回路。目前仍处于工程测试阶段,计划2026年底前正式部署,OpenAI也未将自研路线定位为对英伟达的全面替代。
从买家到定义者:算力竞争的新剧本
过去几年,AI公司的核心任务几乎可以概括为一句话:想办法买到更多英伟达芯片。而现在,游戏规则正在改变。最有实力的模型公司不再满足于使用算力,而是开始亲自定义算力。
OpenAI刚刚公布了首款自研推理芯片Jalapeño(西班牙语意为墨西哥辣椒)的首批测试结果。这颗芯片的定位很明确:它不负责训练下一代GPT模型,而是专攻推理——也就是当用户输入问题、智能体调用工具、模型逐个生成token时,真正把回答交付出来的那一层。
这个区分至关重要。训练决定模型能学到什么,推理决定这些能力能否以足够快、足够便宜、足够稳定的方式送到每一个用户手里。模型越强,推理需求越大;智能体执行的步骤越多,等待时间和电力成本也会一层层累积。Jalapeño要解决的,正是未来每天数以亿计的真实请求:究竟要用多少电、占多少机器、等多长时间。
实测数据:每瓦性能领先1.5到1.9倍
OpenAI采用了Semi-Analysis的公开基准InferenceX,在三个开放模型上进行测试:GPT-OSS 120B、DeepSeek广告 R1 670B和Kimi K2 1T。这三个模型来自不同团队、规模各异,一定程度上说明架构优势并非只贴合OpenAI自家模型。
核心数据可以概括为:
- 峰值吞吐状态下,Jalapeño每瓦完成的AI工作量达到对比系统的1.5到1.9倍
- 端到端延迟约为对比系统的28%到59%
- 在强调快速交互的负载中,性能达到对比系统的2.1到4.1倍
- 额定功耗700W,实测持续功耗未超过550W(对照:GB200额定1200W,GB300额定1400W)
值得玩味的是OpenAI的比较口径。它没有只拿单颗芯片的峰值算力比拼,而是把问题换成:在用户可以接受的响应速度下,每1000W电力到底能处理多少有效工作。这个口径更接近推理业务的真实矛盾——系统可以把大量请求堆在一起做出很高的总吞吐,但单个用户可能要等很久;也可以集中资源给少数请求换来极低延迟,却牺牲整体利用率。
OpenAI把Jalapeño当前的状态称为"帕累托前沿",意思是想在不牺牲一个指标的前提下继续提升另一个,已经很难找到更好的对比点。
那个104.3倍是怎么回事
传播最广的"104.3倍"数字出现在DeepSeek R1 670B上,但它并不意味着Jalapeño在所有情况下都比GB300快100倍。真实含义是:当把交互速度对齐到GB300此前能达到的每秒约169个token时,Jalapeño每千瓦提供的吞吐是12258,而GB300是118,相差约104.3倍。若换成各自的峰值每瓦吞吐,领先幅度实际是1.7倍。
以GPT-OSS 120B为例,Jalapeño最低token间隔0.69毫秒(单用户每秒1459个token),GB200为1.69毫秒;端到端延迟1.03秒对1.80秒。在Kimi K2 1T上,Jalapeño峰值每瓦吞吐约为GB300的1.5倍,延迟1.56秒对5.31秒。
InferenceX是Semi-Analysis(一家专注芯片与数据中心研究的独立分析机构)推出的推理基准测试套件,设计目标是模拟真实业务场景而非纯粹的峰值算力竞争。它的核心指标是"延迟-吞吐权衡曲线"(latency-throughput tradeoff curve):在横轴上设定用户可接受的最大响应延迟,纵轴则衡量系统在该约束下能处理多少请求、消耗多少能量。这种测试方式迫使被测系统在"服务质量"与"资源利用率"之间做真实取舍,而不是靠堆积请求来刷高峰值吞吐。相比之下,传统的FLOPS或TOPS指标只反映芯片的理论计算上限,无法捕捉内存带宽瓶颈、调度开销和网络传输延迟等在实际推理中往往才是决定性的因素。理解这套测试框架,是读懂Jalapeño各项数据真实含义的前提。
优势不只在芯片,而在整套系统协同
为什么Jalapeño能在高交互、低延迟区间拉开差距?答案不只在芯片本身。大模型推理大致分两个阶段:Prefill阶段系统读完提示词,更依赖计算能力;Decode阶段模型逐个产生token,更容易受内存带宽限制。同时,模型状态还要在核心、芯片和机架之间移动——计算单元再快,数据还在路上,也只能等待。
Jalapeño从设计之初就把芯片、内存、网络、软件和机架放在一起统筹。包括KVCache在内的模型状态可以被明确放置并尽量保留,系统再根据Prefill和Decode的不同需求调动相应资源。大规模连接域让更多工作停留在同一系统内部,减少跨设备搬运造成的空转。
娜娜在视频中用了一个贴切的比喻:这就像一座为大模型专门设计的厨房。传统做法是分别买最好的炉灶、冰箱和传送设备再拼起来;OpenAI则是先研究每天要做什么菜,再决定食材放哪、厨师怎么走、哪道工序需要多少火力。单看某个部件未必解释全部优势,但整份订单从进厨房到端上桌,等待和搬运都少了。
KV Cache(键值缓存)是理解大模型推理效率的关键机制。Transformer架构在生成每个新token时,需要"回顾"此前所有token对应的Key和Value向量。如果每步都重新计算,计算量会随上下文长度平方级增长。KV Cache的做法是把这些向量一次性算出后存入高速内存,后续步骤直接读取。这意味着缓存的存取速度和容量直接决定了Decode阶段(逐token生成阶段)的速度瓶颈。对于长对话、多轮智能体任务,KV Cache可能占用数十GB显存;而在多用户并发场景下,如何在不同请求之间高效共享、驱逐和调度缓存,是推理系统架构设计的核心难题之一。Jalapeño将KV Cache的放置和保留作为系统级设计目标,正是针对这一瓶颈的定向优化。
AI设计AI:一个正在闭合的反馈回路
更值得关注的是,AI不只是这颗芯片未来要服务的对象,也直接参与了它的开发。OpenAI表示,从初始设计到流片,团队只用了9个月。不同阶段的模型帮助工程师探索实现方案,缩短设计、测量、验证的循环,并参与优化算术电路。
当团队需要临时支持原本不在生产计划中的三个开放权重模型时,Codex配合GPT-Astra在两个月内让它们达到高性能运行。在部分GPT-OSS的Attention和MoE模块中,AI生成的实现比原有人类专家编写的版本快1.5到1.8倍——需要强调的是,这个结果只适用于被选中的模块,不代表整个模型都提速了同样幅度。
这展示出一个新的开发循环:模型帮助设计芯片,芯片加速模型,新的模型再继续优化芯片上的软件。这也解释了为什么Jalapeño的意义大于一颗芯片——OpenAI正在把模型、产品、服务软件、芯片、内存、网络和数据中心连成一套完整技术栈。真实用户负载告诉团队下一代硬件该优化什么,更合适的硬件降低成本、缩短响应,更好的体验又带来更多使用和反馈,每一层变化都回流到下一轮设计。
MoE(Mixture of Experts,混合专家架构)是当前超大规模模型广泛采用的一种设计范式。与密集模型每次推理都激活全部参数不同,MoE将模型划分为多个"专家"子网络,每个token在前向传播时只由一个门控机制动态路由到少数几个专家处理。这使得模型总参数量可以远超实际激活参数量——DeepSeek R1拥有670B总参数,但每次推理实际激活的参数只是其中一部分。MoE架构的推理挑战在于:路由决策带来不可预测的计算路径,不同专家的负载可能极不均衡,且专家权重需要分散存储在多个设备上,加剧了内存访问和跨设备通信的复杂度。AI参与优化MoE模块的实现,正是在这一充满组合爆炸可能性的搜索空间中寻找人工难以穷举的高效方案。
商业逻辑:争夺每一美元能交付多少智能
从商业上看,OpenAI争的不是一个孤立的跑分冠军,而是每一美元能交付多少有用智能的控制权。同样的任务,如果模型需要更少尝试、更少输出token,软件减少无效上下文,芯片又能用更低能耗完成推理,总成本会在多个层面同时下降。
OpenAI给了另一个例子:在Artificial Analysis的编程智能体指数上,使用最高推理强度的GPT-5.6取得新高,同时比另一个领先模型少用54%的输出token。这个数字与芯片能效无关,却说明成本优化可以发生在不同层面。
这里绕不开杰文斯悖论:效率提高后总用量未必下降。过去昂贵到不值得做的任务,可能因成本降低而变得可行——企业可以让智能体检查更多合同、为更多客户提供定制分析。所以Jalapeño即便显著提高能效,也不会让OpenAI从此不缺算力,更可能的结果是新需求迅速吃掉节省出来的容量。
杰文斯悖论(Jevons Paradox)得名于19世纪英国经济学家威廉·斯坦利·杰文斯。他在1865年观察到,蒸汽机效率提升后,英国煤炭总消耗量不降反升——因为更高效率使煤炭驱动的生产活动在经济上变得更加划算,触发了需求的爆发式增长。在能源经济学和科技领域,这一现象反复出现:半导体能效每隔几年翻倍,但全球芯片总耗电量持续增加;数据压缩技术越来越好,互联网流量却同步暴涨。将这一逻辑套用到AI推理上,每次推理成本下降并不会减少算力总需求,反而会解锁此前因成本过高而被搁置的应用场景,最终推动整体用量向更高水位收敛。这是理解为何AI基础设施投资仍在加速、而非因效率提升而趋于饱和的重要背景。
英伟达护城河消失了吗?还太早
现在断言英伟达护城河已消失,显然为时过早。
第一,目前披露的是工程阶段的首批结果。OpenAI仍在做生产认证、完善软件、准备规模化,计划在2026年底前才开始把Jalapeño部署进自己的计算基础设施。漂亮的曲线和长期生产环境的可靠性、良率、供应能力之间,还隔着一整条路。
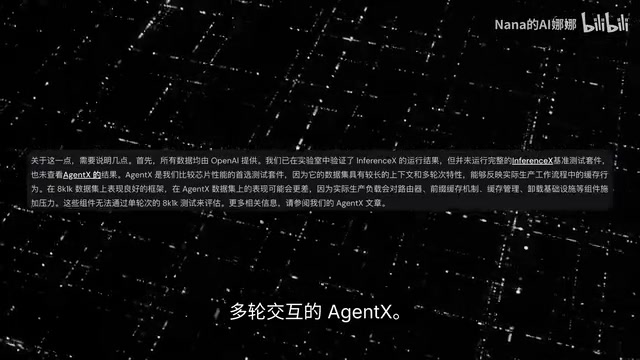
第二,Semi-Analysis在OpenAI实验室核验了InferenceX测试过程,但没有运行完整套件,也没有测试更偏向长上下文多轮交互的AgentX。Jalapeño在真正复杂的智能体任务里能保留多少优势,仍需更多数据。
第三,OpenAI自己也没把自研路线描述成对英伟达的全面替代。公司的算力组合仍包括微软、英伟达、亚马逊、AMD、博通、Cerebras、CoreWeave、甲骨文等众多伙伴。前沿训练、大规模批量推理和持续在线的智能体,不会由同一种芯片包办。
所以Jalapeño带来的竞争不是"OpenAI突然不买英伟达了",而是OpenAI不再只做硬件市场的买家——它开始拥有一条可与合作伙伴并行发展的第一方路径,并能把真实模型负载直接写进芯片架构。哪怕这条路只承担部分推理需求,也可能改变其成本结构和谈判位置。
目前第二代Jalapeño已进入深度开发阶段,第三代也开始成型。真正决定格局的,不是一次跑分,而是"模型—软件—芯片—能源"这条反馈回路能否比传统硬件迭代得更快,并稳定服务真实用户。如果答案是肯定的,未来最稀缺的资源就不只是先进制程、显存和电力,还包括谁最理解自己的模型会如何工作,并能把这种理解贯彻到芯片和数据中心。
相关推荐
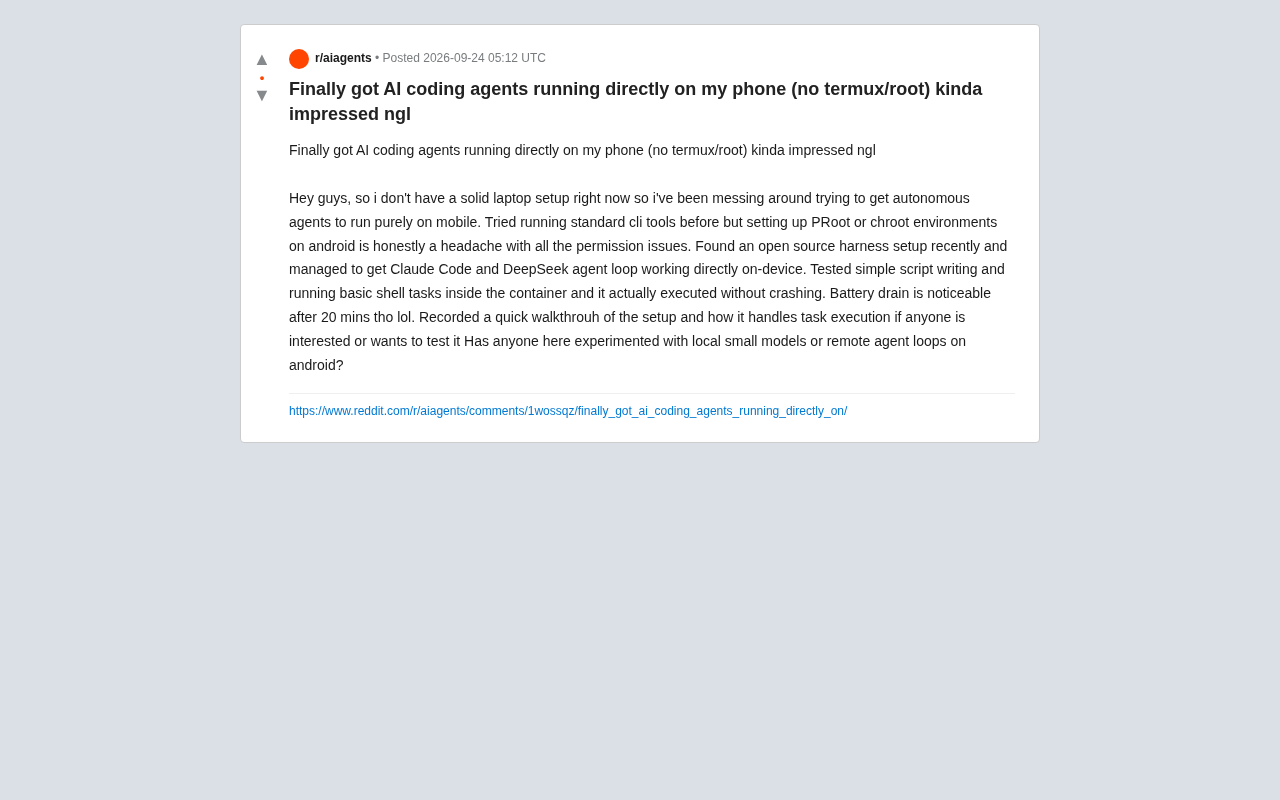
手机直接运行AI编程Agent:无需Termux和Root的实践
一位Reddit用户成功在Android手机上直接运行Claude Code和DeepSeek的AI编程Agent,无需Termux或Root,借助开源harness绕开PRoot环境配置难题,但续航问题依然明显。
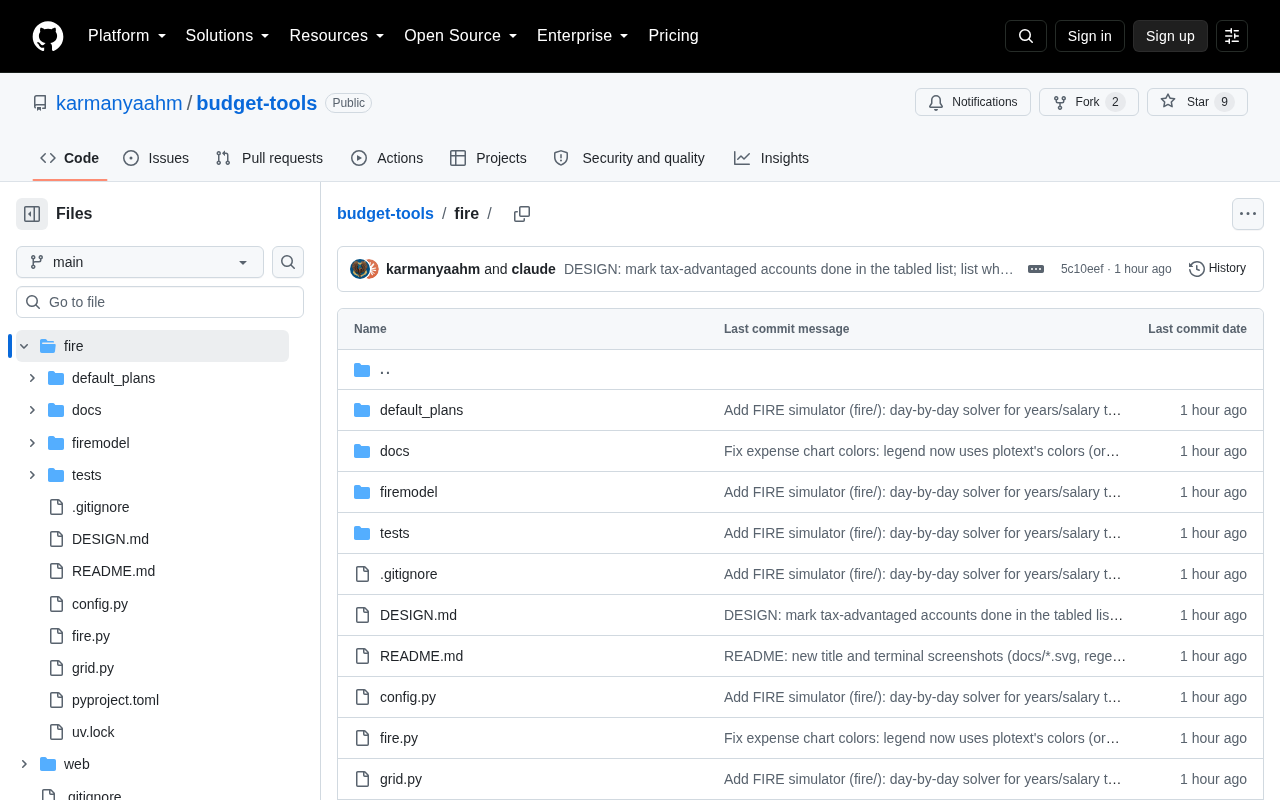
财务自由计算器:算清工作多久才能提前退休
一款登上 Hacker News 热榜的财务自由计算器,帮你算清按当前薪水还需工作多久才能进入 Coast 滑行状态或提前退休。解析 FIRE、4% 法则与工具背后的复利逻辑。
AI产品经理如何撰写Skill需求文档:模板与实战方法
AI产品经理如何撰写Skill需求文档?本文梳理出命名、概述、实现逻辑、输出效果、错误处理五大模板要素,并对比完全AI生成、手写+AI润色、纯手写三种写作方式的优劣,助你高效产出研发可落地的Skill需求文档。