OpenAI推出Decisions API:毫秒级决策的轻量模型

OpenAI Decisions API 通过限制输出空间,让模型在100毫秒内完成分类与视觉决策,填补实时AI交互的延迟空白。
OpenAI 发布的 Decisions API 基于 GPT-6 Luna 模型,核心思路是将大模型的理解能力封装为「超低延迟多选题求解器」——开发者预设好候选选项,模型只从中择一输出,响应时间可低于100毫秒,速度较推理模型提升接近十倍。该 API 同时支持文本和图像输入,适用于工单路由、销售线索分类、实时视觉动作控制等高频低复杂度场景,也可与 GPT Live 语音能力组合,充当多模态智能体架构中的快速决策层。其边界同样清晰:它不替代推理模型,复杂任务仍需 Astra 等更完整的能力。Decisions API 真正的价值在于让一批此前因延迟不可行的实时 AI 交互变得可能。
AI应用常常面临一个两难:既想用上强大的模型理解能力,又受不了推理模型动辄数秒的延迟。OpenAI最新发布的 Decisions API 试图用一种极简的思路解决这个问题——当应用只需要在几个固定选项中做出选择时,为什么要让模型「长篇大论」地推理?
什么是 Decisions API
Decisions API 的设计哲学非常直接:你给模型一段文本或一张图片,定义好问题和可能的答案,模型在几分之一秒内返回其中一个选项。整个交互体验几乎是即时的。
据发布演示介绍,该 API 运行在名为 GPT-6 Luna 的模型上。OpenAI 的核心优化思路是「限制输出空间」——通过让模型只在少数几个预设选项中做选择,而非生成开放式文本,速度可以提升接近十倍,同时保留图像理解、广泛的语言支持以及安全防护等能力。
换句话说,这不是一个更强的模型,而是一个为特定场景「做减法」的模型。它瞄准的是那些高频、低延迟、结果受限的决策任务:路由一个请求、分类一张图片、决定智能体的下一步动作。
「限制输出空间」在工程上的含义值得展开说明。传统的大语言模型推理过程需要逐词生成(autoregressive decoding),每一个 token 的生成都依赖前一个,因此输出越长、延迟越高。而 Decisions API 的做法类似于将任务转化为「受限解码」(constrained decoding)或分类头(classification head):模型只需从有限的候选标签中输出概率最高的一个,完全跳过了逐步生成自由文本的过程。这从根本上打破了延迟与输出质量之间的传统权衡——代价是牺牲了生成灵活性,换取了接近分类模型的响应速度,同时保留了大模型对语义、图像等复杂输入的理解能力。
文本场景:100毫秒内完成分类
演示中最直观的文本应用是处理非结构化文本。一个基础用法是从长段落里自动抽取表单字段,而更有价值的扩展是:把这些输入用于工单路由或销售线索分流,将松散的用户输入快速归类到正确的团队。
演示里展示了多条杂乱的用户输入被迅速分类为销售线索的过程。据现场说明,这些结果并非加速播放——服务端的 Decisions API 响应时间低于 100 毫秒。对于需要实时分流的客服或销售系统来说,这个延迟水平意味着分类环节几乎不会被用户感知到。
这类场景恰恰是推理模型的「杀鸡用牛刀」地带:任务本身只是多选题,却被迫承担了完整推理的时间成本。Decisions API 把这块需求单独拎出来优化,思路上是合理的。
视觉场景:实时帧分析驱动动作
比文本更有想象力的是图像输入。演示用一个小游戏展示了视觉决策:Decisions API 读取道路和障碍物的画面帧,快速判断汽车应该保持车道还是向左、向右。即便把游戏速度调快,它依然能在远低于推理模型所需的时间内把车导向正确车道。
演示者由此延伸出一个关键定位:Decisions API 可以与基础的「计算机操作」(computer use)任务配对,快速把动作反馈回去。但他也明确划清了边界——如果是非常复杂的电脑操作或浏览器操作场景,仍然需要更完整的 Astra 能力。这说明 Decisions API 并非取代重型智能体,而是作为高频低复杂度环节的加速器。
与语音、机器人的多模态组合
演示的后半段把 Decisions API 和其他能力拼在了一起,展示它作为「决策层」的组合价值。
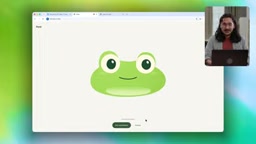
第一个例子是语音互动:把 GPT Live 1 负责语音对话,Decisions API 则实时选择动画角色应该用哪种表情。当用户说话时,应用从预设的表情集合里挑选对应反应,让这些微小的情绪变化成为对话的一部分,使实时互动显得更有反应感。
第二个例子更具冲击力:团队拿到了 Hugging Face 提供的可编程机器人预览单元 Microdoc(演示中昵称「Lavender」),同样用 GPT Live 提供语音智能,用 Decisions API 根据摄像头画面决定机器人该看向哪里。
机器人每隔几帧就把摄像头画面交给 Decisions API 分析,由它决定头部转向哪个方向。有意思的是语义理解的层次感:当指令是「跟着苹果」时它能锁定苹果;当换成更模糊的「跟着水果」时它依然能理解概念;而当两个物体同时出现、指令变成「哪个玩起来更有趣」时,机器人转向了游戏手柄——因为模型判断手柄「自然更好玩」。
这个细节说明 Decisions API 虽然输出受限于预设选项,但在「如何从输入映射到选项」这一步,仍然保留了相当的语义推理能力,而不是简单的关键词匹配。
演示中提到的 Hugging Face Microdoc 是 Hugging Face 推出的一款面向开发者的小型可编程机器人,定位类似于 AI 能力的物理载体参考平台。它内置摄像头和基础运动控制,设计上便于与外部 AI API 对接,让开发者可以快速验证视觉感知与动作控制的组合方案,而无需从头搭建机器人硬件栈。这次演示选择它作为 Decisions API 的展示载体,恰好体现了该 API 的目标场景:感知帧率快、动作选项有限、对延迟极敏感——这正是传统推理模型难以直接胜任、而 Decisions API 可以填补的空白地带。
价值与边界
Decisions API 的本质,是把大模型的理解能力封装进一个「超低延迟的多选题求解器」。它不追求生成能力,而是在速度、成本和基础理解之间找到一个新的平衡点。
对开发者而言,它最适合的场景可以归纳为三类:高频分类(工单、线索、内容标签)、实时视觉动作(游戏、简单机器人控制、轻量 computer use)、以及多模态交互的决策层(表情、朝向、下一步动作选择)。
边界同样清晰:它不是推理模型的替代品,复杂任务仍需 Astra 等更完整的能力。把 Decisions API 理解为智能体架构中负责「快决策」的一环,而非全能大脑,才是更准确的定位。它真正的意义,在于让「模型做选择」这件事变得足够快、足够便宜,从而让一批此前因延迟不可行的实时 AI 交互成为可能。
从智能体系统架构的角度看,Decisions API 对应的是「快慢系统」分层中的「快系统」角色。当前主流的智能体框架(如 LangGraph、AutoGen 等)通常将规划、工具调用与执行混合在同一个推理循环中,导致每一步都要承担完整推理的时间成本。Decisions API 提供了一种分层可能:把高频、低复杂度的判断(下一步往哪走、这条消息属于哪类、画面中的目标是什么)剥离出来交给 Decisions API 处理,只在遇到真正复杂的节点时才调用重型推理模型。这与认知科学中「双过程理论」的直觉一致——系统需要两种速度的决策机制协同工作,而非用同一套流程应对所有场景。
相关推荐

Anthropic递交S-1:半年营收163亿、净亏807亿,谁在控制公司?
Anthropic递交S-1申请纳斯达克上市:2026上半年营收163亿美元、净亏损807亿美元源于估值重估而非现金流出,创始人持Class F股份掌握50.1%投票权,发行价与日期尚未公布。

Anthropic递交S-1:163亿营收与807亿亏损背后的真相
Anthropic S-1文件披露2026上半年163亿美元营收与807亿美元净亏损,其中724亿为会计效应。文件同时揭示2656亿美元算力承诺、云协议细节及创始人50.1%投票权控制结构,IPO定价仍留白。

Anthropic财务数据曝光:营收远超算力成本,Claude推理毛利率达68%
Anthropic泄露财务数据显示,其营收约为总算力成本两倍,Claude推理毛利率达68%,而前沿训练单季烧掉28亿美元。本文拆解推理与训练两笔账,分析AI公司估值逻辑的变化与数据的审慎解读。