OpenAI新模型GPT-6.2 Betelgeuse传闻:一场AI新闻的信任危机
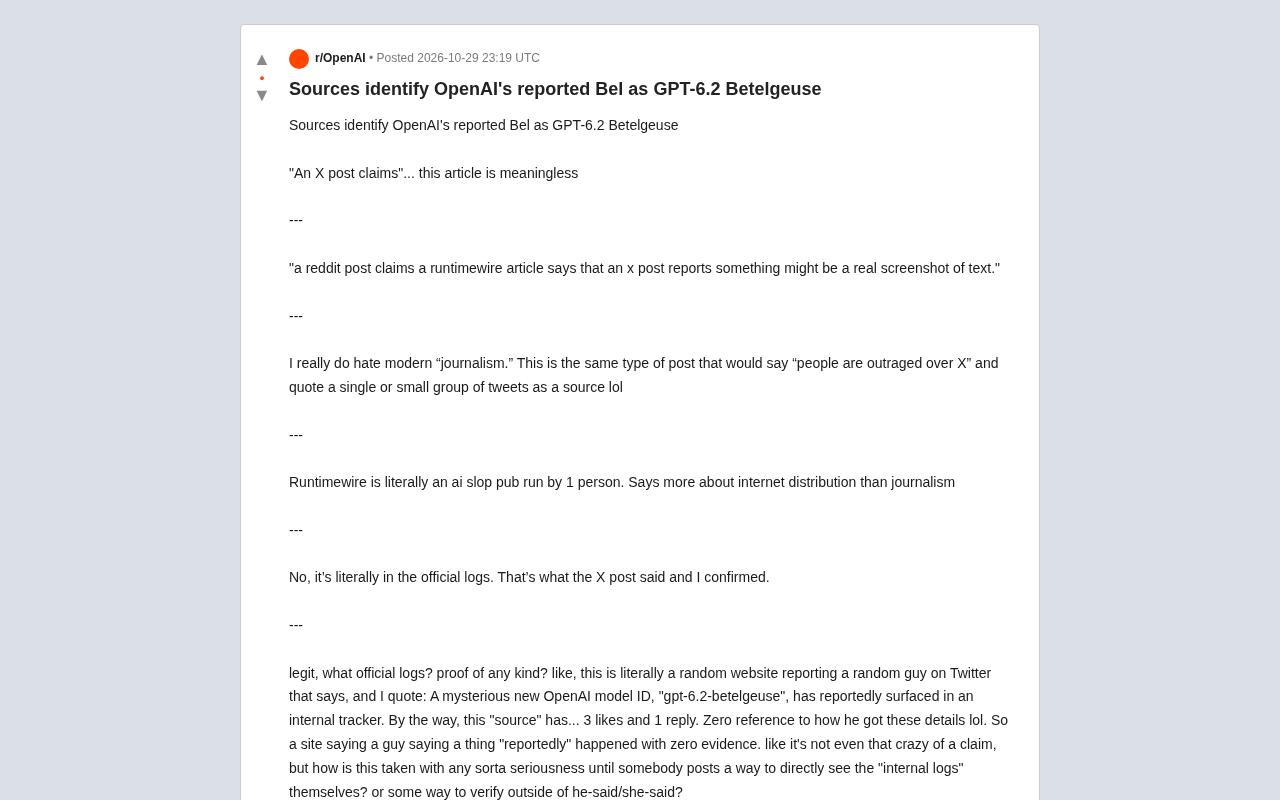
一条仅3个赞的推文声称OpenAI在测GPT-6.2 Betelgeuse,经AI垃圾网站放大后引发热议,暴露AI新闻信任赤字。
文章追踪了Reddit上关于OpenAI测试“GPT-6.2 Betelgeuse”模型的传闻,指出其源头是一条仅3个赞的X推文,声称模型ID出现在“官方日志”中却从未提供可验证证据。信息链从X推文经Runtimewire(被指一人运营的AI垃圾内容网站)到Reddit,每一环都缺乏一手核实,形成脆弱的单链引用而非多源交叉验证。Reddit社区共识认为证据缺失是核心问题,但无人能展示“官方日志”。讨论还衍生出对AI模型命名复杂化的讽刺。文章据此揭示AI新闻生态的信任赤字:验证成本被转嫁给读者,AI生成内容加剧信息污染,社区讨论本身反而放大了传闻热度。
传闻从何而来?
最近,Reddit上一条帖子引发热议:有“消息源”声称OpenAI正在测试一款名为GPT-6.2 Betelgeuse的模型,其内部代号“Bel”也浮出水面。据帖子描述,该信息源自某X平台用户的爆料,随后被一家名为Runtimewire的网站报道,进而被Reddit用户转发讨论。
然而,这个看似劲爆的消息,在链条的每一环都经不起推敲。正如评论区一位用户所总结的:“一篇X帖子声称……这篇文章毫无意义。”
信息链的断裂:从“官方日志”到“三赞推文”
整个传闻的核心证据是什么?发帖人声称模型ID出现在“官方日志”中。但当网友追问“什么官方日志?有任何证据吗?”时,却没有得到任何可验证的链接或截图。
一位用户直言不讳地指出:“这个‘消息源’的帖子只有3个赞和1条回复,完全没提他是怎么拿到这些细节的。”换句话说,一个网站引用了一个推特用户声称某件事“据称”发生了,而 “据称”背后没有任何证据支撑。
这并非孤例。另一位用户批评道:“人们会对X感到愤怒,然后引用一条或一小群推文作为来源——这就是现代‘新闻’的典型操作。”
更关键的是,Runtimewire这家媒体的可信度也遭到质疑。有评论指出:“Runtimewire就是一个由一个人运营的AI垃圾内容网站。” 这反映出的问题,比新闻业本身更值得玩味——在AI生成内容泛滥的当下,信息的分发速度远超验证速度。
AI垃圾内容网站(AI slop site)指主要靠大语言模型批量生成低质、同质化内容以获取流量的站点。这类网站通常由个人或小团队运营,缺乏编辑审核流程,内容生产周期极短,常围绕热门话题快速“洗稿”或拼凑。其危害在于:它们能迅速为未经证实的传闻提供看似“媒体报道”的外壳,使一条低可信度推文在引用链中获得伪权威性。识别特征包括:域名陌生、作者信息模糊、文章结构模板化、大量使用“据称”“据报道”等模糊措辞而不给出一手链接。在AI新闻生态中,这类站点已成为信息污染的重要节点。
多源交叉验证:共识与分歧
围绕这一传闻,Reddit讨论中形成了几点共识:
- 证据缺失是核心问题。无论支持还是质疑,多数用户都认同:没有可独立验证的“官方日志”,传闻无法被当作事实。
- 新闻链条过于脆弱。从X推文到Runtimewire文章再到Reddit帖子,每个环节都在引用上一环,却没有提供一手证据。
- 单一来源的可信度极低。那篇仅有3个赞的推文,被多位用户视为“零验证”的典型。
分歧则体现在对“官方日志”的解读上。一位用户坚称:“不,这真的在官方日志里。X帖子就是这么说的,而且我确认过。”但当被要求提供证明时,对话便无疾而终。这种“我确认过”却无法展示证据的回应,恰恰暴露了传闻的脆弱性。
另有一位用户尝试追问:“X帖子到底声称什么?说这个名字出现在官方日志里……你为什么不把句子说完呢?”——这指向了信息传播中的选择性呈现:爆料者往往只抛出半句话,留下想象空间。
交叉验证(cross-verification)是新闻与情报分析中的基本方法:对同一事实,寻找两个及以上相互独立的来源进行比对,且每个来源都应能追溯到一手证据。独立性的关键在于来源之间不存在引用关系——若A引用B、B引用C,则A、B、C不构成多源,只是同一条信息链的延长。在本事件中,X推文、Runtimewire文章和Reddit帖子构成的是单链而非多源,因此无法完成交叉验证。有效的交叉验证还要求来源可核查,例如官方发布日志、API文档变更记录或多家独立媒体的分别确认。
模型命名的狂欢:当调侃照进现实
讨论中也不乏幽默的讽刺。有用户抱怨模型选择越来越复杂:“我只想要三种模式:有点聪明、聪明、非常聪明。”
随即有人接梗:“不行,你会得到Astra黑洞、Astra脉冲星和Astra中子星。而Astra黑洞下面,还分轻量、中量、大量、超大量、超大大量和超大大量终极版。”
另一位用户则虚构了更夸张的版本:“OpenAI正在开发未发布的前沿模型家族GPT-6.7,你可以选择Alcubierre、Schwarzschild和Singularity等层级。前两个有超快模式,消耗20倍token换来10倍加速;最后一个有超光速模式,消耗无限token,但推理快到破坏因果律,能让你在开始前就完成任务。”
这些调侃背后,是对AI模型命名愈发玄学化、产品线愈发复杂的集体吐槽。但笑过之后,问题依然存在:当传闻本身成为流量密码,谁来为信息的真实性负责?
Alcubierre、Schwarzschild与Singularity均为物理学概念,被网友借来讽刺模型层级命名。Alcubierre指墨西哥物理学家米格尔·阿尔库维耶雷提出的“曲速引擎”度规,通过压缩前方空间、膨胀后方空间实现超光速旅行,本身不违反广义相对论。Schwarzschild指卡尔·史瓦西解出的黑洞度规,即静态球对称黑洞的时空描述。Singularity(奇点)则是广义相对论中时空曲率趋于无穷的边界。这些术语与“Betelgeuse”(参宿四,一颗红超巨星)一样,被用来制造科幻感十足的命名层级,调侃AI产品线从“聪明”走向“玄学”的膨胀趋势。
传闻背后的真问题:AI新闻生态的信任赤字
这起事件的意义远超一个模型代号的真假。它揭示了AI新闻生态中的结构性缺陷:
第一,验证成本被转嫁给了读者。 原始爆料者不提供证据,媒体不核实,读者被期望“自己判断”。一位用户的反问很到位:“在有人贴出直接查看‘内部日志’的方法之前,这怎么能被严肃对待?”
第二,AI生成内容的泛滥加剧了信息污染。 当“一个人运营的AI垃圾内容网站”能轻易成为新闻源,整个分发链条的过滤机制形同虚设。
第三,社区讨论本身也成为传播的一部分。 Reddit上的质疑帖反过来增加了话题热度,让更多人知道了“GPT-6.2 Betelgeuse”这个代号——哪怕它从未被证实。
对于关注AI行业的读者而言,一个实用的建议是:看到“据报道”“消息源称”时,先找一手证据。如果找不到,不妨把它当作一次社区猜谜,而非行业新闻。
至于OpenAI是否真的在测试Bel或Betelgeuse?在没有可验证的官方信息之前,这只是一个由三赞推文引发的故事。而故事,终究不是事实。
相关推荐
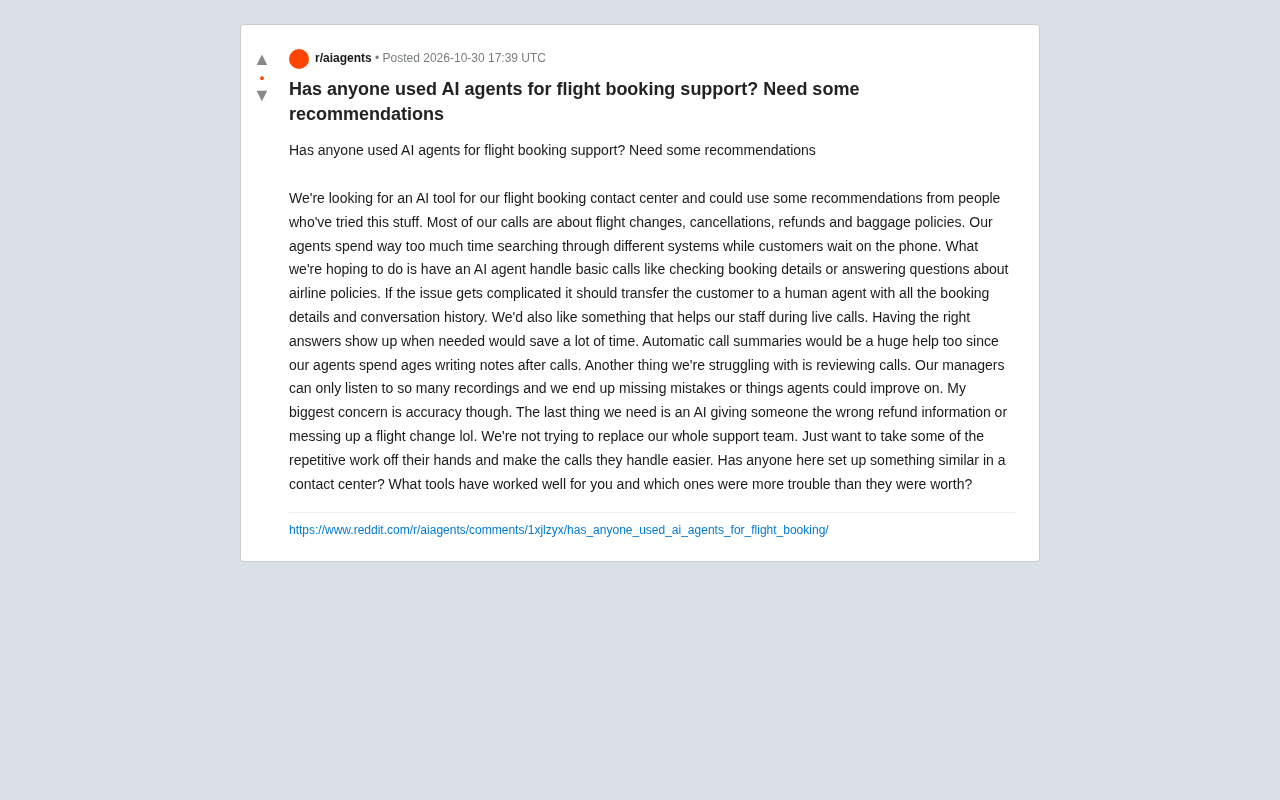
机票预订客服引入AI Agent:真实需求与落地难点
从Reddit真实提问出发,拆解机票预订呼叫中心引入AI Agent的四类需求:基础问答、座席辅助、通话摘要与质检,并分析准确性顾虑与转人工边界的设计要点。

Vercel 统一运行时缓存:Data Cache 并入 Runtime Cache
Vercel 将 Data Cache 并入 Runtime Cache,统一 Next.js fetch 缓存、unstable_cache、getCache 与 use cache: remote 的存储配额与计费,Pro 和 Enterprise 项目获得更大存储空间,缓存读写开始按 Runtime Cache 定价计费。

谷歌卫星AI服务器升空:Gemma模型在轨生成首条回复
谷歌宣布其搭载TPU的卫星成功启动,板载Gemma 4模型从太空生成首条回复,完成在轨AI推理验证。本文分析太空AI服务器的技术路径、现实约束及对边缘计算与卫星遥感的意义。