OpenAI新模型号称对标旗舰,实测却差80分:性价比陷阱还是真香?

GPT-6.1 Sol以五分之一价格宣称逼近旗舰性能,但第三方实测揭示80分差距与一处静默破坏性API变更。
OpenAI发布的GPT-6.1 Sol并未引入新基座模型,而是在现有架构上做点版本升级,核心卖点是"以旗舰Astra五分之一的价格获得接近旗舰的智能水平"。然而第三方LMSYS Arena数据显示,Sol得分1362,与Astra的1442相差整整80分,OpenAI也始终未公布两者的直接对比基准。真正改变成本结构的是新的提示缓存机制:重复内容享受50%折扣,真实场景下日运营成本可下降近50%。与此同时,一处未公告的破坏性变更——none effort参数被悄然从schema中删除——强制要求遗留系统迁移至新的Responses API,给依赖旧端点的生产系统埋下隐患。综合来看,Sol是中端agent路由的有力候选,但团队必须先完成技术迁移,并依靠内部实证测试而非官方声明来做路由决策。
海外博主的一期实测视频引发热议:OpenAI最新发布的GPT-6.1 Sol打出"接近旗舰性能、价格仅五分之一"的旗号,但第三方基准测试却暴露出80分的性能鸿沟。这到底是企业级AI部署的性价比利器,还是又一次营销话术包装的"点版本"升级?
没有新基座模型的"经济学重构"
这次更新最耐人寻味的地方在于:OpenAI并没有推出新的基础模型,而是在现有GPT-6 Sol架构上做了一次点版本(point-release)升级,命名为GPT-6.1 Sol。表面上,定价结构与前代完全一致——开发者仍然按每百万输入token 2美元、每百万输出token 10美元付费。
真正的卖点藏在一句性能声明里:OpenAI宣称这个点版本的智能水平"几乎追平"其旗舰模型GPT-6 Astra。这句话的财务杠杆非常精确——如果性能站得住脚,架构师就能以查询Astra五分之一的成本,部署接近旗舰级别的推理能力。换句话说,整个发布的核心逻辑不是"更强",而是"同样聪明、便宜得多"。
博主将这次发布拆解为三根支柱:一组未经验证的性能增量、一个极为激进的缓存折扣,以及一处"静默"的破坏性API变更。三者合起来,构成了一次瞄准高频agent工作流的经济攻势。
80分的鸿沟:营销话术与实测数据的落差
OpenAI官方给出的数据看起来相当亮眼。在DeepSWE 1.1编码基准上,新模型相比基础版Sol提升6.4个百分点,且是在更低推理强度下达成;在AutomationBench自动化测试中领先前代4.8分,并比Anthropic的Opus 5.5高出2.2分。
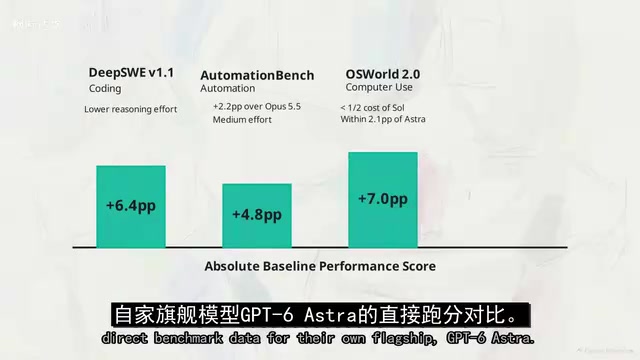
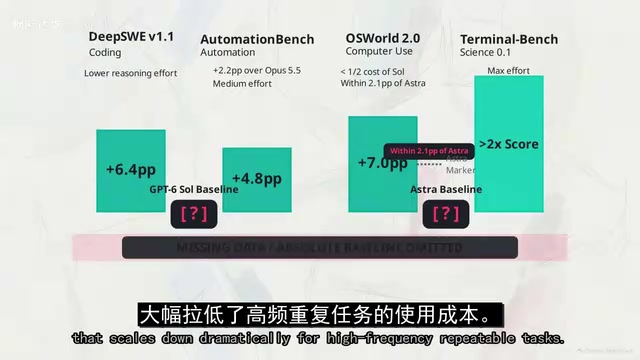
但问题恰恰出在数据的"报告方式"上。OpenAI选择性地公布了与"同等能力模型"(包括自家旧款GPT-6和Opus 5.5)的对比,却唯独没有给出与自家旗舰Astra的直接基准数据。既然官方把Sol包装成Astra的近邻,却拿不出可验证的直接对比,这本身就是个危险信号。
为了填补这个缺口,博主转向了LMSYS Chatbot Arena的众包数据。结果一目了然:Sol得分1362,仅比上一代GPT-5高出1分;而最新旗舰Astra的得分是1442——两者之间横着整整80分的差距。按实际定位,Sol落在"高复杂度"梯队,与Gemini 1.5 Pro、Claude 3.5 Haiku等相差无几,但距离旗舰还很远。
不过博主也坦言:考虑到5:1的巨大成本差,对许多具体工作流来说,这个性价比依然极具吸引力。
LMSYS Chatbot Arena是由加州大学伯克利分校等机构联合运营的开放式大模型评测平台,采用"盲测对战"机制:用户在不知道模型身份的情况下同时向两个模型提问,根据回答质量投票。评分基于Elo等级分算法,与国际象棋排名体系同源——分数差距可直接换算为胜率。两个Elo相差80分的模型,在两两对战中胜率差约为11-13个百分点。这种众包方式虽然存在问题偏向(用户倾向于提有趣而非有代表性的问题)和投票噪声,但因为样本量庞大且难以被厂商操控,业界普遍将其视为官方基准之外最可信的第三方参考。
缓存折扣:真正的经济杠杆
如果说性能是噱头,那么缓存机制才是这次更新真正改变游戏规则的地方。基础费率保持不变,但新的缓存机制为重复内容提供50%折扣——企业可以把一套标准系统指令"锚定"下来,在多次请求中复用时只按每百万token 1美元计费。
博主用一个真实场景说明:一家中型科技公司原本用GPT-6.0自动化客服流程,每天花费175美元;切换到GPT-6.1 Sol并启用提示缓存后,日成本降至88美元——同样的工作量,运营支出下降49%,等于在预算不变的前提下把自动化吞吐量翻倍。
从单位经济学看,缓存输入token的费率被砍半,从每百万0.20美元降到0.10美元。以每月处理1亿token、80%缓存命中率的企业agent为例,GPT-6 Sol架构下月成本56美元,而6.1 Sol降至48美元,整体下降14.3%。随着多agent持续上下文循环把缓存命中率推高到80%以上,这种节省会呈线性增长。
提示缓存(Prompt Caching)的核心原理是:当多次API请求共享相同的前缀内容(如系统提示、RAG检索到的固定文档块、少样本示例)时,服务端只需对该前缀做一次KV缓存计算,后续请求直接复用已计算的键值对,从而跳过重复的注意力计算开销。缓存命中率的高低直接决定节省幅度——在agent工作流中,系统提示和工具定义往往占到每次请求token量的60-80%,这使得缓存命中率容易稳定在高位。需要注意的是,缓存默认开启后,共享基础设施上的缓存条目在理论上存在跨请求数据残留风险,这也正是博主特别提示团队重审数据管道的原因:开发者需要确认哪些内容可以被缓存、哪些包含用户敏感信息必须主动规避缓存。
藏在点版本里的破坏性API变更
真正需要警惕的,是博主反复强调的第三根支柱——一处未公开宣布的"静默"破坏性变更。
OpenAI把缓存默认开启后,移除了cache control请求头的要求。好处是集成自动化、省去配置;代价是开发者失去了对"哪些数据留在缓存里"的精细控制。这不只是优化,而是结构性转变——团队必须重新审视数据管道,确保不会意外泄露或持久化敏感信息。
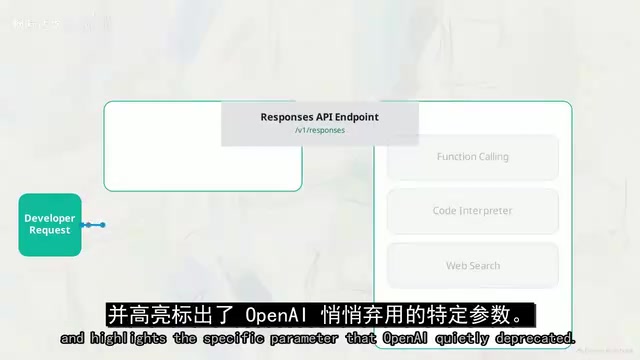
更棘手的是none effort参数被直接从schema中删除。在旧架构下,chat completions端点执行函数调用必须把effort参数设为none。取消它,等于直接"打破"了仍依赖该端点的遗留系统的工具调用能力。要恢复功能,开发者必须把流量迁移到更新的Responses API。换句话说,这是一次伪装在点版本更新里的强制兼容性迁移。
Responses API是OpenAI在2025年推出的新一代接口,旨在取代原有的Chat Completions端点,原生支持工具调用、多轮状态管理和流式函数执行。与旧端点相比,它将"effort(推理强度)"参数的控制逻辑内化到模型本身,不再允许通过外部参数强制绕过推理步骤。none effort参数最初的作用是让开发者在调用函数/工具时跳过模型的链式推理过程,以换取更低延迟和更低成本。它的移除意味着:依赖这一参数来控制推理开销的生产系统,不经改造将直接失效。这类"静默破坏性变更"在工程实践中风险极高——自动化CI/CD流水线通常不会捕获API schema级别的变更,只有在生产流量触发时才会暴露,届时排查成本远高于有计划的迁移。
企业部署的新路由逻辑
综合来看,GPT-6.1 Sol重写了企业路由的标准规则。既然它逼近了Astra的智能上限,旗舰模型今后应只保留给极端高复杂度的边缘案例;标准和中端的agent路由则有充分的财务理由默认切换到6.1 Sol。
但采用它需要团队先付清技术债:完成到Responses API的迁移。博主还点出一个信任赤字——目前没有任何独立论文可以验证OpenAI的相对性能声明,连安全对齐的系统卡附录都被排除在主证据包之外,评估者只能自行寻找外部文档。所谓"与Astra相差2.1分"这类邻近度指标,在缺少绝对基线分数的情况下,根本无法用于路由决策,团队只能依赖内部实证测试。
发布说明里还埋了一个高关注度变量:即将推出的Codex超快变体,OpenAI宣称token生成速度最高可达当前基线的8倍。如果这个速度兑现,再叠加激进的缓存经济学,很可能会重塑下一代编码agent的架构形态。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。