政府AI本地化真正难点:OpenGENAI如何解耦云依赖

一个被误读的开源项目
最近,一个名为 OpenGENAI(源码搜索 firokuagaki-opengene)的非官方项目开始引起关注。它的目标听起来简单:把日本数字厅的政府 AI 应用改造成完全本地化、兼容常见大模型接口的版本。但如果你以为这只是「换个模型」的小工程,那就低估了它真正要解决的问题。
结论很直接:这不是一个给你玩梗的演示项目,而是给那些不想把内部资料丢进云服务的团队看的实用参考。它瞄准的痛点,恰恰是政务和企业级 AI 落地时最容易被忽视的部分——不是模型能力,而是整套云依赖架构。

难点不在模型,而在云依赖
谈到政府 AI 本地化,很多人第一反应是「换个开源大模型不就行了」。但真正的复杂性远不止于此。
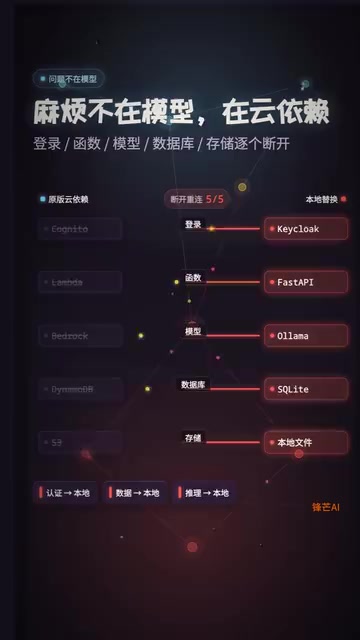
现代云原生 AI 应用通常构建在「服务化」基础上:身份认证依赖 OAuth/OIDC 协议的云端实现,后端逻辑运行在 AWS Lambda、阿里云广告函数计算等 Serverless 平台,模型推理通过 OpenAI API 或云厂商托管端点调用,数据则分散在托管数据库(如 RDS、DynamoDB)和对象存储(如 S3、OSS)中。这种架构的优势是快速交付、弹性扩展,但每一个环节都形成了对特定云厂商的隐性绑定——即所谓的「厂商锁定」(Vendor Lock-in)。
根据项目说明,数字厅的原版应用依赖了一整套云端能力:
- 云端登录(身份认证)
- 函数计算(Serverless 后端)
- 托管模型(云上推理服务)
- 云数据库和对象存储(数据与文件持久化)
这意味着,即便把模型本身换成本地部署,登录、后端逻辑、数据存储、文件处理仍然牢牢绑定在云服务上。对于要求数据不出内网的政务场景而言,仅仅替换模型远远不够。
OpenGENAI 最有价值的洞察正在于此:AI 本地化的本质是解耦整套云依赖,而不是替换单一组件。
数据主权:为什么政务场景容不下云托管
这里有必要理解「数据主权」(Data Sovereignty)这一概念的现实压力。数据主权指数据受其产生所在国家或地区法律管辖的原则。近年来,欧盟 GDPR、中国《数据安全法》《个人信息保护法》以及各国政府的数据本地化要求,使得将敏感数据传输至境外云服务在法律层面面临越来越高的合规风险。日本数字厅推进政务 AI 的背景下,同样面临《个人情报保护法》修订带来的数据出境限制。这也解释了为何「去云化」对政务场景而言不只是技术偏好,而是硬性合规要求——一旦涉及公民个人信息或政府内部文件,数据流向外部云服务在法律层面可能直接构成违规。
架构改造:三件事最关键
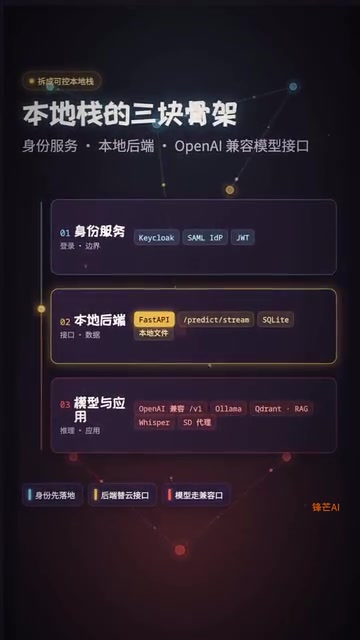
OpenGENAI 的做法是将认证、聊天历史、文件处理、推理流全部替换为本地组件。从架构上看,有三个关键改造方向:
本地身份服务
原版依赖云端登录函数,OpenGENAI 用本地身份服务接管整个认证流程。这一步看似基础,却是数据主权的第一道门槛——用户身份和登录信息不再经过外部云。
本地后端替代云接口
原本运行在函数计算上的业务逻辑迁移到本地后端,解决了 Serverless 架构对特定云平台的强绑定问题。
大模型走兼容接口
模型接入通过兼容常见大模型接口的方式实现,团队可自由选择本地部署的开源模型,不必被某家托管服务锁定。
值得一提的是,OpenAI 在 2023 年发布的 Chat Completions API 格式,已事实上成为大模型接口的行业标准。Ollama、vLLM、LM Studio、LocalAI 等主流本地推理框架均提供与该格式兼容的接口,使得上层应用可以在不修改业务代码的情况下,自由切换底层模型——无论是 Llama 3、Mistral、Qwen 还是其他开源模型。OpenGENAI 采用「兼容常见大模型接口」的设计,本质上是利用这一事实标准来实现模型层的可替换性,这也是私有化部署架构中降低迁移成本最有效的设计选择之一。
此外,知识库检索、语音转写、图片生成也被拆分为独立的本地应用。这种模块化设计让系统的每个环节都变得可控、可替换。
别把它当成开箱即用的神话
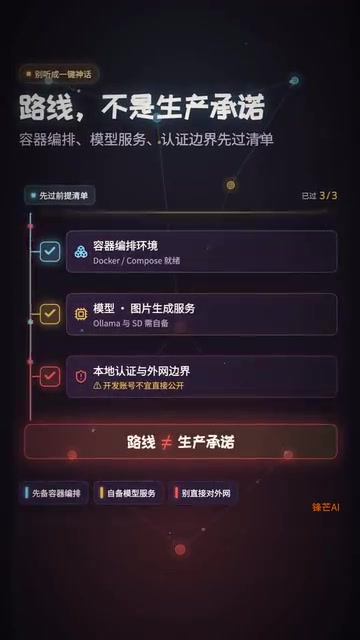
方向值得肯定,但项目说明本身也列出了前提条件,有几点必须说清楚:
- 需要具备容器编排环境(Container Orchestration)
- 需要自行准备模型服务和图片生成服务
- 开发账号与本地认证不适合直接暴露在公网
容器编排通常指以 Kubernetes(K8s)为代表的容器管理平台,负责自动化部署、扩缩容、服务发现和故障恢复。对于中小型团队,也可选择 Docker Compose 或轻量级的 K3s 方案。这一门槛直接将「开箱即用」的期望拦在了门外,也划定了目标受众——具备一定 DevOps 能力的工程团队,需要掌握容器镜像管理、网络配置、持久化存储挂载等基础运维能力,而非普通业务用户。
OpenGENAI 提供的是一条私有化部署的迁移路线,而不是开箱即用的生产系统。它降低了从零设计架构的成本,但落地仍然需要相当的工程能力。把它当成「下载即用」的神话,只会带来失望。
热度尚早,但方向值得盯
从项目热度来看,OpenGENAI 还处于非常早期的阶段。截至采集时,代码平台上仅显示 110 个星标、8 个分支,以开源项目的标准衡量,这个数据还很稚嫩。
但它的方向值得持续关注。它做的事情,是把「政府 AI 的云绑定」这一沉重包袱拆解为三个可控部分:
- 本地认证——身份不出内网
- 本地数据——聊天历史、文件、知识库全部本地化
- 本地模型——通过兼容接口自由选型
为什么这件事值得关注
随着越来越多政府机构和大型企业引入生成式 AI,「数据主权」与「合规」正在成为绕不开的门槛。云托管方案固然省事,但对于处理敏感内部资料的场景,将数据交给外部云服务往往是不可接受的——不仅是安全顾虑,更是法律层面的强制约束。
OpenGENAI 的价值在于提供了一个可参考的去云化改造范式:不是简单换掉模型,而是系统性地识别并替换每一个云依赖节点——从身份认证、业务后端,到数据存储和模型推理,形成一套完整的本地化闭环。这种思路对任何想构建私有化 AI 系统的团队都有借鉴意义。
它可能不会成为爆款,但它所指向的方向——把 AI 应用从云服务锁定中解放出来——恰恰是私有化部署浪潮中最实际的命题。对于关注 AI 本地化落地的从业者来说,这个项目值得放进观察清单。
核心要点
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。