Opus 5.5 实测:更像人类的写作,更低的成本

Anthropic 发布 Opus 5.5,以更低成本在 agentic 编程基准全面领先,并大幅改善了令用户诟病的"AI 腔"表达风格。
Anthropic 正式推出 Claude 5.5 系列首个模型 Opus 5.5,其综合性能持平或超越 Fable 5.1,但算力消耗更低,API 价格同步下调。基准测试层面,Opus 5.5 在尚未"被刷爆"的 Terminal Bench 4.0 上领先所有竞品,且以显著更低的成本实现。更值得关注的是体验层面的改进:长期被用户批评的生硬"AI 腔"得到明显改善,输出更为简洁直接。在 agentic 编程实测中,模型展示了较强的可视化验证闭环能力——能够在执行过程中主动检查结果,适合无人值守的长周期任务。使用额度也同步提升,Anthropic 此次在性能、价格与用户体验三个维度同时发力,被认为切实回应了用户对旧版 Opus 的核心反馈。
Opus 5.5:Anthropic 这次听进了用户反馈?
Anthropic 的 Opus 5.5 正式发布,作为 Claude 5.5 系列的首个模型,它在几乎所有基准测试中都超越了同期竞品。但真正让人眼前一亮的,并不只是跑分数字,而是这个模型终于摆脱了以往 Opus 系列那种生硬、机械的"AI 腔",开始能够写出更接近人类的自然表达。
从定位来看,Opus 5.5 的性能与 Fable 5.1 持平甚至更优,但相比 Opus 5 消耗的算力更少。换句话说,Anthropic 不再只是单纯堆叠模型智能,而是同时在"把智能做得更便宜"这件事上发力。对用户来说,这种性能与成本的比值,恰恰是当下选择模型时最看重的指标之一。
配合发布,Anthropic 还下调了 API 定价——输入、输出以及缓存 token 的价格都有小幅下降。这种在模型质量、价格和使用激励上的全面竞争,正是竞争环境给用户带来的实实在在的好处。
基准表现:Terminal Bench 4.0 成为亮点
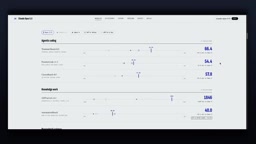
在一众 agentic(智能体)编程基准中,Opus 5.5 几乎碾压了其他所有模型。其中最值得关注的是 Terminal Bench 4.0——这是 Terminal 2.1 的新迭代版本,也是目前少数尚未被"刷爆"(saturated)的基准之一。Opus 5.5 在这项测试中表现强劲,甚至超过了 Astra 和 Fable 5.1。
更关键的是成本维度。在不同推理(reasoning)设置下,Opus 5.5 不仅在 Terminal Bench 上领先其他模型,而且是在显著更低的成本下实现的。这种"又好又便宜"的组合贯穿了几乎所有的 agentic 编程基准。
不过需要客观看待基准测试。跑分通常无法完全代表真实世界的编程能力,它更多是提供一个"预期指标"。例如在 Frontier Code 这类推理基准上,就出现了一些反常现象:medium 推理档位的表现反而比 high、extra high 更好,且接近 max 档位。这种奇怪的曲线不只出现在 Opus 身上,Fable 同样如此。合理的解释是,模型表现高度依赖训练数据的分布,这个基准可能对这些模型来说属于分布外(out of distribution)数据,因此才会出现违反直觉的结果。
关于"饱和"(saturation)与基准失效
基准测试"被刷爆"是指某个测试集的题目或解法已被大量模型的训练数据覆盖,导致高分不再代表真实能力,而只是记忆重现。这是 AI 评估领域长期存在的问题:一旦某个基准流行起来,它就会逐渐渗入下一代模型的训练语料,分数随之虚高。Terminal Bench 4.0 之所以受到关注,正是因为它聚焦于在真实终端环境中完成多步骤任务,这类任务难以被静态数据集覆盖,因而更不容易被"记住答案"。分布外(out-of-distribution)数据则是另一个相关概念:当测试样本与模型训练时见过的数据分布差异较大时,模型的表现往往会出现不规律的抖动,这正是文中 Frontier Code 基准上"推理档位越高反而越差"这一反常现象的合理解释。
真正的升级:沟通风格更像人类
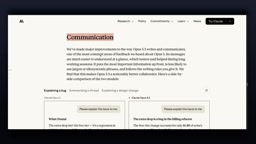
Anthropic 官方表示,他们对 Opus 5.5 的写作与沟通方式做了重大改进。这正是用户对 Opus 5 反馈最集中的痛点——它的消息往往带着一种不自然的、很别扭的表达风格。
改进后的效果在对比示例中相当明显。面对同一个问题的解释,旧模型 Fable 会绕开重点、堆砌冗余信息;而 Opus 5.5 则直接给出"免费层级的变化只占 Acme 八月下滑的 1.1%"这样简洁、聚焦的结论。测试者反馈,这种一眼就能看懂的消息,在长时间运行的会话中帮助很大。
对日常使用者而言,这意味着阅读模型输出会变得更轻松、更愉悦。这类体验层面的提升,往往比单纯的基准分数更能影响实际工作流中的效率。
Agentic 编程实测:验证闭环是关键
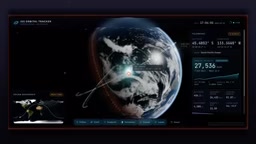
在 agentic 编程任务上,Opus 5.5 的表现确实出色,尤其是它的"验证闭环"(verification loop)。在实测中,模型不仅会写代码,还会在浏览器里对输出结果进行可视化验证。这一步对于让模型无人值守地执行长周期任务来说至关重要——没有自我验证,长链条任务很容易在中途跑偏。
几个实测 Demo 可以说明问题:
- 黑洞模拟:在详细 prompt 下,模型生成了视觉质量相当不错的输出,并提供了密度等各类可调参数控制。
- 国际空间站实时追踪:这是作者的常用测试项,不仅考验视觉输出,还考验实时 API 调用能力。Opus 5.5 不仅实时追踪了 ISS 位置,还把太阳摆在了正确的一侧,这个细节处理相当到位。
- 体素艺术(voxel art):模型在 Three.js 场景下表现强劲,生成了迄今所见细节最丰富的版本,并高度准确地遵循了 prompt。
什么是"验证闭环"以及为何它对 Agent 至关重要
传统的代码生成模型通常是"一次性输出":写完代码就交给用户,由人来判断对错。而 agentic 场景下,模型需要自主完成多个步骤——拉取数据、编写代码、执行、检查结果、修复错误——整个流程可能持续数分钟甚至数小时而无需人工干预。在这种情况下,若模型缺乏自我验证机制,一旦某个中间步骤出错,后续所有步骤都会建立在错误的基础上,最终结果可能完全偏离预期,且用户很难定位问题出在哪一环。验证闭环的核心思想是让模型在执行每个关键步骤后,主动检查输出是否符合预期(例如在浏览器里渲染并目视确认),再决定是继续还是回退重试。这种"执行-验证-修正"的循环模式,是将语言模型从"代码补全工具"升级为"自主执行 Agent"的关键工程能力之一。
产品落地与使用额度
Opus 5.5 现已在 Claude Code 和 Claude 桌面应用中上线,用户需要更新客户端,也可以通过 API 以 opus-5.5 标签调用。默认的推理档位设置为 medium,这也是官方推荐的档位;对于更复杂的任务,调到 high 可能会得到更好的结果。
在"让模型自主调研并搭建产品发布网站"的测试中,Opus 5.5 的视觉质量仍有提升空间,但它为基准数字加入了精巧的动画效果,整体排版也相当用心——而且这些视觉元素完全是模型在 Claude Code 中自行生成的,没有借助任何现成素材。
使用额度方面也有好消息:Anthropic 不仅提升了 5x 的额度,还提高了每周限额,并给予用户重置速率限制的能力。这一点很可能是受 OpenAI 的做法启发——竞争对手之间的相互借鉴,最终让用户受益。
总结
Opus 5.5 是一次均衡且扎实的升级:更自然的沟通风格、更强的代码质量与验证能力、更低的定价,以及更低的 token 消耗。对于长期被 Opus 旧版"AI 腔"困扰的用户来说,这次 Anthropic 似乎真的听进了反馈。基准分数之外,真正值得期待的是这些改进能否在日常真实工作流中稳定兑现。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。