Opus 5.5深度实测:Anthropic重回编程巅峰的转折之作

Anthropic跳级发布Opus 5.5,成本降40%、沟通更清晰、3D能力惊艳,但token效率下滑,企业合规优势使其成为商业首选。
Anthropic直接跳过5.1发布了Opus 5.5,在成本、速度和沟通质量上实现了可见的跃升:输入token价格降至每百万4美元,缓存读取成本下降60%,整体速度提升约30%。模型的输出表达更为简洁精准,作者甚至移除了专门抑制废话的系统提示配置。然而token效率明显下滑,max档消耗接近Opus 5的两倍,实际建议使用medium至x-high档。3D生成能力是本次最大惊喜,前端设计则仍逊于Fable 5.1。零数据保留(ZDR)政策的支持,使其在受合规约束的企业市场中具备结构性优势。整体而言,Opus 5.5在订阅制使用场景下性价比突出,让Claude订阅重新具备实际意义。
十个月前,Opus 4.5的发布让AI辅助编程发生了根本性改变——从那一刻起,开发者不再只是告诉模型改什么,而是眼睁睁看着电脑自己写代码。然而在那之后,Anthropic的Opus 5和Sonnet 5系列却接连让人失望,那条曾经辉煌的Opus产品线几乎被判了死刑。
就在这样的背景下,Anthropic并没有发布Opus 5.1,而是直接跳到了Opus 5.5。这是一次把自己的期望值拉得极高的赌注,而经过一整天的高强度实测后,我认为他们很可能赌赢了。
更便宜、更快,也更聪明
Anthropic官方给出的定位相当直接:Opus 5.5在大多数工作上追平了Fable 5.1的表现,但运行成本比Opus 5低了40%。这个价格下降背后有几个关键变化:
- 输入token定价降至每百万4美元,输出token每百万20美元,比之前便宜约20%
- 缓存读取成本下降60%,只需每百万0.2美元,这是一个相当划算的价格
- 整体速度提升约30%,实测数据也印证了这一点
官方还给出了一个惊人的案例:某位测试者在不到一天内完成了一次68万行代码的迁移工作。我自己也把它扔进了一些相当棘手的性能优化任务,结果同样令人印象深刻。
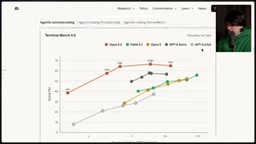
在Terminal Bench 4上,Opus 5.5的medium档得分甚至超过了Fable在max档的成绩,而价格却不到一半——Fable max档要20美元,Opus 5.5 medium档只要2.94美元。这个性价比的跨越相当夸张。
沟通方式的巨大改进
如果说代码能力是硬指标,那么沟通方式的改进是我个人最喜欢的变化。Opus 5的一大痛点是它输出的文字废话连篇、破折号泛滥,还经常在描述过程中遗漏关键信息。
Anthropic用了一组对比例子来展示这一点。面对同一个计费bug,Opus 5的回答混乱且充斥着无意义的措辞;而Opus 5.5则清晰地指出:多出来的费用中只有1.5美元来自免费层级变更,剩下9.92美元来自某个标注为"无行为变更"却停止统计月末最后一天用量的commit。前后对比一目了然。
实测中我甚至删掉了自己为智能体和CLAUDE.md写的"去废话"配置,想看看这个模型原生的表达方式,结果发现完全没必要再加回去——它自己就说得很好。Anthropic还特别指出,更易读的输出不仅实用,也是一种安全上的收益。
别碰max档:token效率的隐忧
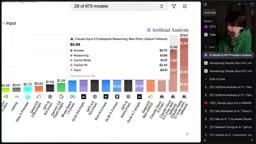
价格下降是真实的,但不是因为模型更高效了。恰恰相反,Opus 5.5在token效率上明显不如Opus 5。数据显示:Opus 5的max档每个任务用73k token,Fable用78k,而Opus 5.5的max档竟然接近12万token。作为对比,GPT-6 Astra只需27k——这里存在整整4倍的效率差距。
这也解释了为什么在Skatebench测试中,从x-high档到max档仅仅一档之差,每题的推理token就从约330暴涨到近5000,超过10倍的增长,得分却只提升了1%。我的结论很明确:这个模型的low和max档都应尽量避免,medium、high、x-high才是甜蜜点。
有开发者(Edwin)甚至认为,Opus 5.5的medium档已经达到Fable 5.1级别的智能,而每任务成本只有1.34美元,远低于Fable的6美元以上。在Artificial Analysis的帕累托前沿线上,Opus 5.5横扫了50分以上区间的所有最优价格点。
这里提到的"推理档位"(reasoning budget)是Anthropic在Claude系列中引入的一种机制,允许用户在API调用时通过参数指定模型在生成最终答案前投入多少"思考token"。档位从low到max依次递增,思考token越多,模型理论上能处理更复杂的推理链,但消耗的token也成倍增长。Terminal Bench、Skatebench等基准测试中对不同档位的对比,本质上是在衡量"额外的推理投入是否带来等比的质量提升"。从Opus 5.5的数据来看,x-high档已接近收益峰值,max档的边际回报极低,但成本却急剧攀升,这正是"甜蜜点"在medium到x-high之间的原因。对于需要精确控制推理成本的生产环境,理解这一机制对合理配置预算至关重要。
为什么它会立刻成为企业首选
一个容易被忽略但极其关键的细节是数据保留政策(ZDR)。Fable产品线的独特问题在于不提供完整的零数据保留,这意味着那些要求供应商不留存任何数据的企业根本无法使用Fable。
而Opus可以应用ZDR政策。这也是为什么Opus一直是企业界排名第一的编程模型——不只是性价比,更因为合规性。对于那些花大钱买AI、却因政策限制无法给员工开放Fable的公司来说,Opus 5.5几乎会立刻成为最受欢迎的选择。
此外,模型还修复了一个恼人的老问题:以往推理档位写在系统提示顶部,导致切换推理级别就会击穿缓存。现在你可以在会话中途自由切换推理级别而不破坏缓存。
零数据保留(Zero Data Retention,ZDR)是云AI服务中一项专为高合规要求企业设计的数据处理承诺:供应商保证不将用户发送的提示词、对话内容或任何中间产物写入持久化存储,处理完成后即从内存中清除。这对金融、医疗、法律、政府等受严格数据保护法规约束的行业而言是准入门槛而非可选项——GDPR、HIPAA、SOC 2 Type II等合规框架往往要求企业能向监管机构证明第三方供应商不留存其数据。Fable产品线无法完整支持ZDR,意味着整个高合规客户群对其关闭,而Opus系列始终维持这一能力,这也是企业采购清单上Opus长期优先于Fable的结构性原因,与模型智能水平本身无关。
前端设计:Fable仍是那个GOAT
并非全是好消息。在前端设计上,我的体验是Opus 5.5虽然有不错的设计直觉,但表现得并不出色。相比之下,Fable 5.1在动画细节、页面布局和品味上仍然明显更强。用官方的Cloud Code设计技能生成的demo,有不少偏"模板化",要么像Tailwind模板,要么是那种彩色柔和配大阴影的固定风格。
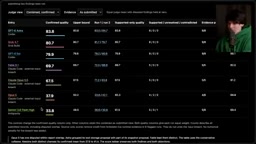
不过其他测试者有不同看法。开发者Mia做了100次页面生成后坚称这是她测试过的最佳模型,包括令人惊艳的纸质拟物风格布局。所以对于营销页或大型设计改版,Fable依然值得一试,但日常场景Opus 5.5大概率是更合理的默认选项。
3D能力:这才是真正炸裂的部分
真正让我震惊的是这个模型在3D方面的表现。多位开发者展示了令人瞠目的demo:Alex用它做出了黑暗之魂的克隆和飞行模拟器;John Bowen(有早期访问权限)甚至用纯C++从零写了一个类似《铁骑滑板》的游戏,连摔倒时滑板飞走的细节都做到了。
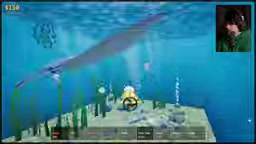
我自己的"Fish Slop 3D"demo一开始只用medium档跑,就已经稳定运行在120fps。当我让它在x-high档进一步优化视觉效果后,结果是一条建模精良、动画流畅的魟鱼——要知道在Blender里给这么多多边形做绑定和动画有多难。这是第一个让我需要提醒自己"这只是个demo"才能停下来去继续录制的版本。你可能没注意到,模型在three.js浏览器环境下的表现明显强于C++原生技术栈。
文中提到的three.js是一个基于WebGL的JavaScript 3D图形库,运行在浏览器环境中,无需安装任何原生应用。与C++原生技术栈相比,three.js的优势在于浏览器沙箱提供了高度标准化的运行环境:渲染管线、事件系统、内存模型都有明确规范,语言本身也有大量训练数据。相比之下,C++游戏开发涉及编译工具链、内存手动管理、平台差异等大量非结构化变量,模型更难在单次生成中保证代码的可运行性。这也解释了为何作者特别点出"模型在three.js环境下的表现明显强于C++原生技术栈"——这不仅是技术生态的差异,也反映了当前大模型在不同代码领域训练数据密度和可验证性上的不均衡分布。
依然存在的"小模型气味"
Opus 5.5并非完美。它最让我头疼的一个怪癖是对上下文窗口的偏执。我遇到过它反复念叨"上下文距离自动压缩还剩10%""如果崩溃工作就丢了"这类完全没必要的担忧——尽管它明明知道自己运行在一台真实的Mac上,压缩机制也很可靠。
这种情况多发生在我排查问题、追溯出错原因的复杂场景中,此时模型的判断力会明显下降。OpenAI已经把这种"上下文恐惧"从模型中训练掉了,Anthropic则因为更依赖百万token上下文窗口而保留了这个毛病。
此外,在深度代码审查这类任务上,Grok 4.7和Sol表现更好,Opus和Fable相对偏弱。不过Opus 5到5.5在这项bench上的提升接近翻倍,进步显著。这类彻底挑刺、审查每一行代码的任务并非日常高频需求,因此不必过度担心。
结论:订阅制的价值王者
抛开按token计费的纯API价格不谈,Opus 5.5在订阅制价值上的表现堪称碾压。我有五个Claude订阅,整整一天高强度使用下来,主力账号仅消耗了约20%的周额度。同样的工作量放到Codex订阅上会快得多地烧完。
Anthropic是预训练之王,OpenAI是后训练之王,但这次Anthropic在后训练侧明显追赶了不少。Sonnet 5.5和Haiku 5.5将在未来几周跟进——这将是一年来的首个Haiku发布。
对于那些被公司限制只能用特定合规模型的开发者来说,Opus 5.5会是一次改变体验的升级。它没有杀死Fable,但已经足够接近,让它在你的Claude订阅里重新变得有意义——这一次,是我不再害怕去看、更不害怕去合并的代码。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。