Opus 5.5与GPT SOL/LUNA同期发布:AI大模型开卷性价比
Anthropic与OpenAI同步推出多档位降价模型,AI竞争从拼能力上限转向拼性价比。
Anthropic发布Opus 5.5(输入4美元/百万Token),OpenAI同期推出SOL(2/10美元)与LUNA(0.1/0.5美元),两家旗舰厂商几乎同步将定价策略推至台前。Opus 5.5以接近前代旗舰的能力换取更低价格,瞄准高复杂度任务;SOL主打控制成本的中高端开发场景;LUNA则以极致低价打开大规模高频调用市场。这轮发布标志着AI大模型竞争从单一的「能力上限」维度,正式扩展到「单位能力成本」的性价比竞争阶段。对企业和开发者而言,任务分级调用将逐渐成为主流成本优化策略,谁能同时做到「又强、又便宜、还真能干活」,谁就更有可能赢得长期市场。
AI模型战争进入新阶段
Anthropic的Opus 5.5和OpenAI的新一代模型几乎同一时间发布,两家旗舰产品有一个共同的信号:能力越来越强,价格却被压得越来越低。据B站UP主的分析,这标志着AI大模型的竞争从单纯比拼「谁最强」,正式进入「谁又强又便宜还真能干活」的性价比阶段。
过去几年,头部厂商的比拼逻辑几乎只有一个维度——能力上限。谁能在编程、推理、Agent任务上做到更好,谁就占据话语权。而这一轮同期发布的产品,把定价策略推到了台前,价格分层开始覆盖完全不同的使用场景。
Anthropic Opus 5.5:旗舰能力先降价
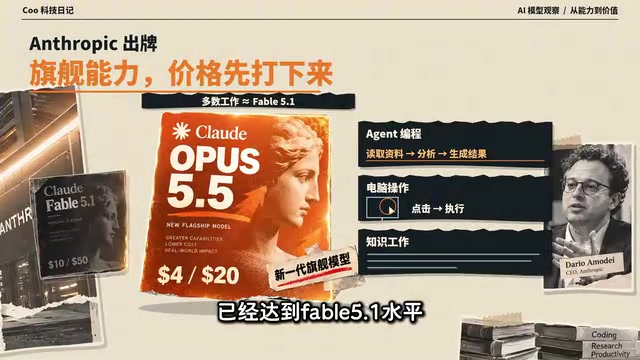
根据原始素材的说法,Opus 5.5在多数工作上已经达到此前旗舰(Faber 5.1)的水平,但价格只要每百万Token输入4美元、输出20美元。换句话说,Anthropic选择了「把旗舰能力的价格先打下来」这条路线。
这种打法的核心在于稳住高能力、复杂工作的场景。对于需要处理长上下文、复杂推理或高质量输出的任务,Opus 5.5依然定位在偏高端的区间,但相比过去同级别模型的定价,性价比明显提升。
OpenAI SOL与LUNA:一口气打出价格差异化
OpenAI这一轮更为激进,直接推出了SOL和LUNA两款模型,配合最高档的Astra形成完整的价格梯队。
SOL主打复杂编程和Agent任务,定价为每百万Token输入2美元、输出10美元。它强调的是「在够强的前提下,把成本压下来」,瞄准那些既需要一定能力、又对成本敏感的开发场景。
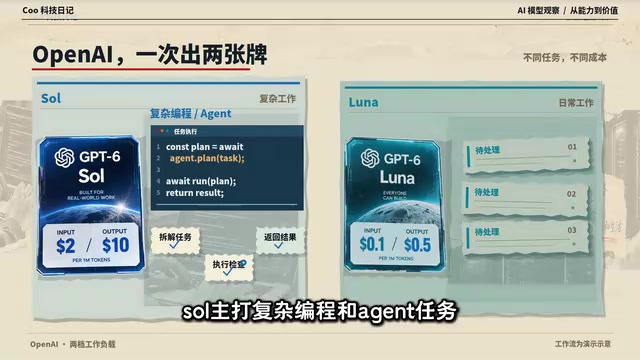
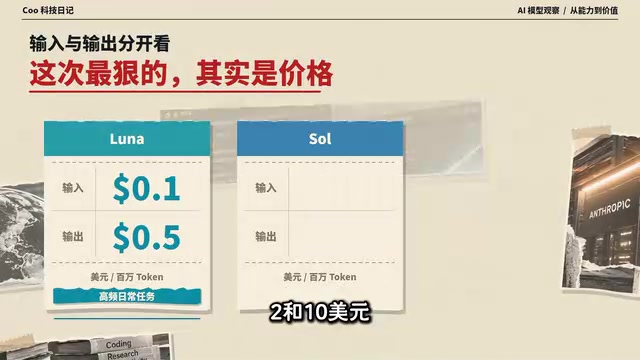
LUNA则更夸张,价格直接低到输入0.1美元、输出0.5美元。这个价位几乎把大规模、高频调用的门槛拉到了地板,适合那些对单次质量要求不高、但调用量巨大的场景。
而追求OpenAI最强能力的用户,Astra依然是最高档的选择。三款产品从高到低,覆盖了从极致能力到极致低价的完整光谱。
Token(词元)是大语言模型处理文本的基本计量单位,大致上每100个汉字约对应150-200个Token,每100个英文单词约对应130个Token。「每百万Token」的定价方式是API调用的行业标准计费单位,开发者实际成本取决于单次对话的输入输出长度乘以调用次数。以LUNA的0.1美元/百万输入Token为例,处理100万字的中文文本(约150-200万Token)成本不足0.2美元,这一价位使得大规模文档处理、内容审核、数据标注等高频低复杂度场景的AI化成本降至可忽略不计的水平。
两种打法:能力优先 vs 成本优先
把两家的产品放在一起看,可以清晰看到路线上的差异:
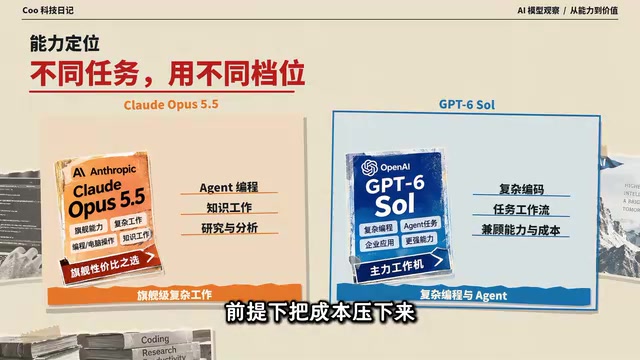
- Opus 5.5(4/20美元):偏向高能力、复杂工作,价格虽然降了但仍属高端档。
- SOL(2/10美元):在够强的基础上强调控制成本,覆盖中高端场景。
- LUNA(0.1/0.5美元):极致低价,覆盖大规模低成本调用。
- Astra:OpenAI的最强旗舰,仍是最高档。
不同档位已经在覆盖完全不同的使用场景。这意味着企业和开发者在选型时,不再是「无脑用最强的」,而要开始算一笔账:这个任务到底值不值得用最贵的模型?
性价比成为下一轮竞争主战场
这轮发布传递出的信号很明确:AI模型的竞争维度正在从「能力上限」扩展到「单位能力的成本」。当多家厂商的旗舰能力逐渐接近,价格和实际交付能力就成了新的胜负手。
对使用者而言,这是好消息——同样的预算能撬动更强的模型,或者同样的能力只需付出更低的成本。任务分级调用(简单任务用便宜模型、复杂任务才上旗舰)会逐渐成为主流的成本优化策略。
下一轮竞争比的可能不再是单一的「谁最强」,而是谁能同时做到「又强、又便宜、还真的能干活」。谁能在这三者之间找到最优平衡,谁就更有可能赢得开发者和企业的长期青睐。
注:本文基于B站单一来源的信息整理,涉及的模型名称与具体定价以官方最终发布信息为准。
任务分级调用(Tiered Model Routing)是一种成本优化架构,指在同一业务流程中,根据子任务的复杂程度动态路由到不同能力档位的模型。例如,客服系统可以让低价模型处理意图识别和常见问题回答,仅在涉及合同条款解读或复杂投诉时才调用旗舰模型。这种架构需要在应用层额外设计路由逻辑和质量检验机制,但在大规模调用场景下往往能将整体API成本压缩50%-80%。随着模型价格梯队的完善,这类混合调用策略将从大厂工程实践逐渐普及到中小开发团队。
相关推荐
WorkBuddy AI智能体实战:从大模型到Agent的落地差异
通过批量转PDF实战对比,解析WorkBuddy AI智能体与大模型产品的本质差异,涵盖授权执行、积分消耗、场景适配与落地认知,帮你判断Agent工具是否适合当前工作流。
GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景AI工程师分享GrokBot工作流:一个月合入约千个PR,智能体自动合并20个。核心方法论围绕验证技能、EVAL测试、Dune架构与硬性CI约束,揭示如何从本地信任走向云端代理自动化。
Bright Data评测:免费额度、AI智能体MCP服务器与定价
Bright Data 提供免费 5000 额度、开源 MCP 服务器及代理/抓取 API。了解其定价模式、AI 助手集成方式和合规注意事项。