Orca:免费开源IDE,同时调度Claude、Codex、Gemini和Grok

Orca 用 Git 工作树隔离和并行提示,把多个编程智能体编排进同一 IDE。
文章介绍了一款名为 Orca 的免费开源 IDE,旨在解决同时使用 Claude、Codex、Gemini、Grok 等多个编程智能体时的碎片化痛点。其核心设计是每个任务分配独立的 Git 工作树,实现天然的分支隔离,并支持将同一提示词并行发送给多个智能体、对比输出后合并最优结果;同时智能体可以反向驱动 Orca 自动打开新面板,便于实时监控。Orca 还支持手机端接力、远程 SSH 工作树、GitHub 集成、AI diff 评论与无限终端分屏,跨 Mac、Windows、Linux 平台。文章认为这反映了多智能体时代编排层价值上升的趋势。
多智能体编程的痛点:一场终端里的“杂耍”
每个编程智能体都有自己擅长的领域——Claude 长于推理,Codex 精于代码补全,Gemini 和 Grok 各有千秋。但当你同时使用它们时,工作流就变成了一场杂耍:每个智能体开一个终端,复制提示词、粘贴、再手动检查每个结果。这种碎片化的体验不仅低效,还容易出错。
YouTube 频道近期介绍了一款名为 Orca 的工具,试图解决这个矛盾。它的核心思路很简单:让多个智能体在同一套工作流里并行运转,而不是各自为政。
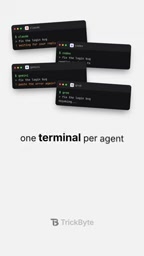
Orca 的核心机制:Git 工作树隔离
Orca 最关键的设计是 每个任务拥有独立的 Git 工作树。这意味着当多个智能体同时处理不同任务时,它们不会互相干扰——每个智能体在自己的工作树里修改代码,相当于天然的分支隔离。
据视频介绍,你可以把同一个提示词发送给多个智能体,然后对比它们的输出结果,最后合并最优的那一个。这种“并行生成、择优合并”的模式,把原本串行的手动切换变成了并行的自动协作。
Git 工作树(git worktree) 是 Git 2.5 引入的功能,允许从同一个仓库同时检出多个工作目录,每个目录对应不同的分支或提交,却共享同一份 .git 对象数据库。与传统的 git clone 多份拷贝相比,工作树节省磁盘空间,且分支、提交、标签等引用天然互通。
对多智能体场景而言,工作树的价值在于:每个智能体在独立目录里读写文件,文件系统层面不会互相覆盖;切换任务时也不需 stash 或反复 checkout。需要注意的是,同一分支不能被两个工作树同时检出,因此 Orca 为每个任务分配独立分支,合并时再通过普通 Git 流程完成。
智能体反向驱动 IDE
Orca 另一个有意思的特性是 智能体可以驱动 Orca 本身。视频作者提到,他的智能体会为每个长任务自动打开一个新的面板,这样他就能在智能体持续工作的同时实时观察进度。
这打破了传统 IDE 中“人操作工具、工具辅助人”的单向关系——智能体成为了 IDE 的操作者之一。配合无限终端分屏和设计模式,开发者可以构建一个多层级的监控视图,而不必在多个窗口间反复切换。
移动端接力与远程协作
Orca 支持从手机端继续推进任务。这意味着你可以在离开电脑后仍然监控智能体的运行状态,或者在通勤路上给某个智能体下达新指令。
此外,它还内置了 远程 SSH 工作树 和 GitHub 集成,把本地开发、远程服务器和代码托管平台串联在同一个界面里。对于需要跨环境协作的团队来说,这减少了大量上下文切换的成本。
细节功能与平台覆盖
Orca 还提供了一些提升日常体验的功能:
- 设计模式:在编码之外提供视觉化的设计辅助
- AI diff 评论:可以直接在智能体生成的代码差异上添加评论,方便审查
- 无限终端分屏:支持任意数量的终端面板并列
- 跨平台:运行在 Mac、Windows 和 Linux 上
最关键的一点是,Orca 免费且开源,可以从 orca.dev 下载。对于想要同时利用多个编程智能体、又不想被终端切换拖累的开发者来说,这是一个值得尝试的选项。
多智能体工作流的未来形态
Orca 的出现反映了一个趋势:随着编程智能体数量增多,编排层的价值正在上升。单个智能体的能力固然重要,但如何让多个智能体协同、隔离、对比和合并,才是决定实际生产力的关键。
Git 工作树隔离解决了冲突问题,并行提示解决了对比问题,智能体驱动 IDE 解决了监控问题——这三个设计组合在一起,指向了一种“智能体操作系统”式的开发环境。当然,这类工具的实际体验还需要在真实项目中检验,但方向本身值得关注。
相关推荐

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。

2B参数模型本地跑音频与视觉:LFM3实测揭秘
海外博主在 MacBook Air 上实测 Liquid AI 的 LFM3 Audio 2B 与 Omni 2B:2B 参数离线跑语音与视觉,工具调用超预期,但噪声转录与幻觉问题明显。