Osprey:通用预训练让推测解码草稿模型更高效
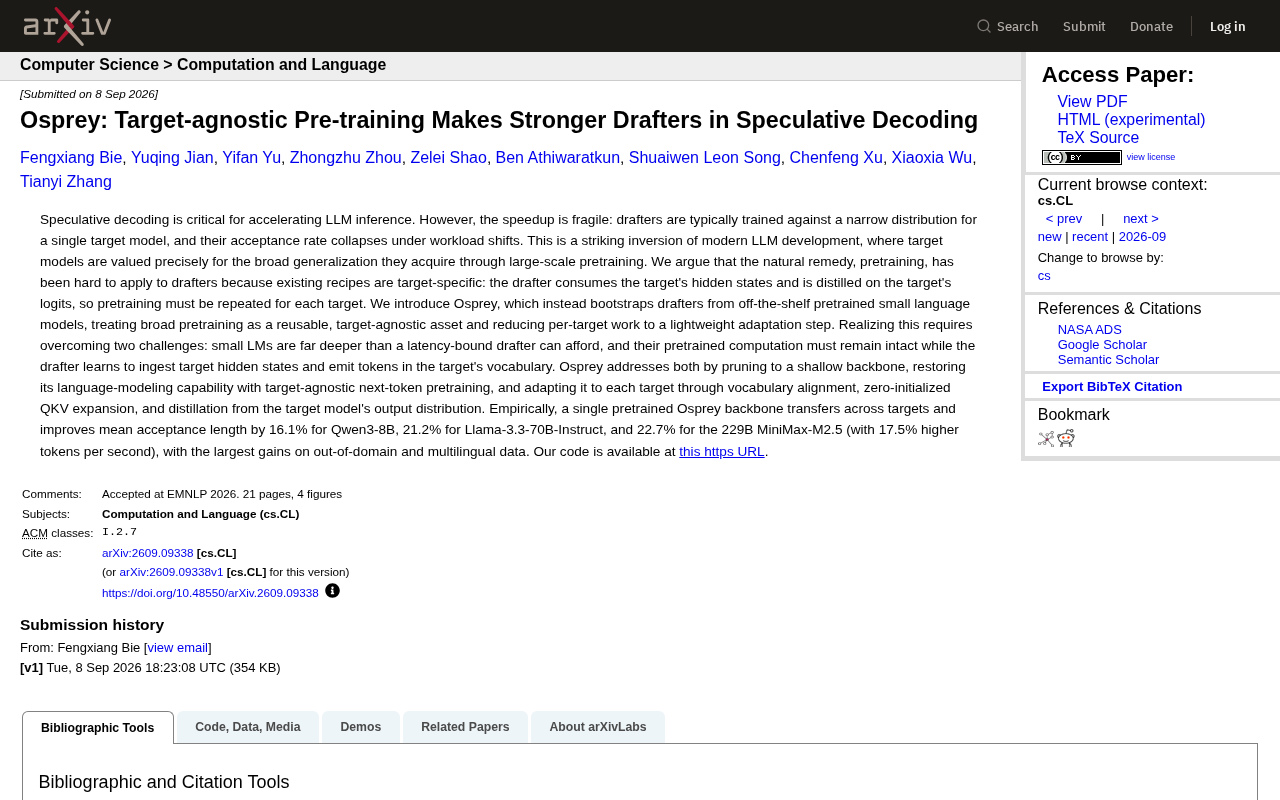
推测解码的草稿模型为何如此脆弱
大语言模型(LLM)的推理加速一直是业界关注的焦点,而推测解码(Speculative Decoding)作为关键技术之一,却面临一个致命问题:现有的草稿模型(drafter)过于脆弱。
推测解码是一种利用"先猜测后验证"思想加速大语言模型推理的技术。这一思想最早可追溯到编译器优化和CPU设计中的推测执行(Speculative Execution),即在确认结果之前先乐观地执行计算,如果猜测正确则节省时间,否则回滚。在CPU领域,现代处理器的分支预测器(Branch Predictor)通过预测条件分支的方向并提前执行指令来隐藏流水线延迟,预测正确时节省数十个时钟周期,错误时冲刷流水线并回滚状态。推测解码在LLM推理中的角色完全类似——草稿模型扮演"分支预测器",目标模型扮演"执行单元",接受/拒绝机制对应流水线的提交/冲刷。这种跨领域的架构思想迁移体现了计算机科学中"用廉价预测换昂贵计算"这一普遍优化原则。
其核心思路是:用一个体积更小、推理速度更快的草稿模型一次性生成多个候选token,然后由目标大模型(verifier)并行验证这些token是否可接受。由于大模型验证多个token的并行计算成本与生成单个token相当,当草稿模型的猜测命中率足够高时,整体推理吞吐量可以获得数倍提升。这一技术由Google DeepMind在2023年正式提出(Leviathan et al.),几乎同时Chen et al.也独立提出了类似方案。其数学基础建立在拒绝采样(rejection sampling)之上——具体而言,对于草稿模型生成的每个token x,验证器计算接受概率 min(1, p(x)/q(x)),其中p(x)是目标模型的概率,q(x)是草稿模型的概率;如果被拒绝,则从修正分布 max(0, p(x)-q(x)) 中重新采样。这一机制在数学上严格保证了最终输出的分布与直接使用目标模型自回归解码完全一致——即无损加速,这也是它区别于量化、剪枝等有损加速方法的核心优势。值得强调的是,这种无损特性在工程上意义重大:量化(Quantization)通过降低权重精度(如FP16→INT4)来加速推理但会引入量化误差导致输出分布偏移,剪枝直接移除参数也会改变模型行为,而推测解码的拒绝采样机制可以与这些方法正交组合使用,在不引入额外精度损失的前提下叠加加速效果。推测解码的核心指标是平均接受长度(Mean Acceptance Length, MAL),即每次验证中被接受的连续token数量,该值越高说明草稿模型与目标模型的分布越匹配,加速效果越好。
此后,推测解码迅速衍生出多种变体:Medusa通过在目标模型上附加多个解码头实现自草稿(self-drafting),Eagle利用特征级别的预测提升接受率,Lookahead Decoding则通过Jacobi迭代避免使用独立草稿模型。具体而言,Medusa在目标模型最后一层之上并行附加多个MLP头,每个头独立预测未来第k个位置的token,避免了维护独立草稿模型的开销,但其预测质量受限于单层MLP的表达能力。Eagle更进一步,利用目标模型中间层的特征向量作为输入进行下一token预测,相当于在特征空间而非token空间进行"草稿"。Lookahead Decoding则基于Jacobi迭代的并行解码思想,将自回归序列生成重新表述为非线性方程组的求解问题,通过同时猜测多个位置并迭代修正来实现并行化。这些方法反映了一个核心权衡:自草稿方法(self-drafting)无需额外模型但受限于目标模型的架构约束,独立草稿方法更灵活但引入了模型管理和对齐的额外复杂度。这些变体各有取舍,但共同面临一个根本张力——草稿质量与草稿速度之间的权衡。草稿模型越大越准确,但推理越慢,可能抵消并行验证带来的收益;草稿模型越小越快,但接受率下降又会导致频繁回退。
传统方法中,草稿模型针对单一目标模型在狭窄分布上训练,一旦工作负载发生变化,其接受率就会急剧下降。这与现代LLM通过大规模预训练获得广泛泛化能力的发展路径形成了鲜明对比。
问题的根源在于:现有的草稿模型训练方案高度依赖特定目标模型。它们需要消费目标模型的隐藏状态,并在目标模型的logits上进行蒸馏。这里的logits蒸馏属于知识蒸馏(Knowledge Distillation)技术——其核心思想是让小模型(学生)模仿大模型(教师)的输出概率分布,而不仅仅是学习硬标签。知识蒸馏由Hinton等人在2015年正式提出,其核心洞察在于教师模型的softmax输出中包含丰富的"暗知识"(dark knowledge)——例如在数字识别任务中,一个"7"的图像可能得到教师模型输出:7的概率0.9、1的概率0.05、9的概率0.04。这些非目标类别的小概率值揭示了类别间的语义关系(7和1在形态上相似),这种信息在硬标签(one-hot编码)中完全丢失。蒸馏通常使用带温度参数τ的softmax——提高温度会"软化"概率分布使暗知识更显著,但温度过高则会模糊有意义的概率差异。
在推测解码场景下,logits蒸馏要求草稿模型在每个位置的输出概率分布尽可能接近目标模型的softmax分布,通常使用KL散度作为损失函数。这种方法能让草稿模型捕捉到目标模型在不同token上的置信度细节(即"暗知识"),但其致命缺陷在于训练过程必须持续调用目标模型生成logits,计算成本高昂且产生了对目标模型的强绑定依赖。更本质地说,蒸馏本质上是在训练分布上对教师模型行为的函数拟合,当评估分布偏离训练分布时,这种拟合的外推能力很差——这正是传统草稿模型在域外场景中表现急剧退化的根本原因。这意味着每更换一个目标模型,就必须重新完成整个预训练过程。这种target-specific的设计严重限制了草稿模型的可复用性和适应性。
Osprey的核心创新:与目标模型无关的通用预训练
Osprey的核心理念是将预训练作为一种可复用的、与目标模型无关的资产。研究团队提出从现成的预训练小型语言模型出发,通过轻量级适配步骤来支持不同的目标模型,而不是为每个目标重复整个预训练过程。
这一方案需要克服两大技术挑战:
深度压缩:从小模型到浅层草稿模型
小型语言模型通常比延迟受限的草稿模型深得多。Osprey采用剪枝策略构建浅层主干网络,然后通过与目标无关的next-token预训练恢复其语言建模能力。
具体而言,这里采用的是结构化剪枝(Structured Pruning)方法。与非结构化剪枝(移除单个权重参数)不同,结构化剪枝直接移除整个Transformer层、注意力头或前馈网络通道,从而在不依赖稀疏硬件的前提下获得实际的推理加速。在Osprey的语境中,"从小模型到浅层草稿模型"意味着将一个已经预训练好的小型语言模型(例如具有24-32层的模型)通过移除若干Transformer层压缩为仅保留少量层的浅层网络。
Transformer架构的结构化剪枝比传统CNN剪枝更为复杂。CNN中剪除一个卷积核的影响相对局部,但Transformer层之间通过残差连接(residual connection)形成了信息高速通路——每一层的输出都会直接加到后续所有层的输入上。这意味着移除一个中间层不仅丢失了该层的计算,还会改变残差流(residual stream)中的信息组成,影响所有下游层的行为。近期的机制可解释性(Mechanistic Interpretability)研究表明,Transformer中存在特定的"电路"(circuits)负责完成特定子任务(如感应头负责上下文复制),剪枝时需要避免破坏这些关键电路的完整性。
这一过程的关键挑战在于:深层网络中不同层承担不同的语义功能——浅层通常负责局部语法和词法特征提取,中间层处理语义组合,深层负责高层抽象推理。业界常用的层选择方法包括:基于梯度的重要性评分(如Taylor展开近似)、基于隐藏状态相似度的冗余层检测(如果相邻层的输出高度相似,说明该层的边际贡献较小)、以及基于困惑度(Perplexity)变化的贪心搜索。近期研究(如ShortGPT)发现,Transformer模型中间层的隐藏状态之间往往存在高度的余弦相似性,这些"冗余层"可以被安全移除而对模型性能影响较小。相比之下,首层和末层通常承担关键的输入编码和输出解码功能,移除后性能损失显著。因此需要精心选择保留哪些层,并通过后续的next-token预训练(即在标准语言建模目标上继续训练)来修复因剪枝导致的性能损失。Osprey选择从已有小型模型出发进行剪枝而非从零训练,本质上是利用了预训练模型中已经凝聚的语言知识——这些知识即使在压缩后仍可通过少量训练快速恢复。这一步骤确保草稿模型在压缩后依然具备扎实的语言理解基础。
计算保持与目标适配的平衡
如何在保持预训练计算完整性的同时,让草稿模型学会接收目标模型的隐藏状态并在目标词汇表中生成token?Osprey通过三个关键技术实现这一目标:
-
词汇对齐:不同的大语言模型通常使用不同的分词器(Tokenizer)和词汇表(Vocabulary)。例如Llama系列使用SentencePiece BPE分词,Qwen系列使用基于字节级BPE的自定义分词器,两者的词汇表大小、token粒度和编码方式都存在差异。以"unhappiness"为例,一个分词器可能将其切分为['un','happiness'],另一个可能切分为['un','hap','pi','ness'],还有的可能切分为['unhapp','iness']。这种粒度差异意味着同一段文本在不同模型中对应完全不同的token ID序列。
分词器差异的影响比表面看来更为深远。不同分词器不仅产生不同的token序列,还导致序列长度的差异——同一段文本在一个分词器下可能被编码为10个token,在另一个下可能是13个token。这意味着草稿模型和目标模型在相同输入上可能处于不同的"位置",位置编码(Positional Encoding)的对齐也成为问题。此外,使用Rotary Position Embedding(RoPE)的现代模型中,位置信息直接编码在注意力计算中,token粒度的不匹配会导致注意力模式的系统性偏差。BPE分词器的训练语料不同还会导致对低频词和专业术语的切分策略截然不同——例如"transformers"可能被一个分词器作为整词保留,而被另一个切分为['transform','ers'],这种差异在代码、数学公式和多语言文本中尤为显著。
对于推测解码而言,草稿模型必须与目标模型使用相同的token空间——否则草稿模型生成的token序列在目标模型看来毫无意义,验证过程无法进行。词汇对齐的常见方法包括:嵌入空间的线性映射(通过共享anchor tokens学习两个嵌入空间之间的仿射变换)、基于子词重叠的软对齐(利用两个词汇表中共同的子词片段建立桥接)、以及完全替换嵌入层和LM head。Osprey的词汇对齐机制需要将草稿模型的嵌入层和输出层映射到目标模型的词汇表空间,处理不同分词粒度带来的对齐偏差,并在多个目标模型之间共享尽可能多的预训练知识。Osprey面临的额外挑战在于需要一套通用机制支持多个不同目标模型的词汇表,这要求对齐方案本身具备一定的泛化能力,而不是针对每对模型单独设计映射。这是实现"一个主干支持多个目标模型"的基础性技术障碍。
-
零初始化QKV扩展:在Transformer的自注意力机制中,每个输入向量会通过三个投影矩阵分别映射为Query(Q)、Key(K)和Value(V)向量。当草稿模型需要接收来自目标模型的隐藏状态作为额外输入时,Q、K、V的投影矩阵需要扩展维度以适配更宽的输入。直接随机初始化扩展部分会破坏已有预训练权重的内部表示平衡,导致灾难性的性能下降。零初始化策略的巧妙之处在于:将新增维度对应的权重初始化为零,这样在适配训练开始时,扩展部分的贡献为零,模型行为与扩展前完全一致,然后在后续微调中逐步学习如何利用目标模型提供的额外信息。从函数空间的角度理解:设原始模型计算的函数为 f(x),扩展后的模型计算 f(x, x_new),如果扩展部分权重初始化为零,则 f(x, x_new) = f(x, 0) = f(x),即扩展后的模型在训练开始时与原模型行为完全一致,避免了随机初始化可能引入的大幅扰动。
这一思想在深度学习中有广泛应用:ResNet的残差连接可以看作对恒等映射的零初始化扰动;LoRA将低秩适配矩阵分解为A和B,其中B初始化为零以保证初始时适配贡献为零;GPT-2的残差路径末端也使用了缩放初始化以稳定深层网络训练。这些方法共同体现了一个核心原则:在修改预训练模型时,应确保修改的初始效果为中性,让模型通过梯度下降自主决定如何利用新增的容量。这一思想与残差学习(Residual Learning)和LoRA中的零初始化策略一脉相承,体现了"先保持不变,再渐进学习"的设计哲学。
-
输出分布蒸馏:从目标模型的输出分布中学习,实现高效的知识迁移。与前述的logits蒸馏原理相同,但Osprey的关键区别在于这一蒸馏步骤仅作为轻量级适配阶段存在,而非贯穿整个预训练过程。由于草稿模型已经通过通用预训练获得了扎实的语言建模能力,适配阶段的蒸馏只需在较少的数据和较短的训练时间内完成分布对齐,大幅降低了计算开销。这一设计的深层逻辑在于:通用预训练赋予草稿模型的是对自然语言内在规律的理解能力,而蒸馏适配阶段所做的只是在这一坚实基础上微调概率分布的"形状",使其更接近特定目标模型的偏好——这远比从零开始学习目标模型的完整行为模式要容易得多。
实验验证:单个主干跨模型迁移的显著性能提升
实验结果充分验证了Osprey方案的有效性。单个预训练的Osprey主干可以跨多个目标模型迁移,并带来显著的推测解码性能提升:
- Qwen3-8B:平均接受长度(Mean Acceptance Length)提升16.1%
- Llama-3.3-70B-Instruct:提升21.2%
- MiniMax-M2.5(229B):提升22.7%,同时每秒生成token数提高17.5%
特别说个细节,Osprey在域外数据(out-of-domain)和多语言数据上表现出最大的性能增益。这正是传统target-specific方法最薄弱的环节。传统方案通常在目标模型的典型使用场景(如英文问答、代码生成等)上进行蒸馏训练,其训练数据的分布与评估时的分布高度重合。然而,当输入切换到训练时未覆盖的领域(如医学文献、法律文档)或非英语语言时,蒸馏得到的分布匹配关系迅速退化,接受率大幅下降。
这一现象在统计学习理论中被称为分布偏移(Distribution Shift)问题。分布偏移是统计学习理论中的核心挑战之一:在经典的PAC学习框架中,模型的泛化保证建立在训练分布和测试分布相同的假设(i.i.d.假设)之上,一旦这一假设被违反,模型的性能可能出现不可预测的退化。分布偏移可以细分为协变量偏移(输入分布变化但条件概率不变)、标签偏移(输出分布变化)和概念漂移(输入-输出关系本身变化)。在推测解码的语境中,传统草稿模型面临的主要是协变量偏移:当输入文本的主题、语言或风格偏离蒸馏训练集时,草稿模型学到的"目标模型在这类输入上的输出分布"不再准确,导致接受率下降。域适应(Domain Adaptation)和鲁棒优化(Distributionally Robust Optimization)是解决这一问题的两大技术路线,而Osprey的通用预训练方案本质上是从源头避免了对特定分布的过拟合。
Osprey的通用预训练策略之所以在这些场景中表现优异,根本原因在于其预训练阶段使用的是广泛的语言建模目标,而非特定模型的输出分布,因此草稿模型保留了对自然语言普遍模式的理解能力。这更接近于学习语言的内在规律而非特定模型的行为模式,在面对新分布时表现出更强的鲁棒性。这一发现也暗示了一个更广泛的规律:在LLM系统的各个组件设计中,过度专门化(over-specialization)可能以牺牲鲁棒性为代价——学习通用表征比模仿特定输出更具迁移能力。这充分证明了通用预训练策略在泛化能力上的优越性。
对LLM推理加速的启示与展望
Osprey的成功揭示了一个重要趋势:推测解码技术正在从"为每个模型定制草稿模型"转向"一次训练,广泛适用"的范式。这种转变不仅降低了部署成本,更重要的是提高了系统对不同应用场景的适应能力。
从工程实践角度看,Osprey的设计思路为LLM推理优化提供了新的方向。通过将预训练和适配解耦,开发者可以构建更加灵活和可维护的推理系统。这一思路与软件工程中的"关注点分离"原则高度一致——将通用的语言建模能力(预训练阶段)与特定目标模型的对齐需求(适配阶段)清晰解耦,使得每个阶段可以独立优化和迭代。
这种架构设计也呼应了机器学习领域更广泛的趋势:从基础模型(Foundation Model)到下游适配的范式正在渗透到系统的每一个组件中,不仅是最终的应用模型,连加速推理所用的辅助模型也开始遵循"预训练+适配"的两阶段模式。最初,基础模型的概念主要用于描述GPT、BERT等通用语言模型通过微调适配下游任务。但如今这一范式已经扩展到向量数据库的嵌入模型(通用嵌入+任务适配)、奖励模型(通用偏好学习+任务特定对齐)、检索增强生成中的检索器(通用检索能力+领域微调)等系统的各个层面。Osprey将这一范式引入推理加速组件,标志着LLM系统栈的每一层都在向可复用、可组合的方向演进。这种趋势的经济学逻辑很清晰:预训练是昂贵的一次性投资,适配是廉价的边际成本,通过最大化预训练资产的复用率来摊薄总成本。
随着大模型规模持续增长,这种通用化的推测解码加速方案将变得越来越重要。可以预见,未来可能出现专门的"草稿模型即服务"(Drafter-as-a-Service)生态,开发者只需选择合适的预训练主干并完成轻量级适配,即可为任意目标模型部署高效的推测解码加速。更进一步,随着多模态大模型(如视觉-语言模型、语音-语言模型)的普及,通用草稿模型是否能跨模态迁移、如何处理不同模态间的对齐问题,都将成为值得探索的研究方向。
项目代码已在GitHub开源(https://github.com/LeanModels/Osprey),为研究者和工程师提供了实践和改进的基础。
核心要点
核心要点
核心要点
相关推荐
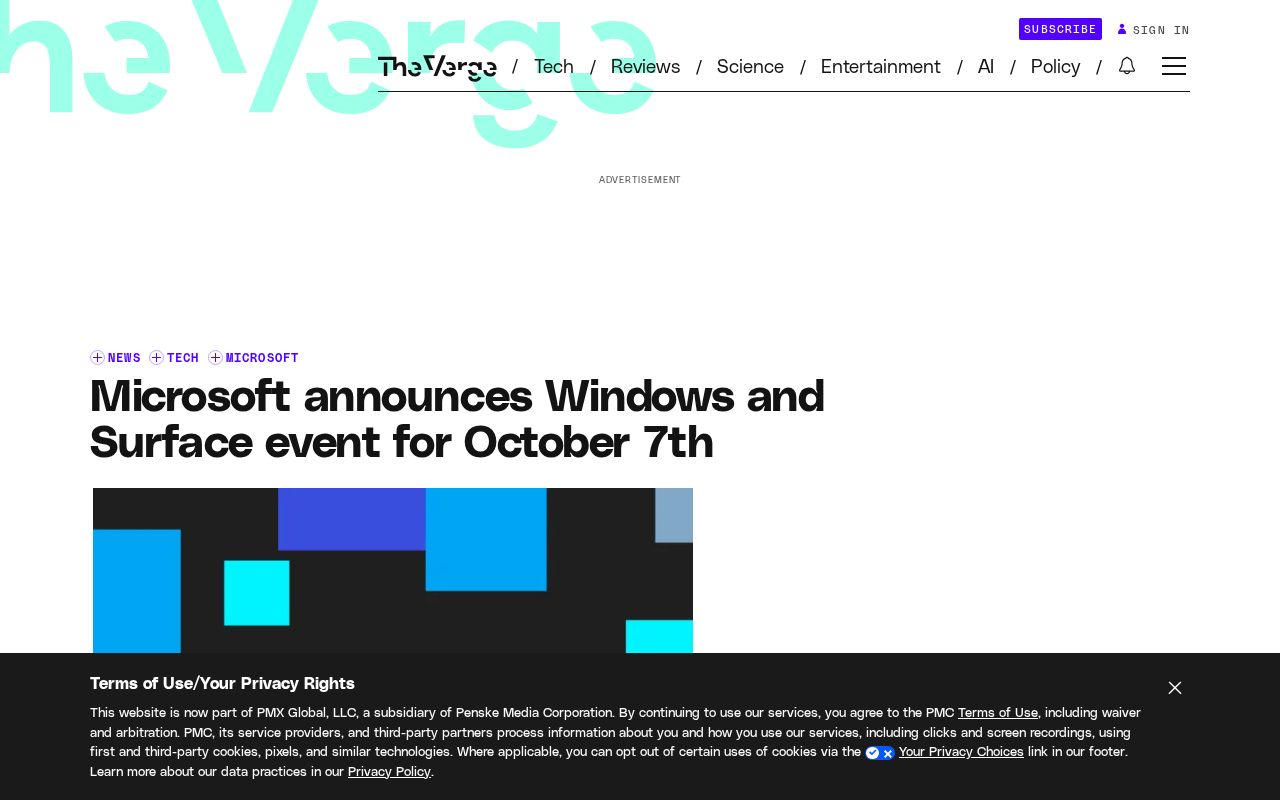
微软官宣10月7日Windows与Surface发布会:本地AI成主角
微软宣布将于10月7日在旧金山举办Windows与Surface发布会,时隔两年再度重磅亮相,核心议题聚焦本地AI如何塑造Windows的未来,或深化AI PC产品形态。
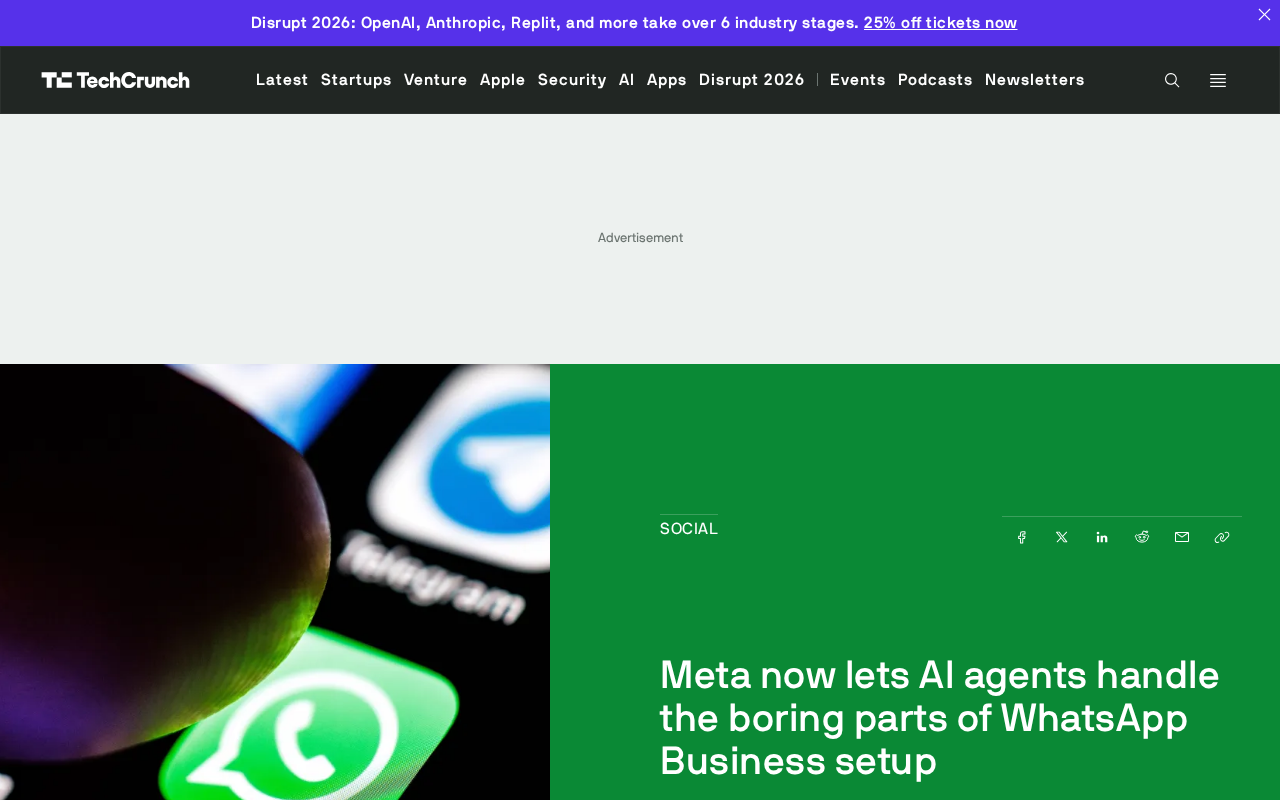
Meta 推出 WhatsApp Business MCP 服务器,让 AI 代理接管繁琐配置
Meta 推出全新 WhatsApp Business MCP 服务器,让开发者可借助 Claude、Cursor、Codex、ChatGPT 等 AI 编程代理自动处理平台配置、消息模板、测试与故障排查,大幅降低接入门槛。
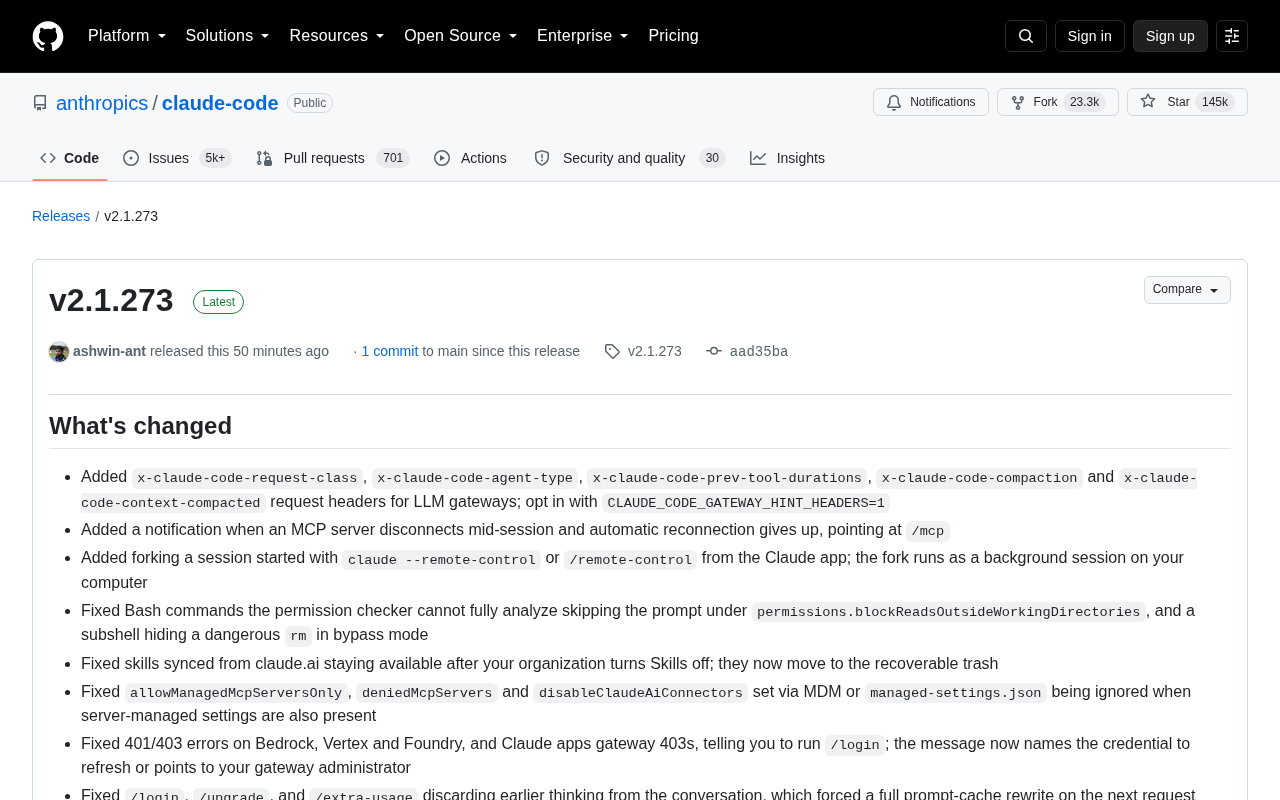
Claude Code v2.1.273更新详解:修复权限漏洞与远程控制增强
Claude Code v2.1.273 版本更新详解,涵盖权限检查安全修复、远程控制会话分叉、MCP 重连、错误提示优化及 Slack 集成与代码审查改进,帮助开发者了解升级要点。