PACE:四比特循环状态量化新方法,让线性注意力模型更省内存

PACE 通过周期性舍入和通道对齐编码实现线性注意力模型状态的后验四比特量化,大幅降低内存占用。
PACE 是一种针对线性注意力语言模型循环状态的后验量化方法,旨在解决低精度状态存储中的精度损失问题。现有量化器在每个生成 token 后立即舍入,导致四比特精度下累积误差显著。PACE 提出两项核心设计:一是周期性舍入,将舍入操作推迟到每几个 token 后执行,减少误差累积;二是通道对齐编码,利用门控 delta 状态中大条目聚集在列上的特性,在列内共享量化尺度。此外,PACE 对舍入误差敏感的头采用八比特混合精度。实验表明,混合精度的 PACE 在多个模型上与八比特基线性能相当,内存仅为其三分之二;全程四比特的 PACE 在同等内存下优于 Q-Mamba。PACE 无需微调即可应用,为长上下文多序列推理提供了实用的内存节省方案。
线性注意力语言模型将上下文保存在固定大小的循环状态中,推理系统为每个同时解码的序列存储一份状态副本。降低状态存储精度可以让更多序列共享加速器,但现有量化器在每个生成 token 后都进行舍入,导致四比特精度损失,除非提高位宽或微调模型。近期提出的 PACE 方法通过周期性舍入和通道对齐编码,实现了后验四比特状态量化,在多个模型上取得 competitive 结果。
为什么需要低精度循环状态?
线性注意力模型(如 Mamba、RWKV 等)的核心优势在于推理时只需维护一个固定大小的状态,而不像标准 Transformer 那样需要缓存整个历史键值对。然而,当同时解码多个序列时,每个序列都需要独立的状态副本。状态精度直接决定了内存占用:四比特状态相比八比特可节省一半内存,意味着同一加速器能服务近两倍的序列数。
现有量化方案(如 DAMP、Q-Mamba)在每个生成 token 后立即对状态进行舍入。这种高频舍入会引入累积误差,导致四比特精度下模型准确率明显下降。PACE 的出发点正是解决这一矛盾:如何在不频繁舍入的前提下保持低精度存储。
线性注意力模型通过循环状态替代标准 Transformer 的键值缓存,其代表架构包括 Mamba(基于选择性状态空间模型)和 RWKV(基于线性注意力变体)。这类模型在推理时,每个解码步骤仅需更新固定维度的状态向量或矩阵,而非存储所有历史键值对,因此内存占用与序列长度无关。但多序列并发解码时,每个序列需独立维护状态副本,状态精度直接影响可并发的序列数量。例如,将状态从 FP16 量化到 INT4,内存占用降至四分之一,理论上可使并发数提升至四倍。然而,低精度量化会引入舍入误差,误差在循环更新中累积,可能导致模型输出质量下降。
PACE 的两大核心设计
周期性舍入:减少误差累积
PACE 的关键观察是:分块内核在预填充阶段已经按块进行舍入,而不是每个 token 都舍入。受此启发,PACE 将舍入操作推迟到每生成几个 token 后执行一次,中间生成的 token 暂存在一个小缓冲区中。这样做的效果是显著降低了状态更新过程中累积的舍入误差。实验表明,这种“少舍入”策略在保持解码速度提升的同时,有效缓解了四比特量化的精度损失。
分块内核(chunked kernel)是线性注意力模型并行计算的一种实现方式,它将长序列划分为固定大小的块,在块内并行计算,块间通过状态传递。在预填充阶段,分块内核通常按块更新状态并进行舍入,而非逐 token 舍入。PACE 借鉴这一思路,在解码阶段也采用类似的延迟舍入策略:将多个 token 的状态更新暂存于缓冲区,累积到一定数量后再统一舍入。这减少了舍入操作的频率,从而降低了舍入误差的累积效应,同时保持了计算的并行性。
通道对齐编码:利用状态列结构
研究团队进一步发现,在门控 delta 状态中,较大的条目倾向于聚集在列上。这是因为某些通道的更新在多个 token 上持续保持较大值。PACE 利用这一结构特性,将每个量化尺度在一个列内共享,而不是独立地为每个元素分配尺度。这种通道对齐的编码方式更匹配状态的实际分布,提高了量化效率。
此外,PACE 对舍入误差保留时间较长的注意力头采用八比特精度,形成混合精度方案。这种灵活性让模型在关键部分保持更高精度,同时整体内存占用仍然较低。
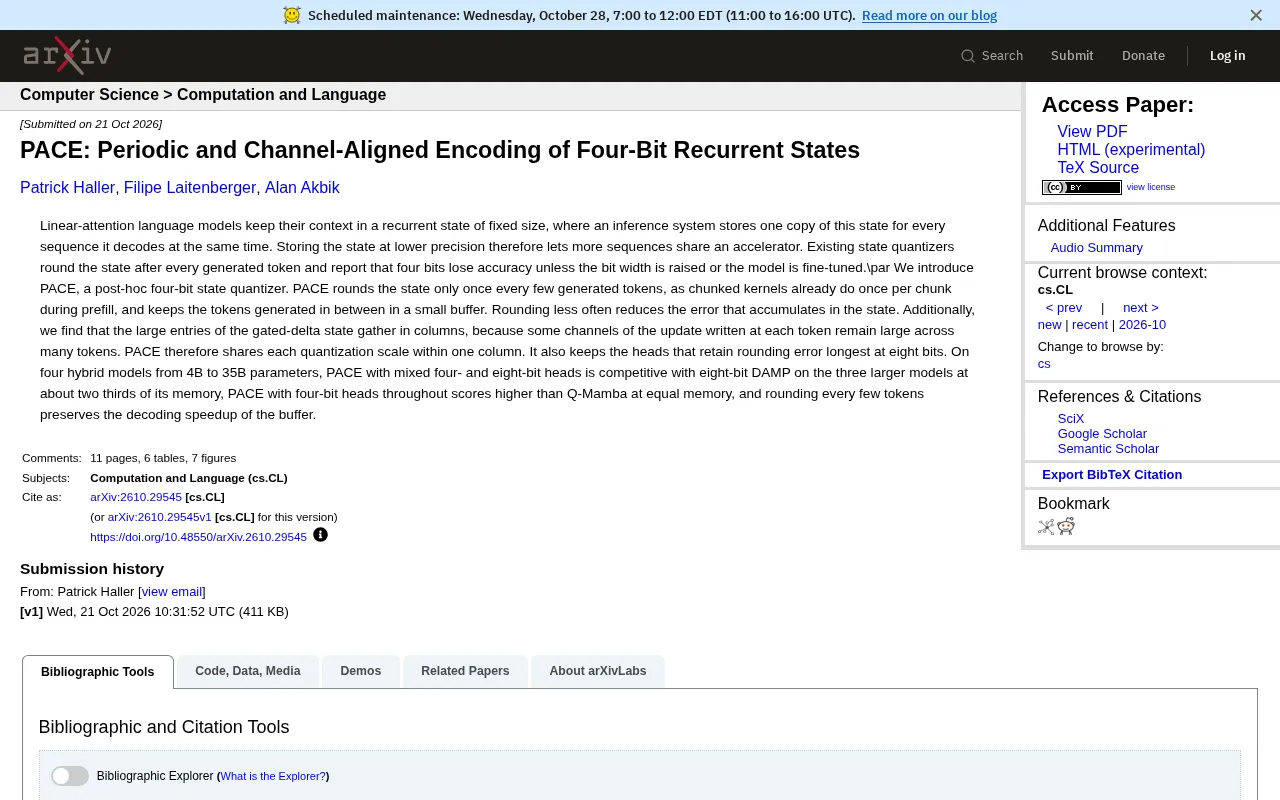
门控 delta 状态是线性注意力模型中的一种状态表示,常见于 GLA(Gated Linear Attention)等架构。其更新规则包含门控机制和 delta 规则,使得状态矩阵的某些列(对应特定通道)在多个 token 上持续接收较大更新,导致大数值在列上聚集。PACE 利用这一结构特性,对每一列共享量化尺度(即列内所有元素使用同一个缩放因子),而非逐元素独立量化。这种列内共享尺度的方式更匹配状态的实际分布,减少了量化误差,同时降低了存储量化尺度的开销。
实验结果:四比特与八比特的权衡
PACE 在四个混合模型上进行了评估,参数规模从 4B 到 35B。主要结果包括:
- 混合四比特和八比特头的 PACE 在三个较大模型上与八比特 DAMP 表现相当,而内存占用仅为其约三分之二。
- 全程使用四比特头的 PACE 在同等内存下得分高于 Q-Mamba。
- 每几个 token 舍入一次的策略保留了缓冲区带来的解码加速效果。
这些结果表明,PACE 为线性注意力模型的状态量化提供了一种实用的后验方案,无需微调即可应用。对于需要在有限硬件上部署长上下文或多序列推理的场景,这种内存节省具有实际价值。
对推理部署的启示
PACE 的意义不仅在于一个量化算法,更在于它揭示了循环状态存储中的一个可优化维度:舍入频率与精度之间的权衡。传统做法默认每个 token 都需要精确更新状态,但 PACE 证明,适度的延迟舍入配合结构感知的编码,可以在几乎不损失准确率的情况下大幅降低内存需求。
随着线性注意力架构在长序列任务中的普及,这类针对循环状态的压缩技术将变得越来越重要。未来或许可以看到更多结合硬件特性的量化方案,进一步推动高效推理的边界。
相关推荐
亚马逊CEO:2200亿美元押注AI基础设施, AWS三年AI营收超250亿
亚马逊CEO Andy Jassy详解2200亿美元AI基础设施投资逻辑:产能售罄至2028年、自研Trainium芯片降本、6人76天重写推理引擎的组织变革,以及数据中心争议与AI安全风险的真实判断。
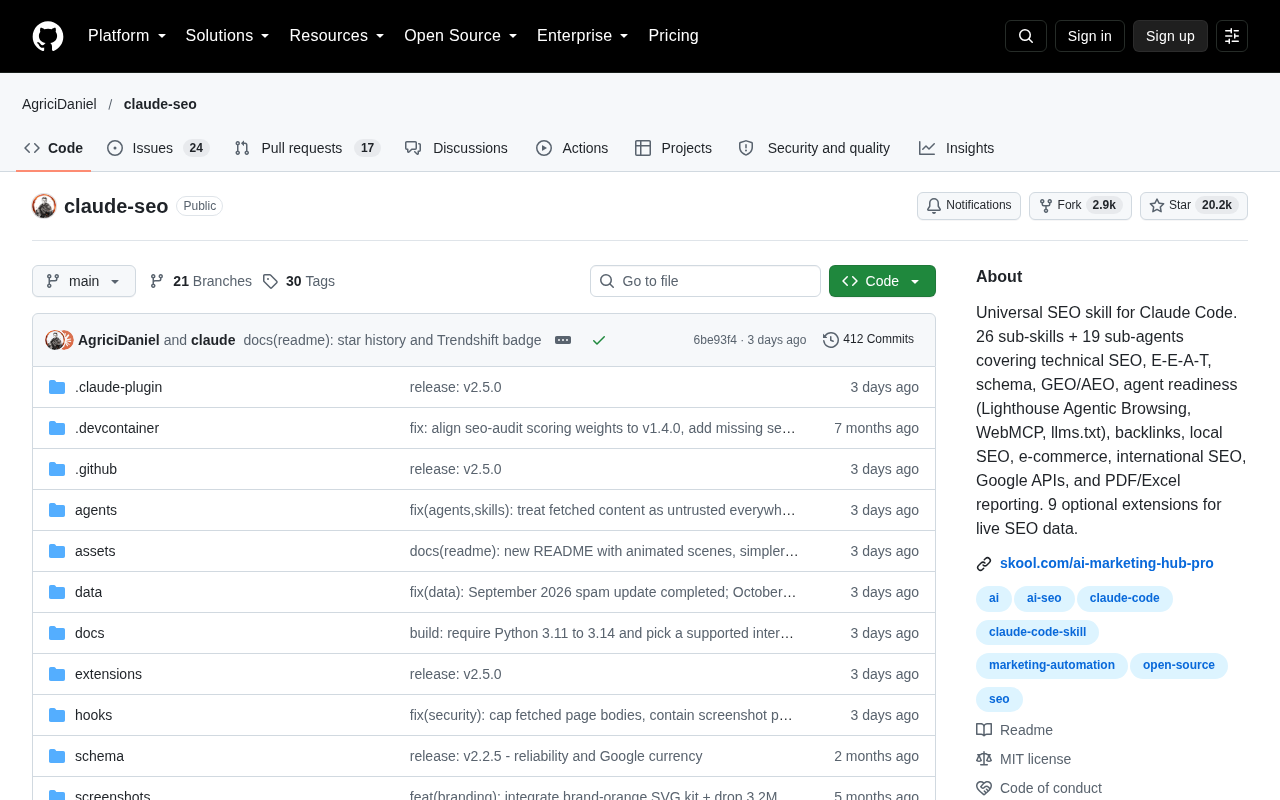
Claude Code 最强 SEO 技能包:26 子技能 + 19 子智能体
GitHub 开源项目 claude-seo 为 Claude Code 提供 26 个 SEO 子技能与 19 个子智能体,覆盖技术 SEO、E-E-A-T、Schema、GEO/AEO、Agent Readiness、外链与本地 SEO,并支持 PDF/Excel 报告与 Google API 集成。

Coolify:自托管PaaS新选择,替代Vercel与Heroku
Coolify 是一个开源可自托管的 PaaS 平台,支持静态站点、数据库、全栈应用及 360+ 一键服务,是 Vercel、Heroku 和 Netlify 的替代方案,GitHub 星标超 63k。