PARGAR:图注意力神经网络接收机如何破解稀疏导频难题

PARGAR将OFDM资源网格建模为图,用导频锚点链接和图注意力提升稀疏导频下的检测性能。
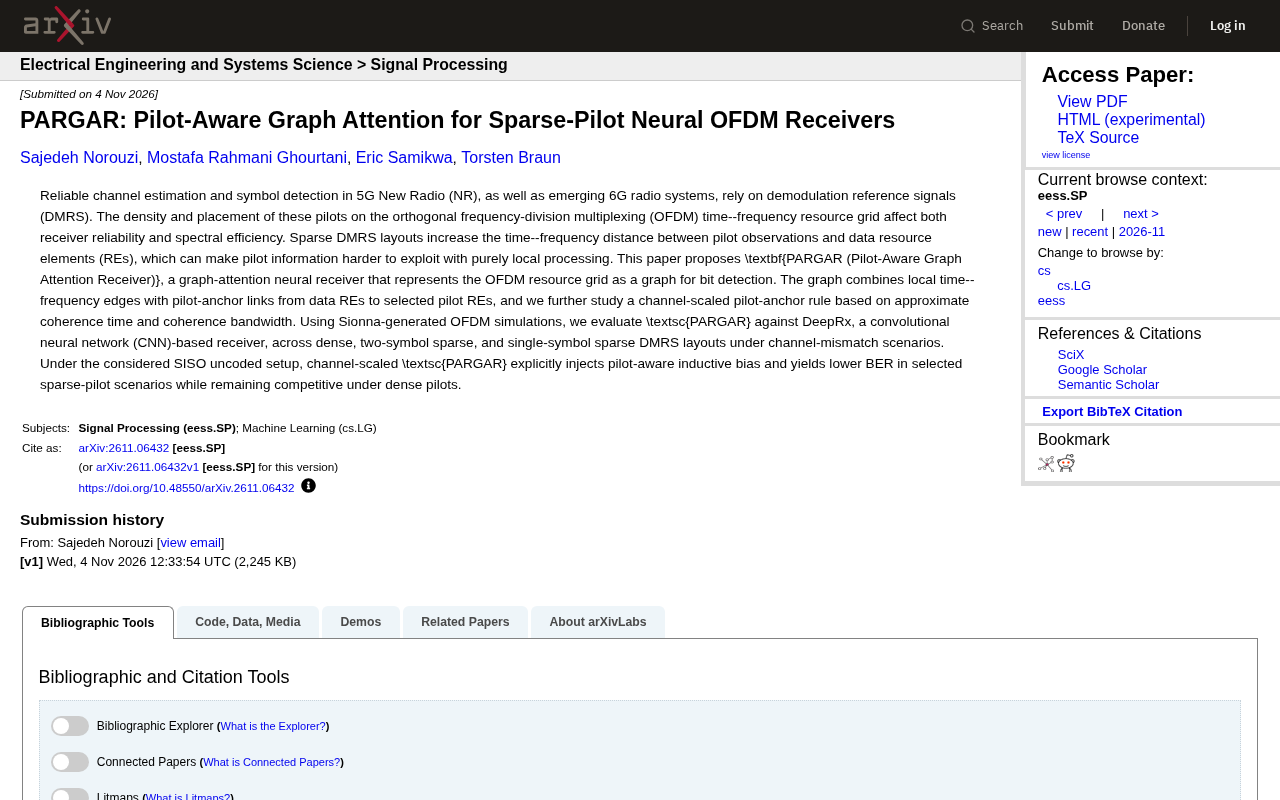
PARGAR(Pilot-Aware Graph Attention Receiver)针对稀疏导频下CNN神经接收机因局部感受野难以利用远处导频信息的问题,将OFDM时频资源网格表示为图:节点为资源单元,边包括局部时频边和将数据RE直接连到选定导频RE的“导频锚点链接”。论文提出基于近似相干时间与相干带宽的信道缩放锚点规则,用信道相干特性决定链接方式,把导频感知作为归纳偏置注入网络结构。在Sionna仿真中,采用该规则的PARGAR在部分稀疏DMRS场景下BER低于CNN-based的DeepRx,密集导频下保持竞争力。结论限定于SISO未编码设置,优势具有选择性,MIMO、编码及计算复杂度仍待验证。
在5G NR与面向6G的无线系统里,解调参考信号(DMRS)是信道估计与符号检测的基石。导频在OFDM时频资源网格上放得越密,接收机越容易做信道估计,但频谱效率也越低;放得越疏,效率上去了,导频与数据资源单元(RE)之间的时频距离却被拉大,传统依靠局部处理的接收机越来越难把导频信息"用足"。最近一篇论文提出的PARGAR(Pilot-Aware Graph Attention Receiver)正是冲着这个矛盾去的:把OFDM资源网格建模成图,用图注意力机制做比特检测。
稀疏导频的痛点:局部处理"看不见"远处的导频
导频密度与接收可靠性、频谱效率三者之间存在天然的张力。密集DMRS布局对接收机友好,但参考信号开销大;稀疏布局(例如单符号或双符号DMRS)能显著降低开销,却让每个数据RE到最近导频的时频距离变大。
问题在于,基于卷积神经网络(CNN)的神经接收机(如DeepRx)本质上依赖局部感受野。当导频稀疏时,远处的导频信息需要经过多层卷积才能"传递"到数据位置,信息在传播过程中被稀释,接收机难以充分利用这些先验。论文的核心观察正在于此:纯局部处理与稀疏导频之间存在结构性错配。
PARGAR的核心思路:把资源网格变成图,给导频加"锚点"
PARGAR的做法是把OFDM时频资源网格表示成一张图,节点对应资源单元,边则有两类:一类是常规的局部时频边,连接相邻RE;另一类是"导频锚点链接"(pilot-anchor links),把数据RE直接连到选定的导频RE上。这样一来,即使导频在物理距离上很远,数据节点也能通过一条显式的边直接"看到"导频。
在此基础上,论文进一步研究了基于近似相干时间与相干带宽的信道缩放导频锚点规则(channel-scaled pilot-anchor rule)。简单说,就是用信道的相干特性来决定哪些导频应该与哪些数据RE建立锚点链接——相干时间与相干带宽刻画了信道在时频上的"相关范围",在这一范围内建立链接,导频信息才更有参考价值。
这种设计的本质是向网络注入"导频感知"的归纳偏置(inductive bias):不是指望网络从数据里慢慢学出导频在哪、该怎么用,而是直接把导频的位置关系编码进图结构。
与DeepRx的对比:稀疏场景下的BER优势
论文使用Sionna生成的OFDM仿真进行评测,对比对象是基于CNN的DeepRx接收机,覆盖密集、双符号稀疏、单符号稀疏三种DMRS布局,并考察了信道失配(channel-mismatch)场景。
在SISO未编码的设置下,采用信道缩放规则的PARGAR在部分稀疏导频场景中取得了更低的误码率(BER),同时在密集导频下保持竞争力。这一结果值得注意的地方在于:它不是靠更大的模型或更多的数据取胜,而是靠图结构把导频先验显式表达出来。换句话说,当导频稀疏到局部卷积"够不着"时,图注意力提供的长程连接恰好补上了这块短板。
需要客观看待的是,论文的结论限定在SISO未编码场景,且稀疏场景下的优势是"选择性"的——并非所有稀疏配置都一致占优。这提示PARGAR的价值更多体现在特定的导频布局与信道条件下,而非全面替代CNN接收机。
Sionna仿真平台
Sionna是NVIDIA推出的开源GPU加速链路级仿真库,基于TensorFlow,支持5G NR和6G候选物理层链路的快速仿真,包括OFDM波形生成、信道模型(如TDL/CDL)、DMRS图样配置和神经接收机训练。它提供可微分的端到端链路,便于将接收机作为神经网络训练。论文用Sionna生成OFDM仿真数据,保证了信道与信号模型的标准化和可复现性。
DeepRx接收机
DeepRx是诺基亚贝尔实验室提出的基于CNN的神经接收机,将接收到的资源网格(含DMRS)直接映射为编码比特的对数似然比(LLR),以端到端方式训练。它依赖卷积层在局部时频邻域内提取特征,在密集导频下表现优异,但在稀疏导频下因感受野有限而难以充分利用远处导频信息,这正是PARGAR的对比出发点。
对神经接收机设计的启示
PARGAR的意义不止于一个接收机模型。它提出了一个更一般的问题:神经接收机的结构设计,是否应该与参考信号的物理布局对齐?CNN的局部性假设在密集导频下天然吻合,但在稀疏导频下就出现了错配。图结构则提供了一种灵活的载体,把"哪些信息该被直接连接"这件事从学习过程里拿出来,变成显式的结构设计。
从工程视角看,信道缩放锚点规则也意味着图结构本身可以随信道条件自适应调整,这为未来在6G系统中按需配置导频密度、同时保持接收可靠性提供了一条思路。当然,从仿真到实际部署还有距离:计算复杂度、图构建开销、以及在MIMO与编码场景下的表现,都是后续需要回答的问题。
论文目前给出的证据集中在SISO未编码仿真层面,属于方法验证阶段的成果。对于关注AI原生空口与神经接收机方向的研究者和工程师而言,它提供了一个值得跟踪的结构性思路:与其让网络去学导频在哪,不如把导频关系直接画进图里。
背景补充
DMRS与OFDM资源网格
DMRS(解调参考信号)是5G NR中用于物理下行共享信道(PDSCH)和物理上行共享信道(PUSCH)解调的导频信号,接收机利用它估计信道频率响应,再对数据符号进行相干检测。OFDM资源网格是时频二维平面:横轴为OFDM符号(时间),纵轴为子载波(频率),每个交叉点为一个资源单元(RE)。DMRS按特定图样(如单符号或双符号)映射到部分RE上,其余RE承载数据。导频密度指DMRS RE在网格中所占比例,密度越高信道估计越准,但数据RE越少,频谱效率越低。
CNN感受野与局部性
卷积神经网络(CNN)的每个神经元只响应输入的一个局部邻域,该邻域大小称为感受野。在神经接收机中,CNN以资源网格的局部时频块为输入,通过多层卷积逐步扩大感受野。但感受野扩大是间接且有限的:当导频稀疏时,远处导频的信息需经过多层传递才能影响数据RE的检测,信号在传播中被非线性变换稀释。这就是论文所指“局部处理与稀疏导频的结构性错配”。
图注意力机制(GAT)
图注意力网络(Graph Attention Network, GAT)将注意力机制引入图神经网络:每个节点通过注意力权重聚合邻居节点的特征,权重由节点对之间的特征相似度动态计算。与固定权重的图卷积不同,GAT能自适应地决定哪些邻居信息更重要。PARGAR将每个RE视为图节点,节点特征包含接收信号、导频位置指示等;局部时频边和导频锚点链接共同定义邻接关系,图注意力层据此聚合信息并输出比特似然比用于检测。
相干时间与相干带宽
相干时间指信道冲激响应在时域上保持近似不变的时间跨度,近似为 ( T_c \approx 1/f_d )(( f_d ) 为最大多普勒频移);相干带宽指信道频率响应在频域上保持强相关的带宽,近似为 ( B_c \approx 1/\tau_{max} )(( \tau_{max} ) 为最大时延扩展)。二者共同刻画信道在时频平面上的“相关区域”。信道缩放导频锚点规则正是利用这一物理量:在相干时间与相干带宽划定的范围内建立数据RE到导频RE的锚点链接,确保所连导频对当前数据位置具有信道参考价值,避免连接信道不相关的远处导频。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。