PAWS数据集:政策驱动的金融多智能体世界仿真
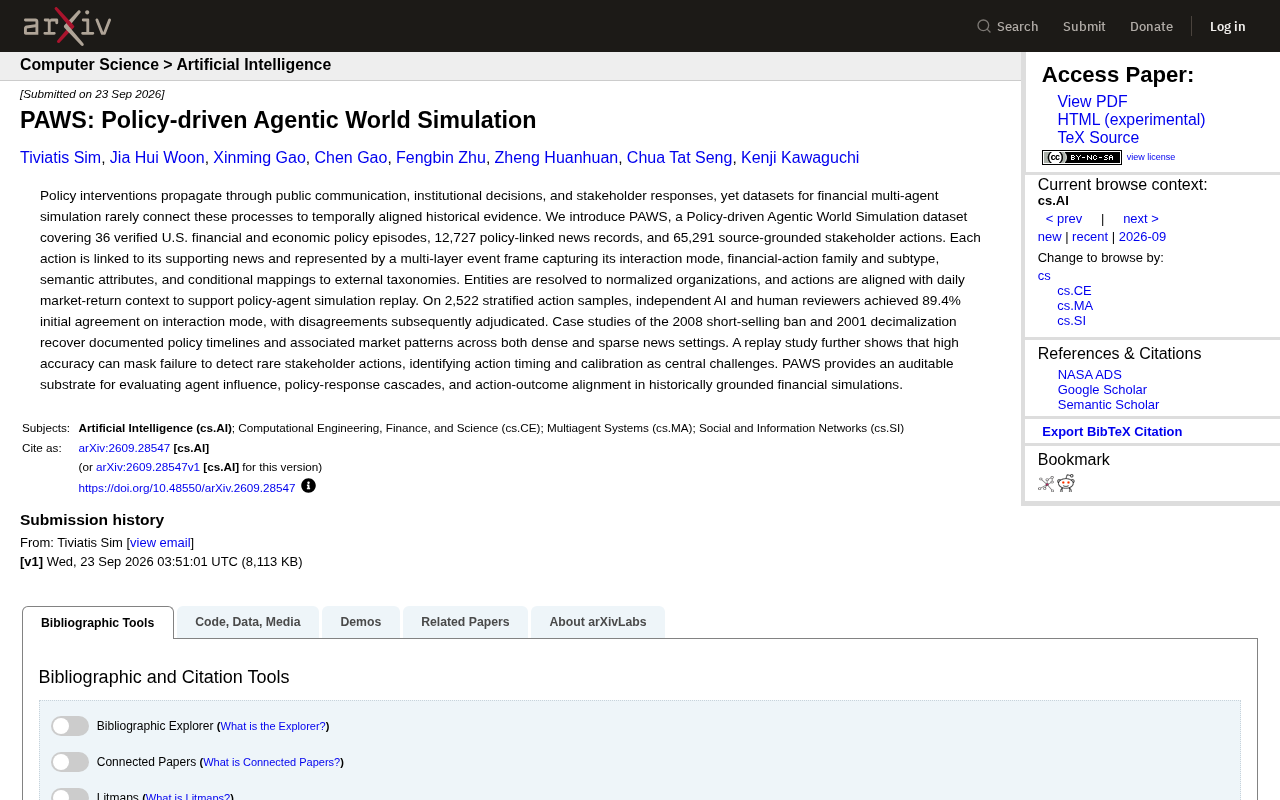
PAWS构建了首个将金融政策事件、新闻证据链与市场数据三者绑定的可审计多智能体仿真数据集。
PAWS(政策驱动的智能体世界仿真)是一个专为金融政策仿真设计的可审计数据集,涵盖36个美国金融政策事件、12,727条政策新闻及65,291个有来源支撑的利益相关方行为。每项行为均通过多层事件框架从交互模式、行为分类、语义属性和外部分类映射四个维度结构化表达,并与每日市场回报数据对齐。AI与人类审查者在标注一致率上达到89.4%,保障了数据可信度。以2008年卖空禁令和2001年小数化改革为案例,PAWS验证了在新闻信息稀疏与密集两种场景下的政策时间线还原能力。研究同时揭示了一个方法论隐患:高整体准确率会系统性掩盖模型对罕见但关键行为的检测失败,指出行为时间把握与概率校准才是政策仿真的真正核心挑战。
让政策模拟有据可查
政策干预从来不是孤立的决策,它会通过公共传播、机构决策和利益相关方的连锁反应层层扩散。然而在金融多智能体仿真领域,长期存在一个短板:现有数据集很少把这些传播过程与时间对齐的历史证据真正连接起来。研究者往往只能依赖合成数据或缺乏溯源的模拟环境,导致仿真结果难以验证。
PAWS(Policy-driven Agentic World Simulation)正是针对这一痛点提出的解决方案。它构建了一个可审计、有历史依据的数据基础,专门用于评估智能体的影响力、政策响应级联以及行为与结果之间的对齐关系。
数据集规模与结构
PAWS覆盖了36个经过核实的美国金融与经济政策事件,关联了12,727条政策相关新闻记录,以及65,291个有来源支撑的利益相关方行为。数据规模上的一大特点是——每一个行为都被链接到支撑它的新闻证据,而不是凭空生成。
更值得关注的是其对行为的结构化表达方式。每个行为都通过一个**多层事件框架(multi-layer event frame)**来刻画,捕捉四个维度:
- 交互模式(interaction mode):描述行为主体如何互动
- 金融行为家族与子类型:对行为进行分类归属
- 语义属性:行为的具体含义特征
- 条件映射:与外部分类体系(taxonomies)的对应关系
此外,数据集还对实体进行了规范化解析,将各类主体归一到标准化的组织实体,并将行为与每日市场回报的上下文对齐,从而支持真正意义上的"政策—智能体"仿真回放(replay)。
标注质量:AI与人类的双重把关
对于一个声称"可审计"的数据集,标注质量是信誉的核心。PAWS在2,522个分层抽样的行为样本上进行了验证:独立的AI审查者与人类审查者在交互模式的判定上达成了89.4%的初始一致率,对于存在分歧的部分则进一步通过仲裁流程解决。
这种双轨验证机制既利用了AI标注的规模化能力,又保留了人类判断的质量兜底,为数据集的可靠性提供了实证支撑。近90%的初始一致率在这类需要语义理解的标注任务中属于较高水平。
两个案例:从历史事件中还原政策时间线
PAWS通过两个经典金融事件验证了其还原能力。
第一个是2008年卖空禁令(short-selling ban),这是金融危机期间监管层的重要干预措施;第二个是2001年股价小数化改革(decimalization),即美股报价从分数制转向小数制的市场结构变革。
研究显示,PAWS能够在这两个案例中重建出有据可查的政策时间线以及相应的市场模式,而且在新闻信息密集和稀疏两种不同场景下都能实现——这一点尤为关键,因为现实中许多政策事件的媒体覆盖并不均衡,稀疏场景下的还原能力更能体现数据集的稳健性。
2008年卖空禁令是金融危机期间美国证券交易委员会(SEC)于2008年9月发布的紧急禁令,明确禁止对约800家金融类股票进行裸卖空操作,持续约三周。其背景是雷曼兄弟破产引发的市场恐慌,监管层意图阻止做空力量加速股价崩跌。然而,学术研究对这一干预的实际效果颇有争议——多项研究发现禁令不仅未能稳定股价,反而降低了市场流动性,推高了买卖价差。这使得该事件成为研究"监管意图与市场结果背离"的经典样本,也是测试政策仿真系统能否还原复杂反馈机制的理想案例。
2001年股价小数化改革则是美国各主要交易所将股票报价最小单位从1/16美元(约6.25美分)统一切换为0.01美元的结构性变革,目的是与国际市场接轨并降低散户交易成本。这一改革的直接后果是买卖价差大幅收窄,但也催生了高频交易策略的兴起,深刻改变了市场微观结构。两个事件横跨不同的政策类型(危机应对 vs. 结构改革),在新闻报道密度和市场影响路径上也差异显著,构成了对PAWS还原能力的压力测试。
高准确率背后的隐患:罕见行为的检测
PAWS的一项回放研究揭示了一个容易被忽视的问题:高准确率可能掩盖模型对罕见利益相关方行为的检测失败。
换句话说,当大多数行为都属于常见类型时,整体准确率指标会显得很漂亮,但那些出现频率低、却往往具有关键影响力的稀有行为可能被系统性地遗漏。研究据此指出,行为的时间点把握(action timing)与校准(calibration) 才是政策智能体仿真真正的核心挑战。
这一发现对整个领域具有方法论意义:单纯追求聚合准确率并不足以评估仿真系统的真实能力,评估框架必须能够暴露对长尾行为的处理短板。
这一问题在机器学习中被称为**类别不平衡(class imbalance)**问题,是分类系统的常见陷阱。当某类事件在数据集中占比极低时,模型倾向于忽略它以换取整体准确率的提升——即便该类事件在现实意义上举足轻重。在政策仿真语境中,"罕见利益相关方行为"往往对应的恰恰是非常规的市场干预、突发性的监管表态或极端情绪下的机构操作,这些行为虽属例外,却可能是触发系统性风险的关键节点。**校准(calibration)**在此指模型输出的概率置信度是否与真实发生频率相符——一个校准良好的系统不仅要知道"发生了什么",还要准确估计"以多大概率发生"。行为时间点的准确把握(timing)则涉及政策信号的传播延迟与市场反应窗口,这在高频事件中尤为敏感。
意义与展望
PAWS的价值不仅在于其数据规模,更在于它提供了一个可审计的基础底座(auditable substrate)。研究者可以基于历史真实数据,去评估智能体在政策传导链条中的影响力、政策响应如何级联扩散,以及行为与最终市场结果的对齐程度。
在大语言模型驱动的智能体(agent)研究快速升温的当下,如何让多智能体仿真摆脱"自说自话"、真正锚定现实世界,是一个悬而未决的问题。PAWS将金融政策场景、新闻证据链和市场数据三者绑定,为构建可信、可复现的政策仿真研究提供了一条务实的路径。
相关推荐
Gemini 4 维护 Chromium:两周完成数月代码量
开发者利用 Gemini 4 Argon 维护 Chromium 代码库,两周完成过去数月工作。AI 代理同时发起 20 个变更,全部通过数十万次测试,突破大型代码库的维护瓶颈。
Codex保姆级攻略:从安装到实战,一期精通AI桌面助手
基于B站热门教程,详解Codex从安装到实战的完整流程:与豆包的本质区别、项目概念、文件整理与仪表板生成两大实战案例,以及计划模式和桌面宠物等特色功能,帮你快速上手这款能直接操作电脑的AI助手。
EduRAG智慧问答系统:黑马AI智能体项目实战解析
黑马EduRAG智慧问答系统实战课程解析:涵盖LangChain、Milvus向量数据库、混合检索与重排序,解决IT领域事实性幻觉,附就业行情与学习路径。