Perplexity文件处理能力退化:Pro用户实测问题全解析
从惊艳到失望:一位重度用户的真实反馈
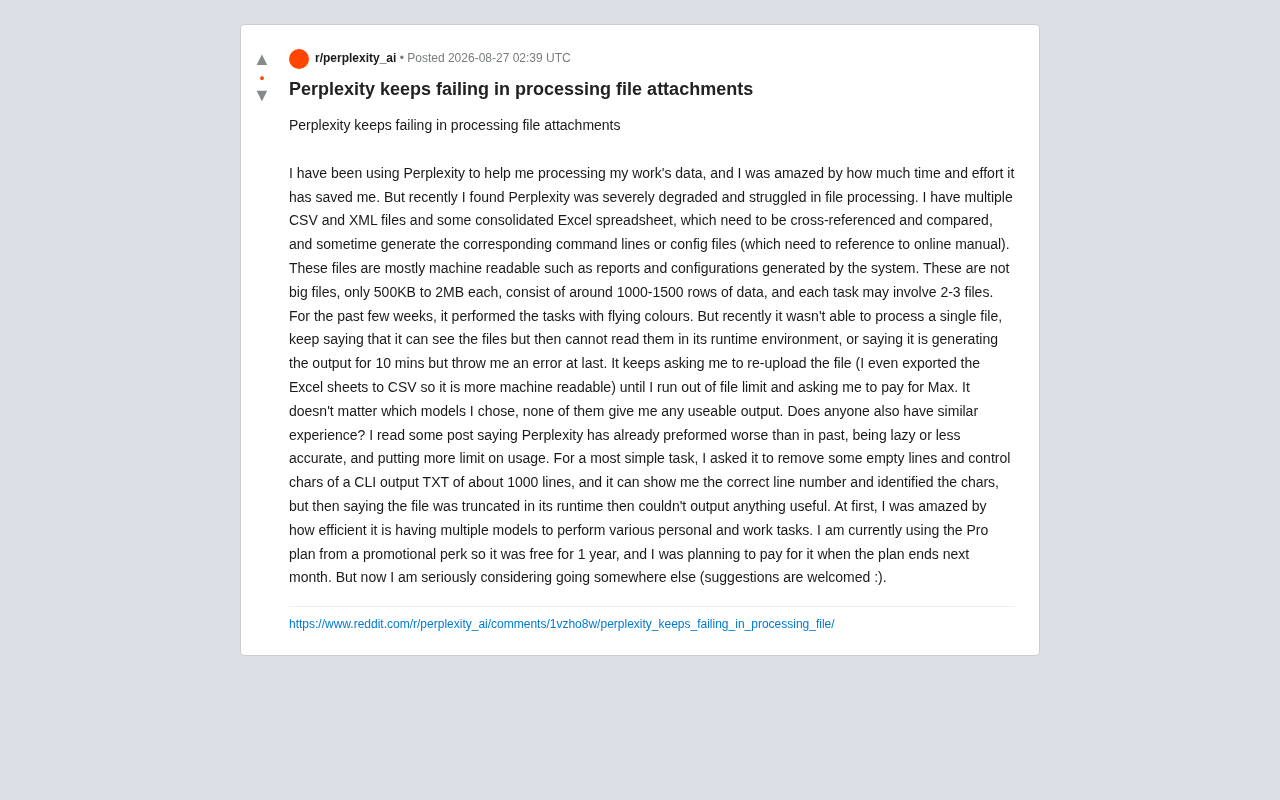
近期,一位Perplexity的Pro用户在Reddit上分享了他从赞叹到失望的完整心路历程,引发了不少共鸣。这位用户长期使用Perplexity处理工作数据,涵盖CSV、XML以及整合过的Excel表格,用于交叉引用、数据比对,甚至生成对应的命令行与配置文件(需要参考在线手册)。
值得一提的是,这几种文件格式在机器可读性上存在显著差异。Excel文件(.xlsx)本质上是一个ZIP压缩包,内含多个XML文件、样式表和元数据,解析它需要专门的库(如Python的openpyxl或Java的Apache POI)。更早期的.xls格式则采用微软专有的二进制OLE2复合文档结构,解析难度更高。即便是现代的.xlsx格式,其内部也包含了共享字符串表(shared strings table)、单元格样式映射、合并单元格信息等复杂结构——这些对人类用户透明的功能,对AI的文件解析管线来说都是额外的处理负担。CSV(逗号分隔值)则是纯文本格式,任何程序都能直接读取,理论上对AI处理管线更友好。不过CSV也并非完全"无陷阱":文件可能包含BOM(字节顺序标记)头导致首列读取异常,分隔符可能是逗号、制表符或分号(不同地区的Excel导出默认值不同),字段内嵌的换行符和引号转义也经常引发解析错误。XML虽然也是纯文本,但其嵌套标签结构需要专门的解析器处理,且存在DOM(将整个文档加载到内存的树结构)和SAX(基于事件的流式解析)两种截然不同的解析模式——前者内存占用大但操作灵活,后者内存效率高但编程复杂度显著增加。这些格式差异在后续的故障排查中将成为重要线索。
他所处理的文件并不复杂:单个文件仅500KB到2MB,约1000到1500行数据,每次任务通常涉及2到3个文件。这些都是系统生成的机器可读报告与配置文件。用户直言,在过去的几周里,Perplexity表现得"出类拔萃",为他节省了大量时间与精力。
然而,转折突然到来。最近,Perplexity几乎无法处理任何一个文件,问题令人费解。
核心问题:能"看到"文件却无法"读取"
用户描述的故障模式相当典型,也格外令人抓狂:
- 可见但不可读:Perplexity声称能看到上传的文件,但随即表示无法在其运行时环境(runtime environment)中读取它们。
- 假性处理:有时它会显示"正在生成输出"长达10分钟,最终却抛出一个错误。
- 反复要求重传:模型不断要求用户重新上传文件,直到用户耗尽文件配额,然后被提示付费升级到Max套餐。
这里需要解释一下"运行时环境"这个概念。运行时环境是指程序实际执行时所依赖的软件和硬件资源的集合,包括操作系统、内存分配、文件系统访问权限等。在AI产品中,当用户上传文件并要求模型进行处理时,模型本身并不直接操作文件——它需要调用后端的代码执行沙箱(sandbox)来完成实际的读写操作。
沙箱是一种隔离的计算环境,旨在防止用户上传的恶意代码影响主系统,但同时也对可用资源(如内存、CPU时间、磁盘空间)施加了严格限制。现代AI产品的沙箱通常基于容器化技术(如Docker)或更轻量的虚拟化方案(如Google的gVisor)实现。每个用户会话被分配一个独立的容器实例,该实例拥有预设的资源上限——例如256MB到1GB的内存、有限的CPU时间片、以及临时性的磁盘空间。容器在会话结束后通常会被销毁,这意味着文件不会跨会话持久化。当并发用户数激增时,平台可能降低单个容器的资源配额以维持整体服务可用性,这就可能导致原本正常的文件处理任务突然失败。更微妙的是,沙箱环境中预装的软件库版本可能在平台更新时发生变化,导致原本兼容的文件格式突然无法解析。
当沙箱资源不足或配置出错时,就可能出现文章中描述的"能看到文件却无法读取"的现象——模型的语言理解层能够解析文件元数据(如文件名、大小、格式标识),但执行层却无法在受限环境中完成实际的文件I/O操作。这种"认知-执行分离"的故障模式在分布式系统中并不罕见:前端的文件上传服务将文件暂存到对象存储(如AWS S3),模型的语言层可以访问文件元数据,但后端的代码执行沙箱在尝试从存储中拉取文件内容时可能因为网络超时、权限配置错误或存储路径不一致而失败。
为了排除文件格式的问题,这位用户甚至专门把Excel表格导出为更"机器友好"的CSV格式,但依然无济于事。这一排查步骤是合理的——排除了格式兼容性问题后,故障更可能定位在平台的文件传递管线或资源分配上,而非文件格式本身。更关键的是,无论切换哪个底层模型,结果都一样——没有一个能给出可用的输出。
理解这一现象需要了解Perplexity的独特架构。与ChatGPT、Claude等产品不同,Perplexity本身并不训练自己的基础大语言模型,而是作为一个智能路由层,整合了来自OpenAI、Anthropic、Meta等公司的多个模型(如GPT-4o、Claude 3.5 Sonnet、Llama 3.1等),并叠加实时网络搜索能力。用户可以在Pro版本中切换不同的底层模型。
这种架构在软件工程中被称为"聚合器模式"(aggregator pattern),其核心价值在于将多个异构服务统一在一个标准化的接口之后。Perplexity在此基础上增加了"提示词适配层"——由于不同模型对系统提示词(system prompt)的响应特性不同,Perplexity需要为每个模型维护专门的提示词模板,确保用户的自然语言指令被翻译为各模型最擅长处理的格式。在文件处理场景中,这意味着上传的文件需要经过一条复杂的管线:文件上传 → 临时存储 → 格式检测与预处理 → 内容提取与token化 → 提示词组装 → 模型路由与调用 → 输出解析与格式化。这条管线中的每一个环节都是潜在的故障点,而且不同模型对文件内容的接收方式可能不同(有些通过API的文件参数,有些需要将内容内联到提示词中),这进一步增加了兼容性维护的难度。
"无论切换哪个底层模型结果都一样"这一现象,恰恰说明问题出在Perplexity自身的文件处理层——即上述管线中模型路由之前的环节——而非某个特定模型的能力缺陷。
一个最简单的任务也翻车
最能说明问题的是一个极其简单的案例:用户要求Perplexity从一份约1000行的CLI输出TXT文件中删除空行和控制字符。模型能够正确显示行号、准确识别出需要处理的字符,但随后却声称"文件在运行时环境中被截断",最终无法输出任何有价值的内容。
这个案例耐人寻味:模型的理解与识别能力显然是正常的,问题出在执行环节的文件读取与处理管线上。这暗示故障可能并非模型智能本身的退化,而是Perplexity在代码执行沙箱、文件传递或运行时资源分配上出现了系统性问题。
这里值得深入讨论"文件被截断"这一现象背后的技术逻辑。大语言模型的上下文窗口(context window)决定了它一次能处理的最大token数量,当前主流模型的上下文窗口从数千到数十万token不等(例如GPT-4 Turbo支持128K token,Claude 3.5支持200K token,Gemini 1.5 Pro甚至宣称支持100万token)。
然而,更大的上下文窗口意味着更高的计算成本——这背后涉及transformer架构的核心瓶颈。标准的自注意力机制(self-attention)计算复杂度为O(n²),其中n是输入序列的长度(以token计)。这意味着当输入长度翻倍时,注意力计算的开销会增长四倍。虽然近年来出现了诸如FlashAttention、稀疏注意力(sparse attention)、滑动窗口注意力(sliding window attention)等优化技术来缓解这一问题,但推理成本仍然与输入长度密切相关。此外,推理过程中每个token都需要维护一份KV缓存(Key-Value cache),用于存储已处理token的注意力键值对,避免重复计算。这份缓存的显存占用与序列长度和模型层数成正比——对于一个拥有上百层的大模型来说,处理一个128K token的长文本可能需要额外消耗数GB的GPU显存。
因此,服务商常常在实际部署中对输入进行截断或压缩以控制成本。具体手段包括:设定低于模型理论上限的实际上下文窗口;对超长输入进行自动摘要或分块处理(chunking);或者直接丢弃超出预设长度的内容。用户的1000-1500行文件在token数量上可能仅占几千到一万多个token,理论上远未触及模型的上下文上限,但平台层面出于成本考量主动施加的软限制——特别是在促销套餐用户身上——可能才是"截断"的真正原因。这种软限制通常不会在产品文档中明确说明,用户只能通过不断试错来感知它的存在。
这是个例还是普遍趋势?
你可能没注意到,这位用户并非孤例。他提到自己读到过其他帖子,反映Perplexity的表现"大不如前"——变得"懒惰"、准确性下降,并对使用量施加了更多限制。
这类"模型变懒"的抱怨在AI社区并不新鲜。ChatGPT、Claude等主流产品都曾在不同时期遭遇类似的用户质疑。"模型变懒"(model laziness)作为一个现象,最早在2023年末因ChatGPT用户的大规模投诉而引起广泛关注。用户普遍反映模型的回答变得更短、更敷衍、更倾向于给出概括性建议而非详细执行。
对此存在多种解释。首先是静默降级(silent downgrade)的可能性:服务商可能在后台切换到了更小、更便宜的模型版本以降低成本。这种做法并非空穴来风——2023年有独立研究者通过对比不同时间段GPT-4在标准化数学测试和编程基准上的表现,发现模型性能确实存在可测量的波动。社区随后发展出了一系列非官方的"模型质量追踪"方法,包括定期运行固定的基准测试提示词(benchmark prompts)并记录输出变化、通过API返回的模型标识符和响应延迟推断实际调用的模型版本、以及利用Chatbot Arena等第三方评测平台进行众包评估。尽管这些方法各有局限,但它们共同构成了一种草根式的质量监督机制。
其次,系统提示词的调整可能引导模型生成更简短的回复以节省token。系统提示词是用户不可见的、由服务商预设的指令,它们在很大程度上塑造了模型的行为特征。一条简单的系统提示词变化——比如从"请提供详细的分步解答"改为"请简洁回答"——就可能显著改变模型的输出风格和长度。第三,A/B测试中的参数调优可能无意中影响了输出质量。服务商持续对模型的温度(temperature)、top-p等推理参数进行微调,以优化延迟、成本或安全性指标,这些调整可能在改善某些维度的同时无意中降低了其他维度的表现。
OpenAI曾在2023年12月公开回应称GPT-4并未被故意"降级",但承认模型行为可能因多种因素而波动。这种透明度的缺失加剧了用户的不信任感——用户无法区分"平台故意降级"和"技术波动",而服务商也缺乏动力去建立可独立验证的质量保证机制。
背后可能的原因包括:
- 成本控制与降级:为控制推理成本,服务商可能对免费或促销用户悄然限制算力、缩短上下文窗口或截断输入文件。推理成本是AI服务商面临的核心财务挑战——每一次模型调用都消耗昂贵的GPU算力(一块NVIDIA H100 GPU的市价超过3万美元,而一个大型模型的单次推理可能需要多块GPU协同工作),而大量用户的并发请求使得成本压力倍增。据行业估算,GPT-4级别模型的单次对话推理成本在几美分到几十美分不等,而用户付费往往以月度固定费用(如Perplexity Pro的20美元/月)计算。当用户使用量超出服务商的成本预期时,实施差异化的资源分配——如为促销用户设定更低的每日调用上限或更严格的文件大小限制——几乎是一种必然的商业选择。
- 运行时环境不稳定:代码执行、文件解析等功能依赖后端沙箱环境,一旦资源紧张或版本更新出现bug,就会出现"能看见读不到"的怪象。值得注意的是,平台通常会进行滚动更新(rolling update),即在不中断服务的情况下逐步替换后端实例。这种更新策略虽然避免了全局停机,但可能导致同一时间段内不同用户命中不同版本的后端,从而产生"时好时坏"的不一致体验。
- 配额策略调整:文中提到的"耗尽文件配额后引导付费Max",也让人怀疑限制收紧与商业化推动之间的关联。这种"功能锁定 → 付费解锁"的漏斗策略在SaaS行业非常常见,但当它被应用于原本正常工作的功能时——即用户感知到的是"功能退化"而非"功能未解锁"——就会引发强烈的负面反应。
需要客观指出,这些均为用户侧的推测,官方并未确认。但当"文件被截断""运行时无法读取"这类反馈反复出现时,指向后端处理管线问题的可能性确实较高。
对AI工具用户的启示
这位用户目前使用的是为期一年的免费Pro促销套餐,原本计划在下月到期后付费续订。但如今,他开始"认真考虑另寻他处"。这个转变对整个行业都有警示意义。
稳定性是生产力工具的生命线
对于把AI用于实际工作流的用户而言,惊艳的峰值能力远不如稳定可靠的下限重要。当一个工具能在几周内完成复杂任务、又在下一周连删空行都做不到时,这种不可预测性会直接摧毁用户的信任——而信任正是付费转化的前提。
这一点对于AI产品的产品经理和运营团队尤为关键:用户对生产力工具的核心期待不是"有时很惊艳",而是"始终靠得住"。传统软件行业用SLA(服务等级协议,Service Level Agreement)来量化可靠性承诺——例如AWS承诺其S3存储服务99.99%的月度可用性,若未达标则按比例退款。但SLA的概念在AI产品中面临根本性挑战:传统SLA衡量的是"服务是否在线",而AI产品的核心问题是"输出质量是否达标"。一个AI工具可能100%在线运行,却在50%的时间里给出低质量或错误的回答。如何定义和衡量"AI输出质量的SLA"?是按准确率、完整度、还是用户满意度?这些指标的主观性和场景依赖性使得标准化极为困难。目前,一些企业级AI服务商(如Anthropic的Claude for Enterprise)已开始在合同中纳入响应延迟、吞吐量等可量化指标的SLA条款,但对输出质量的承诺仍然停留在模糊的"最佳努力"(best effort)层面。这一领域的标准化还远未成熟,而用户的信任恰恰建立在这些尚不存在的保障之上。
多工具备份策略
对重度依赖AI处理数据的专业用户,建议不要把鸡蛋放在一个篮子里。针对文件处理、数据比对这类任务,可以考虑:
- 使用支持稳定代码执行环境的工具(如ChatGPT的Code Interpreter/数据分析功能、Claude的Projects等)。ChatGPT的Code Interpreter(现已更名为"高级数据分析")在OpenAI的云端沙箱中运行Python代码,用户可以上传文件并通过自然语言指令驱动数据处理。其沙箱基于Kubernetes容器编排,每个会话分配一个独立的Python运行时,预装了pandas、matplotlib、numpy等常用数据科学库。优势是用户无需编程知识即可完成复杂数据操作,但同样受限于沙箱的资源配额(通常有内存上限和执行时间限制)和会话时长(长时间不活动后容器会被回收,已上传的文件随之丢失)。Claude的Projects功能则采用了不同的策略——它更侧重于将文件作为持久化的知识库附加到对话中,而非在沙箱中执行代码处理文件。
- 对结构化数据处理,本地脚本(Python + pandas)配合AI辅助编写代码,往往比让AI直接"吞"整个文件更可靠。 本地脚本完全在用户自己的机器上运行,不受任何云端限制,处理速度更快、结果更可控。pandas是Python生态中最流行的数据处理库,能够高效处理百万行级别的表格数据,支持CSV、Excel、JSON、SQL数据库等几乎所有常见数据源。对于文章中描述的1000-1500行文件,pandas可以在毫秒级完成处理,而且结果完全确定性——同样的代码、同样的输入,永远产生同样的输出,不会像AI那样出现随机波动。一个折中方案是让AI辅助编写本地脚本——用户用自然语言描述需求("读取这个CSV文件,删除空行,去除控制字符,输出为新文件"),AI生成对应的Python代码,用户在本地Python环境中执行。这种方式将AI的自然语言理解能力与本地环境的稳定性结合起来,是目前专业用户中越来越流行的工作模式。它还有一个额外好处:生成的脚本可以被保存、版本控制、复用和修改,形成用户自己的工具库,而不是每次都依赖AI从零开始。
- 保留原始数据与处理日志,便于在工具出问题时快速切换。 这是数据工程领域的基本原则——永远不要用处理后的数据覆盖原始数据。建立一个简单的处理日志(记录"何时、用什么工具、以什么参数、对什么文件、做了什么操作、得到什么结果"),可以在工具迁移时大幅减少重复劳动。
结语
这起用户反馈本质上是一面镜子,映照出当下AI产品普遍面临的矛盾:商业化压力下的资源收紧,与用户对稳定生产力的期待之间的张力。Perplexity凭借"多模型 + 联网检索"的定位曾赢得大量口碑,但如果核心的文件处理能力不能保持稳定,再华丽的功能也难以留住真正的付费用户。
这种矛盾在当前AI行业的资本环境下尤为尖锐。大多数AI初创公司——包括Perplexity——仍处于烧钱换增长的阶段,依靠风险投资补贴用户获取成本。Perplexity在2024年的估值已突破数十亿美元,但其商业模式能否在订阅收入层面实现自我造血,仍是未知数。在这种背景下,促销用户与付费用户之间的资源分配博弈,以及短期增长指标与长期用户留存之间的取舍,将持续塑造产品体验的走向。
对于正在评估AI工具的读者,这个案例的价值在于提醒:在为长期订阅付费之前,务必用自己真实的工作负载进行压力测试,验证其稳定性下限,而非仅被峰值表现打动。具体建议包括:连续多天在不同时段测试同一任务(排除高峰期资源竞争的影响)、使用接近实际工作中最大文件体量的测试数据、以及记录每次测试的成功率和响应时间。AI产品正在从"尝鲜玩具"向"生产力基础设施"过渡,而这一过渡能否成功,最终取决于服务商能否在商业可持续性与用户体验之间找到真正的平衡点。
相关推荐
AI Agent开发四阶段学习路线:从入门到企业级实战
AI Agent开发零基础学习路线全解析:从核心概念、ReAct范式,到多智能体协作、Prompt调优与企业级实战项目,系统掌握规划、记忆、工具调用、RAG与MCP,帮你少走弯路成为AI核心人才。
DeepSeek Harness 新玩法:Agent 监督 Agent 的自进化实验
一位 B 站 UP 主基于 DeepSeek Harness 实现「Agent 监督 Agent」的自进化实验:用官方原版 DSH 作稳定监督者,驱动自研 Agent 完成任务并自动修复 bug,配合台账机制和 CDP、Chrome DevTools MCP 实现近乎无人值守的软件迭代。
用DeepSeek+3款工具,5分钟生成专业PPT
手把手教你用DeepSeek生成PPT大纲,再通过通义、Kimi、扣子三款免费AI工具一键生成专业PPT,5分钟搞定演示文稿,附完整实操步骤。