PilotDeck:解决多任务Agent管理混乱的本地控制台

当你开始认真用 Agent 干活,而不只是偶尔问几句话时,一个被忽视的问题会迅速浮出水面——多任务管理的混乱。一个项目让它改代码,一个让它跑调研,一个让它整理文档,聊几十轮之后再问它"刚才那个项目做到哪了",它经常说不清楚。PilotDeck 正是为了解决这个问题而生的本地 Agent 控制台。
项目背景:清华系团队出品
PilotDeck 是一个非常新的开源项目,README 标注的开源时间是 2025 年 5 月 28 日,目前已在 GitHub 上获得约 2.8K Star。需要先明确的是,它不是一个 Skill 插件,也不是提示词包,而是一个可以安装到本机运行的完整软件,启动后提供 Web 界面,支持管理工作区、任务、记忆、模型配置,还能追踪每个任务的 Token 消耗。
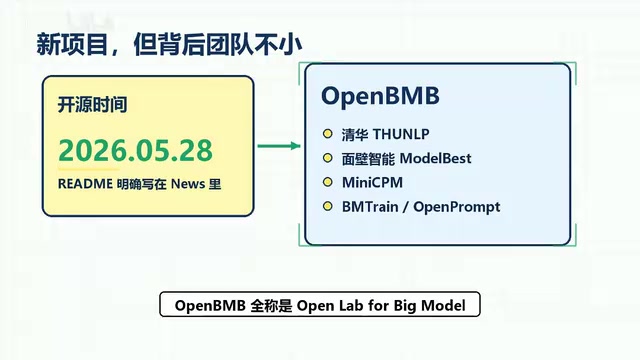
背后的 OpenBNB(Open Lab for Big Model Base)有不小的来头,由清华大学自然语言处理实验室和面壁智能联合发起,MiniCPM、BMTrain、OpenPrompt 等知名项目都与这个团队有关。清华大学自然语言处理实验室(THUNLP)是国内 NLP 领域最具影响力的研究团队之一,由孙茂松教授创立,刘知远教授等人领衔,长期在 ACL、EMNLP、NeurIPS 等顶级会议上保持高产出。面壁智能(ModelBest)则是该实验室的产业化载体,专注于高效大模型的研发与部署。他们推出的 MiniCPM 系列是国内端侧小模型的代表作,以 2B-4B 级别的极小参数量在多项基准测试中实现了接近 7B 甚至 13B 模型的性能,核心技术包括模型蒸馏、量化部署和高效注意力机制;BMTrain(Big Model Training)是面向大模型训练的高效分布式框架,通过 ZeRO 优化、混合精度训练等技术大幅降低了训练门槛;OpenPrompt 则是提示学习(Prompt Learning)领域的标准工具库,将 Prompt Tuning、P-Tuning 等多种范式统一到一个框架中,被学术界广泛引用。这个团队的特点是既有顶级学术产出,又有扎实的工程落地能力,PilotDeck 可以看作他们从"模型研发"向"Agent 工程化"延伸的一步棋——当模型本身的能力已经足够强时,如何让模型在实际工作流中被高效管理和调度,就成了下一个关键瓶颈。这意味着 PilotDeck 不是某个人随手写个 Prompt 然后包装成工具的产物,而是有扎实工程背景的团队在认真解决 Agent 工程化落地中的实际痛点。
核心解决的三个痛点
痛点一:项目容易串——用 Workspace 隔离上下文
在普通聊天框里,需求、文件、记忆、失败记录全都堆在一条对话里。聊久了之后,你自己都不一定记得前面说过什么,更别说 Agent 了。这是当前所有对话式 AI 工具的通病:上下文窗口是有限的,但项目的复杂度是无限的。
这里需要理解一个技术背景:当前主流大语言模型的上下文窗口从 4K 到 200K Token 不等(如 Claude 支持 200K,GPT-4o 支持 128K,Gemini 1.5 Pro 甚至支持 1M),但即便窗口再大,也无法无限扩展——因为 Transformer 架构的自注意力(Self-Attention)机制在标准实现中,计算复杂度与序列长度呈二次方关系(O(n²)),这意味着窗口长度每翻一倍,计算量就增加四倍,推理延迟和 API 成本也随之飙升。虽然 FlashAttention、Ring Attention 等技术在工程层面做了大量优化,但二次方的根本瓶颈并未消除。更关键的是,2023 年斯坦福大学的研究论文《Lost in the Middle》揭示了一个重要现象:当关键信息被放置在超长上下文的中间位置时,模型的检索准确率会显著下降,有时甚至不如只提供少量相关信息。这意味着"把所有东西都塞进上下文窗口"并不是一个可靠的策略。这就是为什么单纯加大窗口并不能真正解决多项目管理问题,而需要在架构层面做上下文隔离和外部记忆管理——让每个项目只加载自己需要的信息,而不是让模型在一锅粥里大海捞针。
PilotDeck 的解决方案是引入 Workspace(工作区) 概念。A 项目有 A 项目的文件和记忆,B 项目有 B 项目的文件和记忆,彼此完全隔离。当你在不同任务之间切换时,不需要每次都重新交代背景,Agent 能直接在对应工作区的上下文中继续工作。这个设计借鉴了软件开发中"命名空间"(Namespace)和"沙箱"(Sandbox)的隔离思想——就像 Docker 容器让不同应用互不干扰一样,Workspace 让不同项目的上下文互不污染。这个设计看似简单,但对于同时推进多个项目的重度用户来说,是真正的刚需。
痛点二:记忆不可查——白盒化记忆管理
当 Agent 判断错了,你不能只看最后一句回答就完事。你需要知道它为什么这么判断——是哪条记忆影响了它?哪段上下文把它带偏了?这在传统的聊天界面里几乎无法追溯。
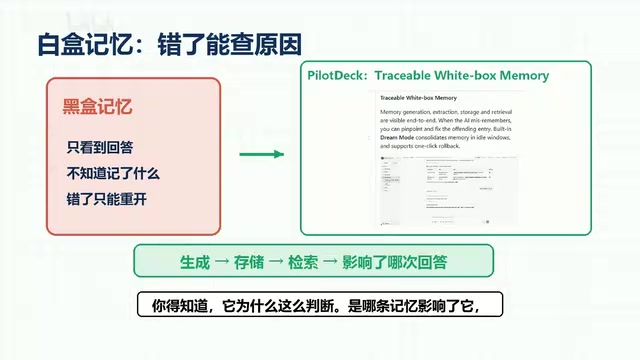
PilotDeck 将记忆系统做成了白盒设计:记忆怎么生成、怎么存进去、怎么被检索取出来,全部可视可查。这里的"白盒"与"黑盒"对比,涉及软件工程和 AI 可解释性(Explainable AI, XAI)领域的核心概念。黑盒系统指用户只能看到输入和输出,内部运作机制不可见——这正是当前大多数 AI 聊天工具的状态,你输入一个问题,得到一个回答,但完全不知道模型调用了哪些记忆、做了几步推理、在哪个环节做出了关键决策。白盒系统则意味着内部状态、决策路径、数据流转全部透明可审计。在传统软件开发中,日志系统(Logging)、调试工具(Debugger)、分布式链路追踪(如 OpenTelemetry、Jaeger)都是白盒化的标准手段,它们让开发者能够在系统出问题时快速定位根因。PilotDeck 将这一理念引入 Agent 领域,本质上是在构建 Agent 的"可观测性"(Observability)基础设施。在 LLM 应用开发领域,LangSmith(LangChain 官方推出的调试追踪平台)、Langfuse(开源的 LLM 观测工具)等产品已经在为开发者提供类似能力,但它们主要面向技术团队的开发调试场景。PilotDeck 的不同之处在于,它将可观测性直接暴露给终端用户——你不需要是开发者,也能看到 Agent 的记忆是如何被存储、检索和使用的。
这个功能听起来不够酷炫,但在长期任务中极其有用。因为你让 Agent 干的事情越多、越复杂,就越需要一套完整的"工作记录审计"能力。这本质上是把 Agent 从一个黑盒对话工具,变成了一个可以被管理、被审查的工作系统。
痛点三:模型一刀切——智能路由与成本可控
并非所有任务都需要最强的模型。整理文字用轻量模型就够了,规划推理写代码才需要更强的模型。但在大多数 Agent 工具中,你只能绑定一个模型,要么全用贵的浪费钱,要么全用便宜的牺牲质量。
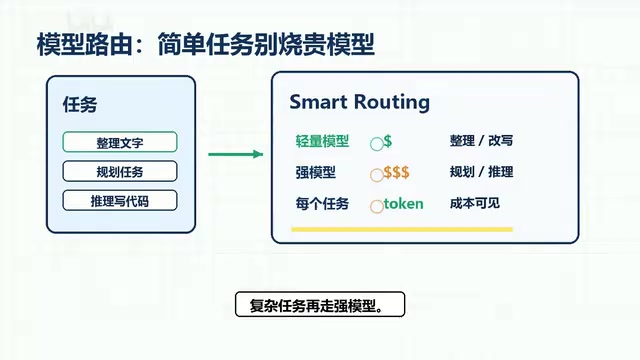
PilotDeck 支持模型路由:简单任务走便宜模型,复杂任务走强模型。模型路由(Model Routing)是近一年来 AI 工程领域的热门话题,其核心思想是根据任务的复杂度、类型和成本预算,动态选择最合适的模型来处理请求。技术实现上,路由策略通常包括三个层次:基于规则的路由,即按任务类型预设模型映射(如"文本摘要→小模型,代码生成→大模型");基于成本的路由,设定预算阈值,当消耗接近上限时自动降级到更便宜的模型;以及基于质量评估的智能路由,用一个轻量级的分类器或小模型先评估输入任务的难度,再决定分发给哪个模型处理——OpenAI 的 GPT-4o-mini 在某种程度上就是为这种分层架构设计的。不同模型的 Token 价格差异巨大——以 2025 年中的价格为例,GPT-4o 的输入价格约为 $2.5/百万 Token,而 GPT-4o-mini 仅为 $0.15/百万 Token,相差约 17 倍;Claude 3.5 Sonnet 与 Claude 3.5 Haiku 之间也有约 10 倍的价格差距;国内模型如 DeepSeek广告-V3 的价格则更为低廉。对于日均消耗数十万 Token 的重度用户(这在让 Agent 跑调研、写代码的场景中很常见),合理的模型路由可以在不明显牺牲输出质量的前提下将月度成本降低 60%-80%。业界已有 Martian、Unify.ai 等专门做模型路由的创业公司,而 PilotDeck 将这一能力直接内置到了 Agent 控制台中。
更重要的是,每个任务花了多少 Token,在界面里都能直接看到。这让成本从"月底看账单才知道"变成了"实时可感知、可优化"的状态。对于企业用户或者重度个人用户来说,这个功能的价值摆在眼前的事实。
安装与配置
安装方式相当友好,不需要复杂的环境配置:
- macOS / Linux:官方提供一行安装脚本,装完后输入
pilotdeck命令,本地服务会跑在localhost:3001 - 开发者:可以从源码启动
- Docker 用户:直接运行
docker compose up -d即可
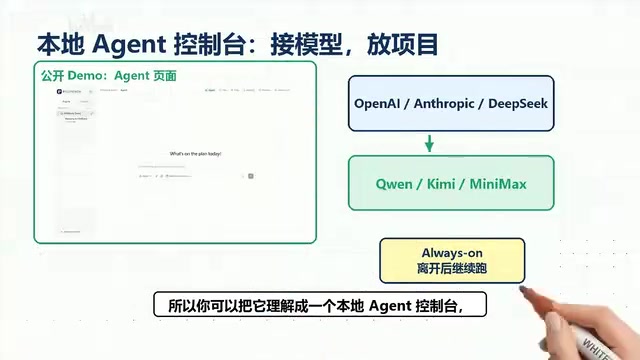
模型 API 需要自行配置,可以写在本地配置文件里,也可以在 Web 界面的设置中填写。官方提到支持 OpenAI、Anthropic、DeepSeek、Qwen、Kimi、MiniMax,以及所有 OpenAI 兼容接口。这里的"OpenAI 兼容接口"是一个值得展开的概念:由于 OpenAI 最早定义了 Chat Completions API 的请求/响应格式,这套接口规范已经成为事实上的行业标准。几乎所有主流模型提供商(包括国内的智谱、百川、零一万物等)都提供了与 OpenAI API 格式兼容的接口,本地部署工具如 Ollama、vLLM、LM Studio 也遵循这一规范。这意味着只要你的模型服务暴露了兼容 OpenAI 格式的 API 端点,就能直接接入 PilotDeck,国内外主流模型基本都能无缝使用。
Always-On 设计:离开电脑也能跑
PilotDeck 还有一个值得关注的设计——Always-On 模式。你离开电脑之后,Agent 可以继续执行长时间任务,最后把结果写成本地文件,再给你一份总结。
Always-On 模式背后涉及 Agent 系统的异步执行架构设计。传统的同步对话模式要求用户在线等待每一步结果,交互模式是"你说一句、我回一句"的乒乓球式来回。而异步模式则将任务提交与结果获取彻底解耦——用户提交任务后即可离开,Agent 在后台自主规划执行步骤、调用工具、处理中间结果,最终将产出物持久化到本地。这在技术上通常需要几个关键组件:任务队列(确保任务不会因为用户断开连接而丢失)、持久化状态管理(将 Agent 的执行进度、中间结果、上下文状态保存到磁盘,即使进程重启也能恢复)、以及结果回写与通知机制(任务完成后将结果写入文件并生成摘要)。类似的异步执行设计在 Devin(Cognition Labs 推出的 AI 软件工程师)、OpenHands(原 OpenDevin,开源 AI 编程 Agent)以及 Manus 等产品中也有体现,它们都支持用户提交任务后"走开",Agent 自主完成工作。这种模式的意义在于,它将 Agent 从"实时助手"升级为"后台工作者",更接近人类团队中"把任务分配给同事然后各干各的"的异步协作模式。不过这也带来了新的挑战:如何在无人监督的情况下保证 Agent 不偏离目标(需要明确的任务规范和约束条件)、如何处理执行中的异常和歧义(是暂停等待用户确认还是自主决策)、以及如何防止 Agent 在长时间运行中产生"幻觉"导致结果偏差,都是需要持续优化的问题。
这对于需要跑几个小时的调研任务、数据整理任务来说非常实用,真正实现了"交给 Agent 然后去做别的事"的工作模式。
谁需要 PilotDeck?
坦率地说,如果你只是偶尔问 AI 几句话,PilotDeck 对你来说确实没那么刚需。但如果你已经开始让 Agent 写项目、做调研、跑流程,并且经常同时推进多个任务,那这类工具就非常值得关注。
从更宏观的视角看,PilotDeck 代表了 Agent 工具发展的一个重要方向:从"对话工具"到"工作系统"的进化。这个趋势在 2025 年变得尤为明显——Anthropic 推出了 Claude 的"Projects"功能来管理多项目上下文,OpenAI 在 ChatGPT 中引入了"Memory"持久记忆,Google 的 Gemini 也在探索跨会话的任务管理。但这些都是在聊天界面上的渐进式改良,而 PilotDeck 的思路更为激进:它直接跳出了聊天框的范式,构建了一个独立的控制台。当 Agent 不再只是回答问题,而是真正在帮你执行复杂的多步骤任务时,我们需要的不再是更好的聊天界面,而是项目管理、记忆审计、成本控制这些"基础设施"级别的能力。这与软件行业从"手动操作服务器"到"使用 Kubernetes 编排容器"的演进逻辑如出一辙——当管理对象的数量和复杂度超过人脑的直觉管理能力时,就需要专门的管理系统。PilotDeck 正在这个方向上做出有价值的探索。
核心要点
核心要点
相关推荐

34款AI编程助手混战终端,如何避免选错?
34款AI编程助手涌入终端,Orca工具支持多代理并行。本文分析淘金热背后的整合趋势、多代理并行的成本陷阱,以及如何保持代理中立的工作流,避免选错工具。

Gemini CLI实战:终端里的AI编程Agent
深入解析Gemini CLI:从安装认证到实战构建任务管理应用,涵盖计划模式、自动调试、GEMINI.md上下文持久化与token成本统计,帮助开发者用终端AI Agent提升编码效率。

Open Design:免费开源版Claude Design,激活你的编程智能体
Open Design 是一款免费开源的 Claude Design 替代品,本地运行,内置 250+ 设计技能,自动检测 16 种编程智能体,支持原型、幻灯片、移动端界面等设计任务。