Pinecone自适应检索器:企业AI搜索如何兼顾速度与精度
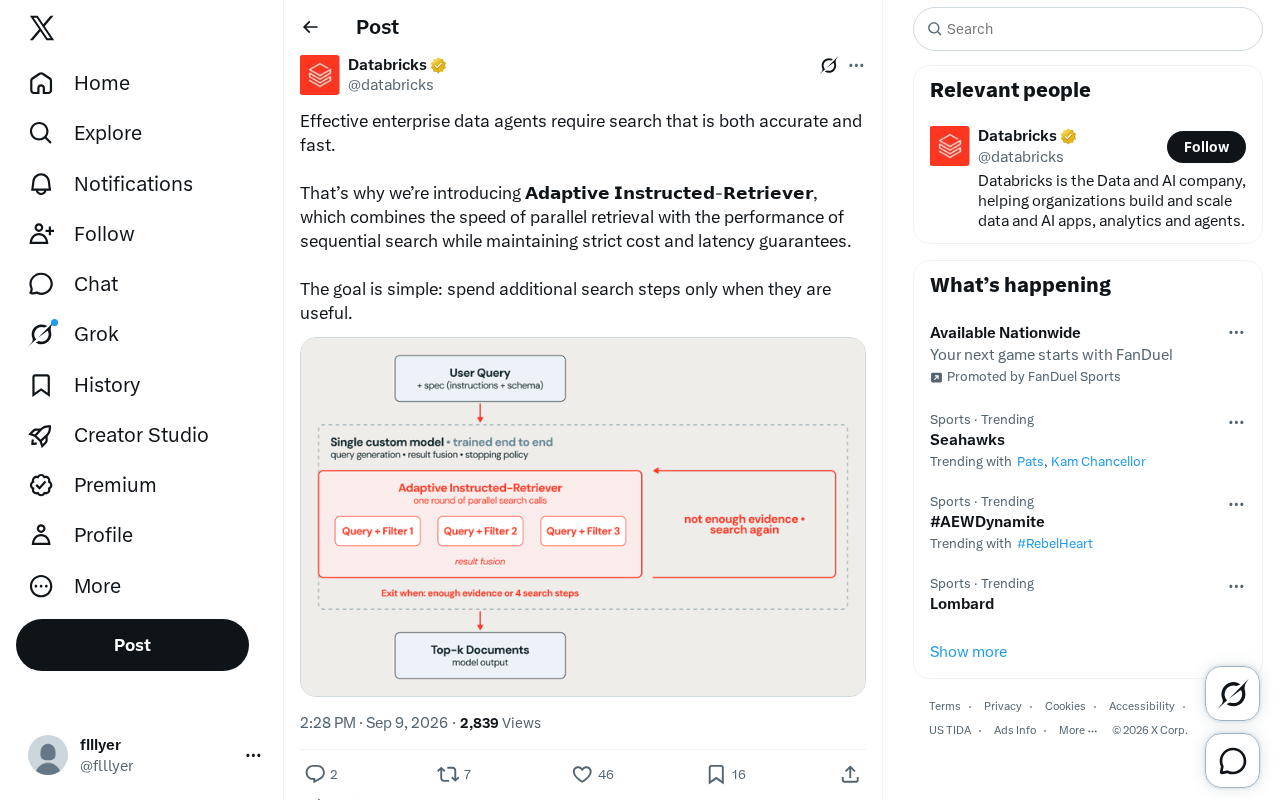
Pinecone推出自适应指令检索器,动态融合并行与顺序检索,平衡企业AI的速度、精度与成本。
Pinecone推出的Adaptive Instructed-Retriever(自适应指令检索器)针对企业数据Agent中并行检索速度快但精度不足、顺序搜索精度高但延迟大的经典矛盾,提出了一种按需触发的智能检索策略。系统默认以并行方式快速获取初步结果,当结果质量不达标时才启动顺序搜索,且整个过程在严格的成本和延迟约束下运行,只有当额外搜索步骤的预期收益超过成本时才执行。这一机制使企业文档问答、智能客服、内部知识库等知识密集型场景能够同时兼顾响应流畅与复杂查询的准确性,同时避免为所有请求支付深度搜索的高额成本,代表了RAG技术从"能用"走向"好用"的重要演进方向。
企业数据Agent面临的检索难题
在企业级AI应用中,数据检索始终绕不开一个经典的权衡难题:如何在保证检索精度的同时,维持足够快的响应速度?
传统的并行检索虽然速度快,但往往牺牲了准确性;而顺序搜索虽然结果更精准,却会带来明显的延迟。对于需要实时响应的企业数据Agent来说,这个矛盾尤为棘手。
Pinecone最新推出的 Adaptive Instructed-Retriever(自适应指令检索器) 正是为解决这一痛点而设计。其核心理念简单而有效:只在真正需要的时候才执行额外的搜索步骤,从而在速度、精度和成本之间找到最佳平衡点。
Adaptive Instructed-Retriever的技术创新
自适应指令检索器的独特之处在于其智能化的搜索策略。与传统方案不同,它不会盲目执行固定数量的检索步骤,而是根据实际需求动态调整搜索深度。这种自适应机制融合了两种检索模式的优势:
并行检索:保障基础响应速度
系统首先通过并行方式快速获取初步结果,保证了基础响应速度,能够满足大多数常规查询的需求。
顺序搜索:按需提升检索精度
当初步结果质量不够理想时,系统会智能启动顺序搜索模式,通过更深入的检索来提升结果质量。这种按需触发的机制有效避免了不必要的计算开销。
说个细节,整个过程都在严格的成本和延迟约束下运行。系统会实时评估每个额外搜索步骤的潜在价值,只有当预期收益超过成本时才会执行。这种"精打细算"的策略让企业能够在可控的预算内获得最优的检索效果。
对企业AI搜索场景的实际价值
这项技术对企业级AI应用有着直接的实践意义。在真实业务场景中,不同查询的复杂度差异巨大:
- 简单事实查询:快速并行检索即可返回准确结果
- 复杂分析型问题:需要更深层次的顺序搜索来获取高质量答案
自适应检索器能够针对不同情况自动选择最合适的策略,无需人工调优参数。
对于企业数据Agent而言,这意味着可以在保持用户体验流畅的同时,显著提升复杂查询的准确性。特别是在以下知识密集型场景中,优势尤为明显:
- 企业文档智能问答:面对海量内部文档时精准定位关键信息
- 智能客服系统:快速响应简单问题,深入处理复杂咨询
- 内部知识库检索:在兼顾效率的前提下提升答案的全面性
从成本角度看,按需执行额外搜索步骤的策略也避免了资源浪费。企业不必为所有查询都支付高昂的深度搜索成本,而是根据实际需求动态分配计算资源——这对于大规模部署的AI系统来说,是一个不可忽视的经济优势。
RAG技术演进的重要方向
Pinecone此次推出的自适应检索器代表了 RAG(检索增强生成) 技术的一个重要演进方向。随着企业AI应用逐步走向成熟,业界越来越清楚地认识到,简单的"一刀切"检索方案难以满足复杂多变的实际需求。
未来的检索系统需要更加智能化,能够根据以下维度自主做出最优决策:
- 查询特征:识别问题的类型和复杂程度
- 业务场景:适配不同应用对延迟和精度的要求
- 资源约束:在预算范围内实现效果最大化
这种自适应思路不仅适用于检索环节,也为整个AI系统的架构优化提供了启发:在保证服务质量的前提下,通过智能化的资源调度和按需计算,实现成本、性能和用户体验的多目标优化。
对于正在构建企业级AI应用的技术团队来说,自适应检索是一个值得深入关注和借鉴的技术方向。
相关推荐

让AI审查自己的文档:验证CLAUDE.md真伪的开源工具包
RAG Techniques仓库作者开源了一套工具,用于验证AI Agent读取的CLAUDE.md和项目文档中哪些是猜测、哪些被代码证伪。文章解析其置信度标注机制、与Claude Code /init的对比及局限性。

谷歌又一AI安全研究员离职:警告"我们可能都要死"
谷歌又一位AI安全研究员离职并发出"人类可能面临灭绝"的极端警告,本文解析此类离职背后的行业张力、存在性风险争论以及AI治理的深层挑战。

19.8MB的LLM:44M参数模型如何在CPU上跑出1900 tok/s
开发者QLNI从零训练出仅19.8MB、44M参数的量化语言模型SHADOW-50M,采用三元权重和冻结指纹词表,CPU上跑出约1900 tok/s。它把计算交给专用电路、记忆交给磁盘索引,在精确计算与可靠检索任务上超越同级模型。