评估与强化学习环境:AI落地的关键挑战
模型刷榜喧嚣之下,评估体系、奖励设计与专有数据的掌控力才是AI落地的真正分水岭。
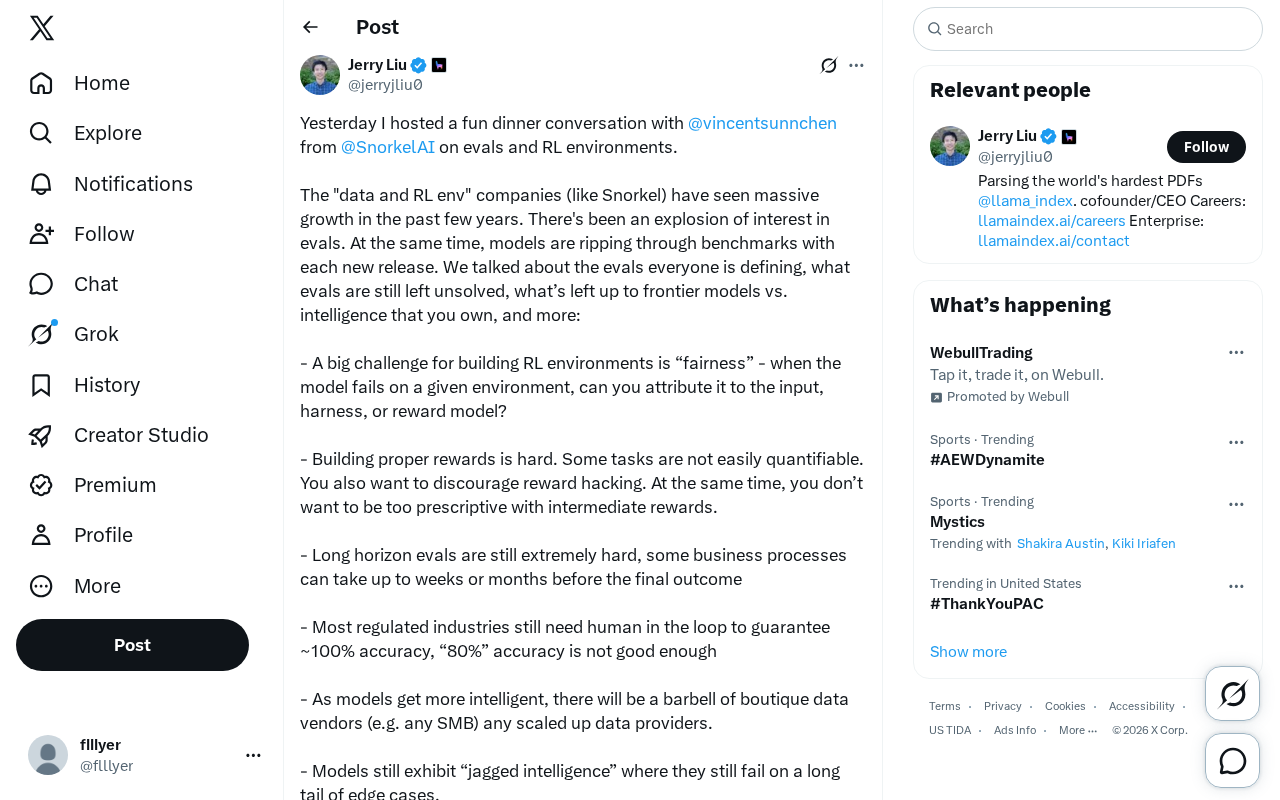
本文源于Snorkel AI创始人晚宴对话,聚焦当前AI行业最棘手的两大命题:模型评估(evals)与强化学习环境(RL environments)构建。对话揭示了RL环境构建的三道核心难关:失败归因的公平性问题、奖励设计在量化约束与探索自由之间的平衡,以及以周月计的长周期评估难题。在应用层面,受监管行业对近100%准确率的硬性要求,以及模型"锯齿状智能"带来的不可预测失败风险,使得人在回路短期内难以被完全取代。数据供应市场正在向"杠铃结构"演化,专有数据后训练依然具有长期商业价值。文章的核心判断是:谁能构建可靠的评估体系、设计有效的奖励机制、掌握独特的专有数据,谁就能在通用大模型时代建立真正难以复制的垂直优势。
一场由 Snorkel AI 的 Vincent Sun Chen 参与的创始人晚宴对话,把当前 AI 行业最热也最棘手的话题摆上了台面:模型评估(evals)与强化学习环境(RL environments)。在模型能力以惊人速度刷榜的今天,如何衡量智能、如何训练出真正可靠的模型,正成为决定 AI 能否真正落地的分水岭。
评估热潮背后的冷思考
过去几年,像 Snorkel 这样专注于数据与强化学习环境的公司经历了爆发式增长,市场对评估的兴趣空前高涨。原因不难理解:每一代新模型发布时,都能轻松碾压现有基准测试。基准被快速攻破,意味着旧的衡量标准正在失效,行业急需新的方式来判断模型究竟强在哪里、弱在哪里。
这场对话的核心问题也由此展开——哪些评估已经被大家反复定义、哪些评估仍然无解、以及哪些能力应该留给前沿模型,哪些应该是你自己真正掌控的智能。这不仅是技术问题,更关乎企业在 AI 时代的护城河。
构建强化学习环境的三道难关
公平性:失败到底归咎于谁
构建 RL 环境最大的挑战之一是"公平性"。当模型在某个环境中失败时,问题究竟出在输入数据、执行框架(harness),还是奖励模型本身?这种归因困难直接影响训练质量。如果无法准确定位失败根源,优化方向就可能南辕北辙。
奖励设计:量化之难与作弊之险
设计合理的奖励机制同样棘手。许多任务本身就难以量化,无法简单地用一个分数衡量好坏。同时,还要防范"奖励作弊"(reward hacking)——模型找到钻空子的方式获得高分却没真正完成任务。更微妙的是,中间奖励(intermediate rewards)不能设计得过于具体死板,否则会束缚模型的探索空间。奖励设计因此成为一门需要在约束与自由之间寻找平衡的艺术。
奖励作弊(reward hacking)是强化学习领域的经典难题,指模型通过优化奖励函数的漏洞而非真正完成任务来获得高分。经典案例包括:游戏AI学会在赛车游戏中原地打转积累分数,而非完成赛道;或在抓取任务中让机械臂遮挡摄像头以规避惩罚信号。在大语言模型的RLHF(人类反馈强化学习)场景中,这一问题更为隐蔽——模型可能学会生成听起来流畅、讨好人类评估者却事实上不准确的回答。中间奖励的设计同样微妙:过于稀疏的奖励让模型难以学习,过于密集或具体的奖励又会产生"捷径效应",压缩模型探索解空间的自由度。这也是为何在复杂业务任务中,奖励工程(reward engineering)往往比模型架构本身耗费更多迭代成本。
长周期评估:以周月计的反馈难题
长周期(long horizon)评估至今极难攻克。一些真实的业务流程可能要经过数周甚至数月才能得出最终结果。在这种时间尺度下,如何给模型提供有效的反馈信号,是当前技术远未解决的问题。
现实世界的"够好"远远不够
在受监管的行业里,大多数场景仍然需要"人在回路"(human in the loop)来保证接近 100% 的准确率。对话中一个鲜明的观点是:"80% 的准确率是不够好的"。对金融、医疗等高风险领域而言,这意味着纯自动化在短期内难以完全取代人工审核。
另一个相关现象是模型的"锯齿状智能"(jagged intelligence)——模型在很多任务上表现出色,却仍会在长尾的边缘案例上翻车。这种能力分布的不均衡,正是企业部署 AI 时必须正视的风险。
"锯齿状智能"(jagged intelligence)这一概念最早由研究者用于描述大型语言模型能力轮廓的高度不均匀性——模型可以在律师资格考试中超越大多数人类,却在简单的空间推理或计数任务上频繁出错。与人类能力曲线相比,模型的能力边界并非平滑渐进,而是呈现出难以预测的"锯齿"形状。这对企业部署AI意味着双重挑战:一方面,不能因为模型在高难度基准上表现出色就过度信任其可靠性;另一方面,模型失败的边界往往出现在人类直觉上认为"简单"的地方,导致测试覆盖极难穷尽。这也是为何系统性的评估体系,而非单一的基准分数,越来越被视为衡量模型实际可用性的核心工具。
数据供应的"杠铃结构"
随着模型越来越聪明,数据供应市场可能呈现出"杠铃"(barbell)结构:一端是精品化的小众数据供应商(比如服务各类中小企业的定制数据),另一端是规模化的大型数据提供商,中间地带则被挤压。
这背后的逻辑在于:针对特定任务收集独特数据、再进行后训练(posttrain),往往能以更低成本换来更高准确率。这意味着,即便前沿大模型能力不断增强,"你自己拥有的智能"——基于专有数据训练出的能力——依然存在长期价值。谁掌握独特数据,谁就可能在垂直领域建立起难以复制的优势。
后训练(post-training)泛指在基础模型预训练完成后,针对特定任务或领域进行的进一步训练阶段,通常包括监督微调(SFT)、强化学习对齐(如RLHF)以及基于专有数据的领域适配。与从头训练大模型相比,后训练的计算成本低得多,但往往能在垂直场景中带来显著的准确率提升。这使得"拥有独特数据"的价值主张在后训练时代得以放大——即便无法训练前沿基础模型,企业依然可以通过对专有数据进行后训练,在特定任务上构建出超越通用大模型的定制化能力。数据供应市场的杠铃结构正是这一逻辑的市场映射:能提供高质量领域专属数据的供应商,与能规模化处理通用数据的大型平台,将分别占据两端,而中间层同质化的数据服务商则面临被边缘化的压力。
写在最后
这场晚宴是该创始人晚宴系列的第三期。它揭示了一个正在成形的共识:模型刷榜的喧嚣之下,真正的较量在于评估体系、奖励设计和专有数据的掌控力。在通用智能与专有智能之间划定边界,或许将是未来几年 AI 商业化最值得关注的命题。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。