PISA 2025实证:AI文本检测器在真实学生写作中表现如何?

PISA真实写作数据显示AI检测器文本级可靠,但句子级和对抗改写条件下明显脆弱。
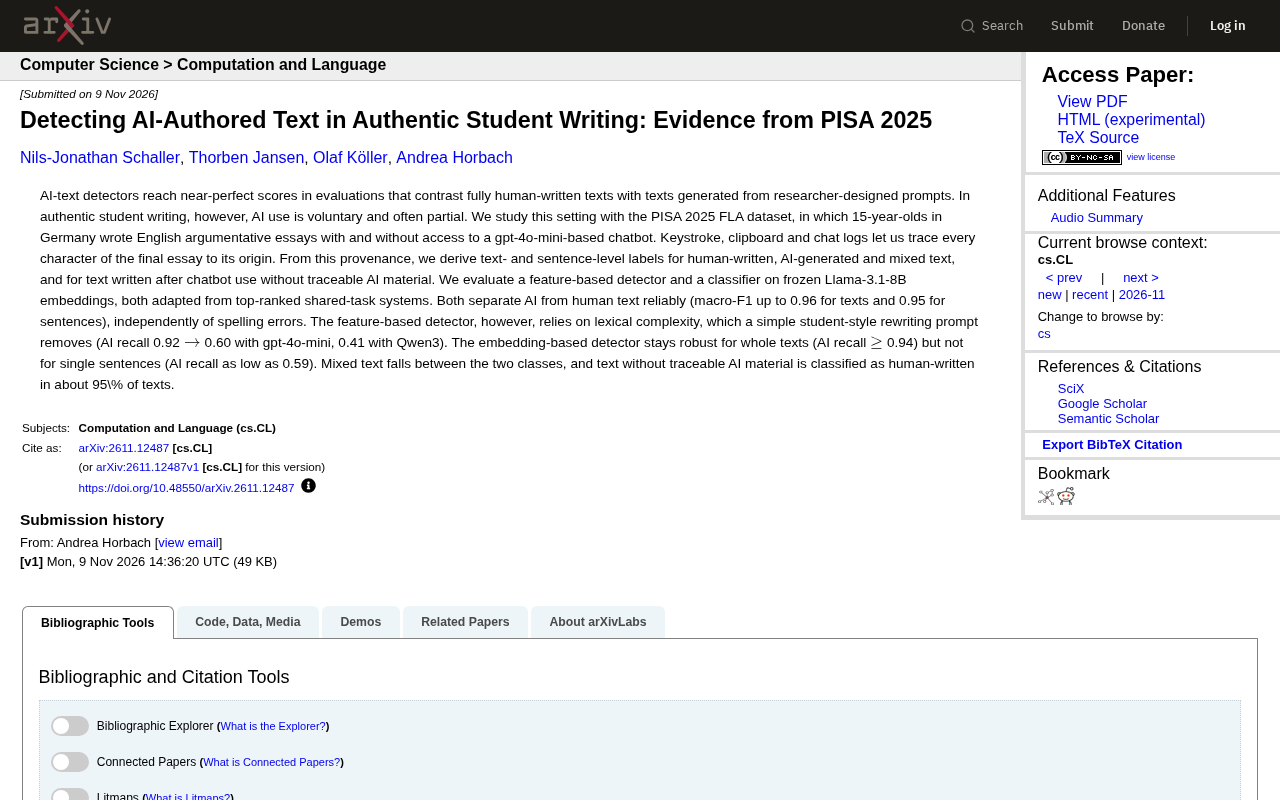
一项基于PISA 2025真实写作数据的研究,利用击键、剪贴板和聊天日志将作文每个字符溯源,评估AI文本检测器在真实学生写作场景中的表现。结果显示,基于特征和基于Llama-3.1-8B嵌入的两类检测器在文本级区分AI与人工文本上表现可靠,宏F1最高达0.96,句子级达0.95,且不受拼写错误影响。但稳健性差异明显:特征检测器依赖词汇复杂度,简单的学生风格改写即可使AI召回率从0.92降至0.60甚至0.41;嵌入检测器在整篇文本上保持稳健,单句检测召回率却最低仅0.59。混合文本结果居中,使用聊天机器人但无AI痕迹的文本约95%被判为人工。研究提示检测器不宜作为学术诚信唯一依据,溯源过程数据提供了替代思路。
AI文本检测器在实验室评测中常常接近完美,但真实的学生写作场景要复杂得多——AI使用是自愿的、零散的,甚至只是润色几个词。一项基于PISA 2025真实写作数据的研究,给这个难题提供了迄今最细致的答案。
研究设计:追踪每一个字符的来源
研究使用了PISA 2025 FLA(外语评估)数据集,样本为德国15岁学生撰写的英语议论文。学生在两种条件下写作:一种是纯人工写作,另一种可以使用基于gpt-4o-mini的聊天机器人辅助。
关键之处在于数据采集方式。研究团队记录了学生的击键、剪贴板和聊天日志,从而能够把最终作文中的每一个字符追溯到其来源。基于这种"溯源"信息,研究者为文本和句子分别打上标签:纯人工撰写、AI生成、混合文本,以及"聊天机器人使用后但无AI痕迹"的文本。
这比传统检测研究前进了一大步。多数检测器评测用的是"全人工 vs 全AI生成"的干净对照,而真实课堂里的AI使用往往是局部的、碎片化的——学生可能只是让AI改写一句话,或者参考AI建议后自己重写。
PISA 2025 FLA(Foreign Language Assessment,外语评估) 是OECD国际学生评估项目2025周期新增的外语测评模块,聚焦15岁学生在真实任务情境下的外语产出能力。本研究使用的子集为德国学生用英语撰写的议论文,属于半真实、有统一任务约束的写作数据——既保留了真实学生的语言水平与写作习惯(含拼写错误、口语化表达),又具备可比性和可追溯的采集环境。相较实验室中由成人或模型生成的“干净”语料,这类数据更贴近课堂实际,但也带来标注依赖过程日志、样本语言与文体受限等局限,正是文末开放问题所指的方向。
检测表现:文本级别可靠,句子级别脆弱
研究评估了两类检测系统:一类是基于特征的传统检测器,另一类是基于冻结的Llama-3.1-8B嵌入的分类器。两者都改编自共享任务中排名靠前的系统。
在区分AI文本与人工文本的任务上,两者都表现可靠:文本级别的宏平均F1最高达到0.96,句子级别最高0.95,且不受拼写错误影响。这个结果说明,即便在真实写作的噪声环境下,检测器仍具备相当的判别能力。
但稳健性测试揭示了明显差异。基于特征的检测器依赖词汇复杂度这一信号,而一个简单的"学生风格改写"提示就能大幅削弱它——用gpt-4o-mini改写后,AI召回率从0.92降到0.60;用Qwen3改写后进一步降到0.41。换句话说,只要AI生成的内容被刻意"降维"成学生口吻,特征检测器就近乎失效。
基于嵌入的检测器在整篇文本上更稳健,AI召回率保持在0.94以上;但面对单句时同样脆弱,AI召回率最低只有0.59。
宏平均F1(Macro-averaged F1) 是分类任务中常用的综合指标:先分别计算每个类别(此处为“AI文本”和“人工文本”)的F1分数(精确率与召回率的调和平均),再对各类F1取算术平均。与微平均不同,宏平均赋予每个类别同等权重,因此当两类样本数量不均衡时(例如人工文本远多于AI文本),宏平均能更敏感地反映少数类的检测质量。文中报告文本级宏F1达0.96,意味着检测器在两类上均有均衡且很高的精确率与召回率,而非仅靠预测多数类“刷”出高分。
AI召回率(Recall) 指在所有真实由AI生成(或含可追溯AI内容)的样本中,被检测器正确判为AI的比例。召回率下降意味着更多AI文本被漏检、误判为人工撰写,这正是学术诚信场景中最危险的错误类型。因此文中用改写前后AI召回率的变化(0.92→0.60→0.41)来量化检测器被“学生风格改写”绕过的程度,比单纯看准确率更能说明对抗条件下的失效风险。
基于特征的检测器与基于嵌入的检测器 代表两条不同的技术路线。前者依赖人工设计的可解释特征,如词汇复杂度(罕见词比例、词长分布)、句法复杂度、标点与功能词频率等,再交由传统分类器(如逻辑回归、梯度提升树)判别。其优势是轻量、可解释,但弱点也明显:一旦改写工具刻意压低词汇复杂度、模仿学生口吻,这些表层信号就被抹平。后者则用预训练语言模型(此处为冻结的Llama-3.1-8B)将文本编码为稠密向量,再在嵌入空间上训练分类头。“冻结”意味着编码器参数不更新,只训练顶层分类器,计算成本低且不易过拟合小样本。嵌入捕捉的是更深层的语义与分布模式,故在整篇文本上更稳健;但单句信息量有限,嵌入区分度下降,导致句子级检测脆弱。
混合文本与无痕文本:检测的灰色地带
研究还考察了两类特殊文本。混合文本(人机交替撰写)的检测结果落在两类之间,符合直觉——它既不是纯人工也不是纯AI。
更值得关注的是"无AI痕迹"的文本:学生使用了聊天机器人,但最终作文中找不到可追溯的AI生成内容。这类文本在约95%的情况下被分类为人工撰写。这其实是合理的——如果学生参考AI建议后完全用自己的话重写,最终产物确实更接近人工写作。但它也提醒我们,检测器的"人工"判定并不等于"未使用AI"。
“无AI痕迹”文本的判定逻辑 值得从检测目标层面厘清。这类文本的记录显示学生确实调用过聊天机器人,但最终成稿中没有任何字符可追溯到AI输出——学生可能阅读了AI建议后完全用自己的措辞重写。检测器约95%将其判为人工撰写,这与其说是“误判”,不如说暴露了检测任务本身的目标错位:检测器判断的是“文本表层是否由AI生成”,而非“写作过程中是否使用过AI”。两者在真实课堂中并不等价。这也解释了为何研究强调溯源数据(击键、剪贴板、聊天日志)的价值——过程性证据能回答“是否使用”,而事后文本检测只能回答“是否留下痕迹”,二者互补而非替代。
对教育与检测实践的启示
这项研究传递出几个值得教育工作者和工具开发者重视的信号。
第一,检测器在"AI vs 人工"的二分类上表现不错,但真实场景中的AI使用形态远比二分类复杂。混合写作、参考后重写、局部润色,这些形态让检测边界变得模糊。
第二,检测器的稳健性高度依赖其所依赖的信号。词汇复杂度这类表层特征容易被改写提示绕过,嵌入级特征在长文本上更可靠,但句子级判断仍不可靠。单一检测器不应作为学术诚信判定的唯一依据。
第三,溯源数据(击键、剪贴板、聊天日志)提供了一种不同于"事后检测"的思路:与其猜测文本是否由AI生成,不如在写作过程中记录创作轨迹。这对评估工具的设计有直接参考价值。
研究也留下了开放问题:当前结果基于德国15岁学生的英语议论文写作,其他语言、其他文体、其他年龄段的表现尚待验证。检测器与改写工具的对抗也不会停在这里。
相关推荐

Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。

AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。