Playwright+Claude Code:AI驱动自动化测试实战指南
Playwright结合Claude Code Agent,构建从Web/接口自动化到AI智能生成测试用例的完整现代测试体系。
本文介绍了一套以AI Agent为核心的自动化测试新范式,分三大模块展开:第一模块以Playwright为基础,掌握元素定位与多浏览器兼容测试;第二模块通过pytest和OpenAPI规范打通接口自动化全流程,并接入CI/CD持续集成;第三模块以Claude Code驱动AI Agent,通过Skills技能设计让Agent自主控制浏览器、生成测试用例,并引入LLM评测体系对AI输出质量进行量化管控。三模块形成完整工具链,推动测试工程师从"脚本编写者"转型为"AI测试系统的设计者与监督者",代表了软件测试在AI时代的方法论升级。
自动化测试进入AI Agent时代
软件测试正在经历一场深刻变革。传统自动化测试依赖工程师手写脚本、维护用例,工作量大且脆弱——页面稍有改动,脚本就可能失效。随着大语言模型和AI Agent技术的成熟,"AI+自动化测试"正成为测试工程师必须掌握的新范式。
本文基于一套系统化的AI自动化测试教程,梳理如何将 Playwright(微软推出的现代化浏览器自动化框架)与 Claude Code 驱动的 Agent 结合,实现从Web自动化控制到"一键生成测试用例"的效率跃迁。整个体系分为三大模块,覆盖Web自动化、接口自动化以及AI Agent进阶,适合零基础入门者,也能满足测试进阶者构建完整评测体系的需求。
Playwright驱动的Web自动化基础
Web自动化是整个测试链路的地基。Playwright之所以在近年迅速取代Selenium成为主流选择,核心在于它的稳定性与现代化设计:内置自动等待机制、支持无头模式、天然适配现代前端框架。
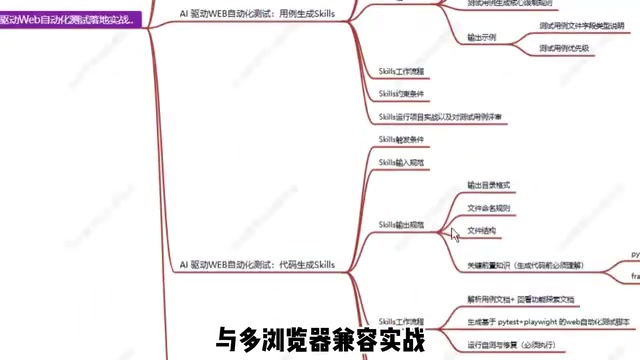
这一模块从最基础的浏览器自动化控制入手,逐步深入到元素定位与多浏览器兼容实战。
元素定位:自动化测试的核心难点
元素定位是自动化测试中最常遇到的挑战之一。Playwright提供了基于文本、角色(role)、CSS选择器、XPath等多种定位策略,其中基于语义角色的定位方式更贴近用户真实操作,也更抗页面结构变化。相比传统的XPath硬编码,这种方式在页面重构时依然能保持稳定。
多浏览器兼容测试
多浏览器测试解决了跨平台一致性问题。同一套Playwright脚本可以在 Chromium、Firefox、WebKit 三大引擎上运行,确保产品在不同浏览器下行为一致。掌握这一层,意味着你已经具备了传统自动化测试的完整能力,为后续引入AI打下坚实基础。
AI智能体驱动的接口自动化
如果说Web自动化面向的是前端交互,那么接口自动化则直击系统的"神经中枢"。接口测试执行速度快、稳定性高,是持续集成流程中不可或缺的一环。
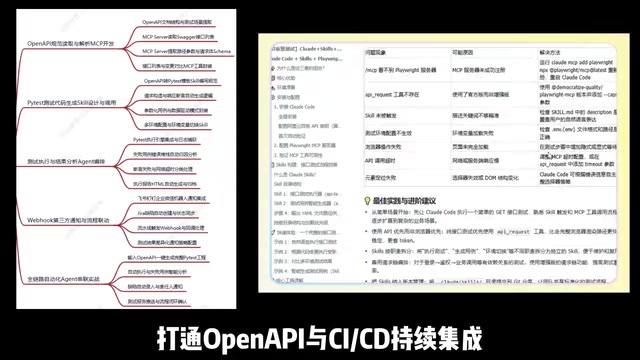
这一模块打通了接口测试的全流程:
从pytest测试框架到断言体系
通过 pytest 框架组织测试用例,配合断言机制验证接口返回的状态码、数据结构与业务逻辑。断言是测试的"判决"环节,决定了一个用例的通过与否。设计良好的断言能精准捕捉缺陷,避免"假通过"的情况发生。
OpenAPI规范与CI/CD持续集成
更进一步,这套方案强调了 OpenAPI 规范 的价值。基于OpenAPI文档,AI可以理解接口的输入输出契约,从而自动生成接口测试用例——这正是AI智能体介入的关键切入点。
生成的用例再接入 CI/CD 持续集成 流水线,实现代码提交即触发自动化测试,让质量保障贯穿整个研发周期。这种"文档即测试"的思路,大幅降低了接口测试的编写与维护成本。
Claude Code驱动Agent的进阶实战
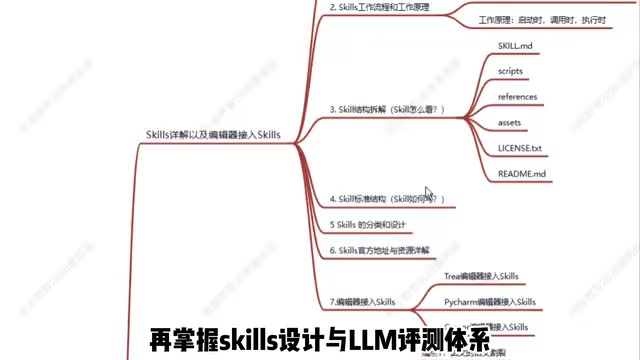
这是整套体系最具前沿价值的部分。核心理念是:用 Claude Code 驱动 AI Agent,让Agent自主控制浏览器完成测试任务。
Skills技能设计:让Agent学会测试
AI Agent并非天生会做测试,需要通过 Skills(技能)设计 赋予它领域能力。开发者将测试的最佳实践、常用操作封装为可复用的技能模块,Agent在执行任务时按需调用。
这种方式让AI从"随机生成脚本"进化为"有章法地执行测试策略",显著提升了生成结果的可靠性和一致性。
LLM评测体系:给AI的输出打分
引入AI后一个绕不开的问题是:如何评估AI生成内容的质量?
这套方案构建了 LLM 评测体系,用于衡量AI生成的测试用例是否覆盖充分、断言是否合理、逻辑是否正确。这套评测机制是保证AI测试可靠性的"守门员",避免AI"看起来在工作,实际上漏洞百出"的情况。
当Agent能够自主理解需求、控制浏览器操作、生成并自我评估用例时,测试工程师的角色便从"脚本编写者"转变为"AI测试系统的设计者与监督者"。
全站工具链:构建完整AI测试能力
三大模块最终汇聚为一条完整的AI测试工具链:
- Playwright负责浏览器层面的精准控制
- pytest与OpenAPI支撑接口层的自动化
- Claude Code与Agent在顶层提供智能决策与用例生成能力
- LLM评测体系为整个链路提供质量兜底
这套体系的价值不仅在于"能跑通",更在于它体现了AI时代测试工程的新方法论:
- 从手写到生成:用例编写从人力密集型走向AI辅助生成
- 从执行到评测:不仅关注测试执行,更建立对AI输出的量化评估
- 从工具到Agent:测试工具从被动执行的脚本,升级为主动决策的智能体
测试工程师的能力跃迁路径
对于零基础学习者,这套路径提供了从Playwright入门到AI Agent实战的完整阶梯;对于有经验的测试工程师,它指明了一个明确的进阶方向——掌握AI Agent驱动的测试能力,构建自己的评测体系。
会写脚本的测试工程师依然重要,但真正稀缺的是那些懂得设计AI测试系统、驾驭Agent、并能评估AI输出质量的复合型人才。Playwright + Claude Code的组合,正是通往这一能力跃迁的一条现实路径。
相关推荐

对抗AI代码腐化:规格、结果笔记与文件清单的实战方法
一位开发者用八个月、650次提交、4.3万行代码的实战,总结出防止AI智能体代码库腐化的方法:前置规格与验收标准、任务结果笔记、文件清单约束,以及用触发式钩子取代规则文件。核心洞察是——指令只是建议,机制才能在长会话中存活。

"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。