PLLM+:混合式回放与修复流水线破解Python依赖地狱

PLLM+用分层策略修复Python依赖:先确定性回放历史配置,再LLM兜底,效率提升5倍。
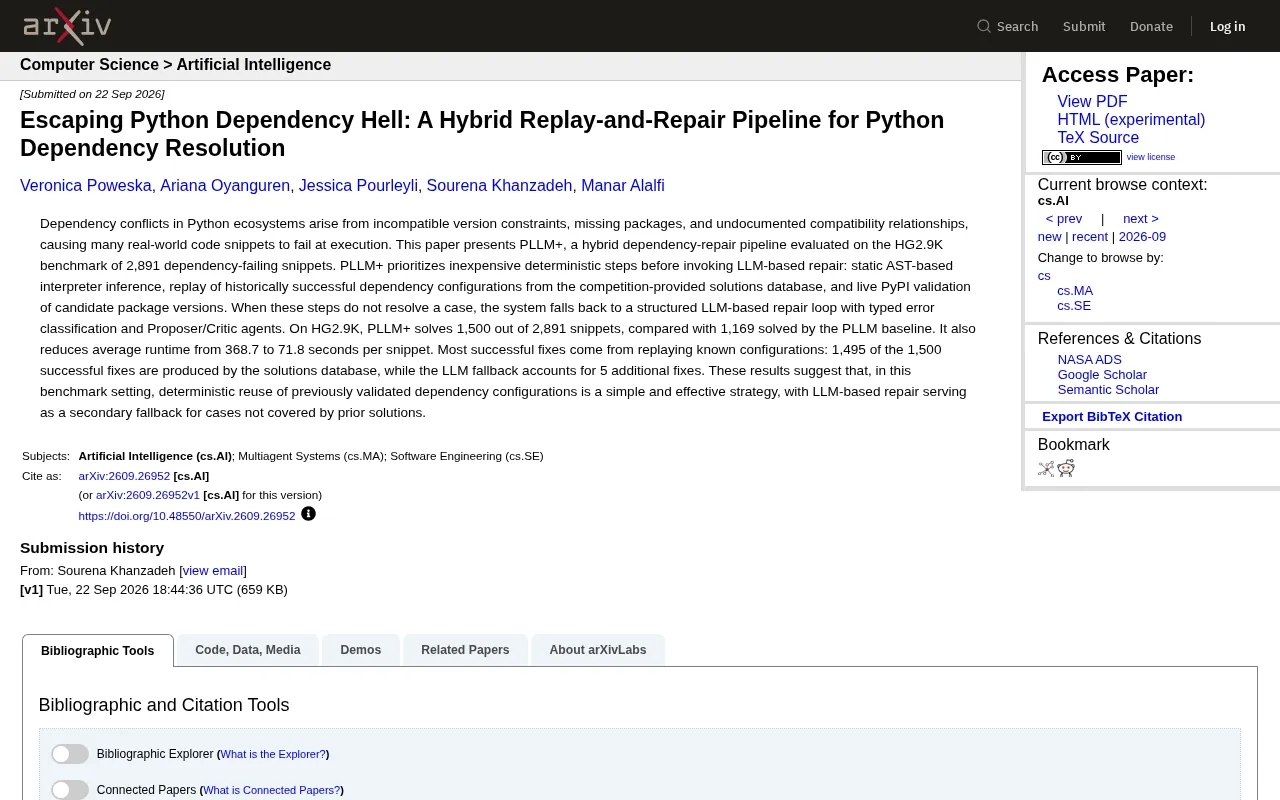
Python依赖冲突是开发者的高频痛点,arXiv新论文提出的PLLM+流水线通过「先便宜后昂贵」的分层设计加以应对:依次尝试AST静态推断、历史配置回放和实时PyPI验证等确定性步骤,仅在失败时才启用Proposer/Critic双智能体LLM修复。在HG2.9K基准(2891个依赖失败片段)上,PLLM+成功修复1500个,优于基线的1169个,同时将平均处理时间从368.7秒压缩至71.8秒。最引人注目的发现是:1500个修复中有1495个来自配置数据库回放,LLM仅贡献5个,有力印证了「知识复用优先于模型生成」的工程哲学——尽管该结论在很大程度上得益于竞赛场景的特殊数据分布。
Python依赖冲突:老问题,新解法
凡是写过Python的人,几乎都撞过依赖地狱的墙。版本约束不兼容、缺失的包、未记录的兼容关系——这些问题让大量看似正常的代码片段在执行时直接崩溃。对于研究者、教育者以及需要复现历史代码的工程师而言,这种「跑不起来」的挫败感是真实且高频的。
一篇新发布的arXiv论文(arXiv:2609.26952v1)提出了名为 PLLM+ 的混合依赖修复流水线,试图系统性地解决这个顽疾。它的核心思路值得关注:不是一上来就动用昂贵的大模型,而是先用便宜、确定性的手段解决问题,把LLM留作最后的兜底。
PLLM+ 的分层修复策略
先便宜后昂贵的执行顺序
PLLM+ 最鲜明的设计哲学是「优先执行低成本的确定性步骤」。整个流水线按成本从低到高排列了几个阶段:
- 静态AST解释器推断:通过抽象语法树分析,推断代码所需的解释器环境;
- 历史成功配置回放:从竞赛提供的解决方案数据库中,重放过去已经验证成功的依赖配置;
- 实时PyPI验证:对候选包版本进行在线校验,确认其真实可用性。
只有当上述确定性步骤都无法解决某个案例时,系统才会退回到基于LLM的结构化修复循环。
抽象语法树(AST)是源代码的树形结构表示,每个节点对应代码中的一个语法构造(如函数调用、导入语句、变量赋值)。Python内置的ast模块可以在不实际执行代码的情况下解析源文件,从import和from...import语句中静态提取依赖信息。这种静态分析的优势在于零运行成本、无需配置环境,缺点则是无法捕捉动态导入(如__import__()或importlib)以及运行时才确定的条件依赖。在PLLM+的流水线中,AST分析主要用于快速确定目标Python解释器版本范围,为后续步骤缩小搜索空间。
LLM兜底:类型化错误分类与双智能体
在LLM兜底环节,PLLM+ 并非简单地把错误抛给模型。它引入了「类型化错误分类」,先对失败原因归类,再通过 Proposer/Critic(提议者/批评者) 双智能体协作进行修复。Proposer负责提出修复方案,Critic负责审查与质疑,这种对抗式结构有助于提升修复的可靠性。
这套设计反映出一个务实的工程判断:大模型虽然强大,但在依赖解析这类有大量可复用历史知识的任务上,未必是性价比最高的首选工具。
Proposer/Critic双智能体架构源于多智能体辩论(Multi-Agent Debate)的研究范式。其核心洞察是:单一LLM在自我校验时往往存在「自我确认偏误」,倾向于为自己的输出辩护而非批判性审查。引入独立的Critic角色后,Proposer生成修复方案,Critic从不同视角(如版本兼容性矛盾、遗漏的传递依赖)提出质疑,Proposer再据此修订,形成迭代循环直到两者达成一致或超出重试次数。这种结构在代码生成、数学推理等任务中已被证明能有效提升输出质量,尤其适合依赖修复这类答案可被客观验证(能否成功运行)的场景,因为最终的「仲裁者」是实际执行结果而非模型自评。
实测数据:效果与代价
研究团队在 HG2.9K 基准上评估了 PLLM+,该基准包含 2,891 个存在依赖失败的代码片段。结果相当直接:
- 修复成功率:PLLM+ 解决了 1,500 个片段,而基线方法 PLLM 只解决了 1,169 个,提升约28%;
- 运行效率:平均每个片段的处理时间从 368.7 秒降至 71.8 秒,速度提升超过5倍。
更耗时更少却修得更多,这在系统设计上是一个漂亮的结果,也印证了「先确定性后LLM」策略的价值。
一个耐人寻味的发现:LLM只贡献了5个
数据里藏着一个值得深思的细节。在 1,500 个成功修复中,有 1,495 个来自解决方案数据库的配置回放,而LLM兜底仅额外贡献了 5 个修复。
这个悬殊的比例传递出一个清晰的信号:在这个基准设定下,确定性地复用过去已验证的依赖配置,是一种简单而高效的策略。大量依赖问题本质上是重复出现的,历史上已经有人踩过坑并找到了正确配置,直接重放这些答案远比让模型重新推理更快、更准。
当然,这也需要辩证看待。数据库回放之所以效果拔群,很大程度上得益于 HG2.9K 基准中的片段大量来自竞赛,且配套了解决方案数据库。换言之,这是一种「有前置答案」的理想场景。在没有现成解决方案库的真实开源项目中,LLM修复的相对权重可能会显著上升。
HG2.9K基准的构成背景对理解这一结果至关重要。该数据集中的代码片段大量来源于编程竞赛(如Kaggle、HackerRank等平台),这类片段有几个共同特征:依赖关系相对标准化、使用的库集中在数据科学与算法竞赛常用栈(numpy、pandas、scikit-learn等),且平台配套的解决方案通常附带完整的运行环境说明。这意味着「配置回放」几乎是在一个近似封闭的已知解空间内检索,命中率天然偏高。若基准换为来自GitHub的任意历史提交或学术论文附带代码,其依赖多样性和稀缺性会显著增加,配置数据库的覆盖率将大幅下降,届时LLM的边际贡献预计会更为突出。
对工程实践的启示
PLLM+ 的意义不止于一个更高的分数,它提供了一种可迁移的架构思路:
把知识复用放在生成之前。 面对依赖解析、配置修复这类高度重复、可积累经验的问题,先建立一个可靠的历史成功配置库,用确定性回放解决大多数常见情况,再用大模型处理长尾、罕见的疑难案例。这种分层设计既控制了成本,又提高了整体准确率。
对于正在构建AI辅助开发工具的团队,这是一个务实提醒:LLM不该是万能锤子。识别哪些环节适合确定性方法、哪些真正需要模型推理,才是系统设计的关键判断。
结语
Python依赖地狱短期内难以根治,但 PLLM+ 展示了一条清晰的减负路径——用便宜的手段解决大多数问题,把昂贵的智能留给真正棘手的少数。它的实验结果虽然带有基准场景的特定色彩,但「回放优先、LLM兜底」的设计哲学,对更广泛的自动化修复与代码工程任务都有借鉴价值。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。