PMR:为每个用户定制记忆评分标准,让AI代理更懂你

PMR框架通过双层个性化评分标准和token级信用分配,实现零推理开销的记忆更新策略学习。
本文针对长期陪伴型AI代理的记忆更新策略学习难题,指出传统方法依赖终端问答准确率导致反馈粗糙,且忽视用户异质性。为此,研究者提出个性化记忆评分标准(PMR)框架,将评估分解为通用层和用户自适应层,并通过评分标准引导的token级信用分配,在成功轨迹上放大已验证决策,失败轨迹上回退标准优化。评分标准与记忆策略协同进化,且部署时无需外部评判器,实现零推理开销。跨四个基准实验表明,PMR持续优于强记忆增强基线,为个性化AI代理的记忆管理提供了新思路。
长期陪伴型AI代理需要维护不断演变的记忆,持续决定该添加、修改还是丢弃哪些信息。然而,学习最优的记忆更新策略并不容易。传统训练方法仅依赖最终问答准确率这一终端信号,导致反馈过于粗糙,所有中间更新被一视同仁。更关键的是,记忆更新的效用因人而异——同一记忆操作对不同用户可能产生截然相反的效果。现有方法未能解决这种异质性,依赖全局共享的评估标准,最多只提供一个标量中间奖励。
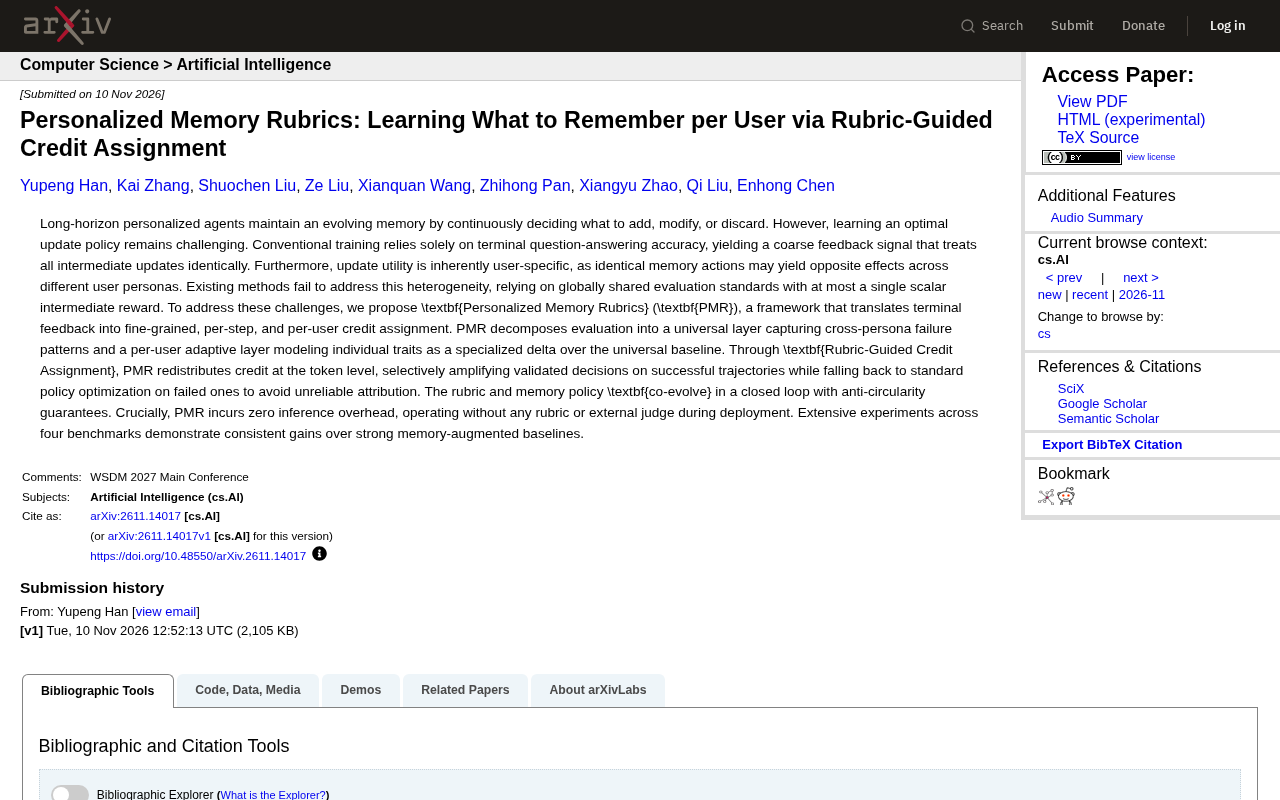
针对这些挑战,研究者提出个性化记忆评分标准(Personalized Memory Rubrics,简称PMR),一个将终端反馈转化为细粒度、逐步且针对每个用户的信用分配框架。PMR将评估分解为两层:通用层捕捉跨用户类型的失败模式,而每个用户的自适应层则建模个体特征,作为通用基线上的专门增量。通过评分标准引导的信用分配(Rubric-Guided Credit Assignment),PMR在token级别重新分配信用,在成功轨迹上选择性放大已验证的决策,而在失败轨迹上回退到标准策略优化,以避免不可靠的归因。评分标准与记忆策略在闭环中协同进化,并带有抗循环性保证。关键在于,PMR在部署时无需任何评分标准或外部评判器,实现了零推理开销。跨四个基准的大量实验表明,该方法相比强记忆增强基线取得了持续的性能提升。
为什么记忆更新策略难以学习
长期个性化代理的核心挑战在于记忆的动态管理。代理需要判断哪些信息值得保留、哪些需要修正、哪些应当删除。传统方法将最终问答准确率作为唯一训练信号,这意味着无论中间记忆更新质量如何,所有更新获得相同的信用分配。这种粗粒度反馈无法指导代理精细调整每一步记忆操作。
更深层的问题在于用户异质性。同一记忆操作对不同用户的效果可能相反——对某个用户有效的记忆添加,对另一个用户可能造成干扰。现有方法采用全局共享的评估标准,最多提供一个标量中间奖励,无法捕捉这种用户间的差异。PMR正是针对这两个痛点设计的。
信用分配(Credit Assignment) 是强化学习中的核心难题:当智能体执行一系列动作后获得最终奖励,如何判断序列中哪些动作贡献了正向或负向结果。在长期记忆代理中,一次对话可能涉及数十次记忆添加、修改或删除操作,而最终只有问答准确率一个信号,导致难以定位优劣操作。传统方法如REINFORCE或PPO通过策略梯度进行信用分配,但依赖标量奖励且方差较大。PMR的“token级信用分配”借鉴了细粒度归因思想,将终端反馈分解到每个记忆更新token上,从而实现更精准的策略优化。
PMR的核心设计:双层评估与token级信用分配
PMR将评估分解为通用层和用户自适应层。通用层捕捉跨用户类型的共性失败模式,而用户自适应层则建模个体特质,作为通用基线的增量。这种设计使得评估既能利用群体层面的规律,又能保留个体差异的敏感性。
在信用分配环节,PMR采用评分标准引导的token级重分配。对于成功轨迹,系统选择性地放大那些已被验证的决策信号;对于失败轨迹,则回退到标准策略优化,避免不可靠的归因影响训练。这种选择性的信用分配机制让代理能够从成功中学习更多,同时不被失败轨迹中的噪声误导。
评分标准(Rubric) 在评估领域指一套结构化的评分规则,用于将复杂输出分解为多个可评估维度。PMR中的评分标准并非人工设定,而是与记忆策略协同进化:通用层评分标准捕捉跨用户的共性失败模式(如事实错误、冗余信息),用户自适应层则通过少量用户交互数据学习个体偏好(如对隐私的敏感度、对细节的偏好)。两层评分标准共同为每个记忆操作生成细粒度反馈,再通过token级信用分配将反馈转化为策略梯度信号。这种设计避免了人工设计评分标准的偏差,同时保留了可解释性。
零推理开销的部署优势
PMR的一个显著优势是部署时无需评分标准或外部评判器。这意味着在实际推理过程中,系统不会产生额外开销。对于需要实时响应的个性化代理场景,这一特性至关重要。评分标准与记忆策略在训练阶段协同进化,并带有抗循环性保证,确保两者不会陷入相互强化的错误循环。
抗循环性保证(anti-circularity guarantee) 指在评分标准与策略协同进化过程中,防止两者相互强化错误而陷入自循环。例如,若评分标准总是给策略当前行为高分,策略则倾向于重复该行为,导致评估失去客观性。PMR通过引入独立验证信号(如基于真实用户反馈的校准)和正则化约束,确保评分标准的更新不依赖于策略的当前输出,从而维持评估的可靠性。这一机制对于无外部评判器的部署场景尤为重要,因为缺少独立监督时,循环性风险更高。
实验验证与效果
研究者在四个基准上进行了大量实验,结果显示PMR相比强记忆增强基线取得了持续的性能提升。这表明细粒度、用户特定的信用分配确实能够改善记忆更新策略的学习效果,验证了框架设计的有效性。
对个性化AI代理的启示
PMR的思路揭示了一个重要方向:记忆管理不应被视为全局统一的过程,而需要根据用户特征进行个性化调整。随着AI代理越来越多地承担长期陪伴、个性化助手等角色,如何让代理学会“对谁该记住什么”将成为关键能力。PMR提供的双层评估框架和token级信用分配机制,为这一方向提供了可借鉴的技术路径。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
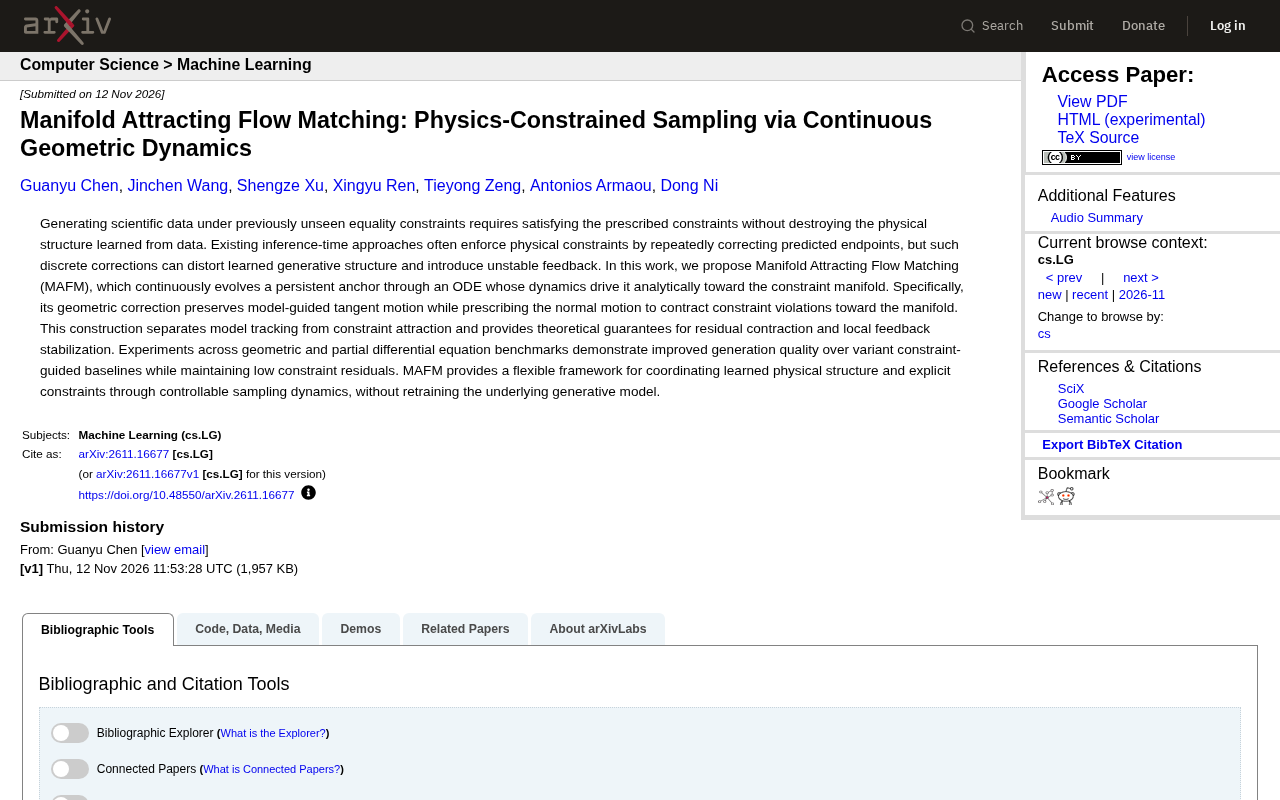
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。